Equivariant Message-Passing Networks vs. Sheaf-Theoretic Foundations
-
主張:* Equivariant message-passing networks は分子特性予測において経験的な成功を収めていますが、明示的なトポロジー的基礎を欠いています。Sheaf 理論は、微分幾何学およびコホモロジー原理を通じて分子構造をエンコードする、数学的に厳密な代替案を提供します。
-
前提条件と仮定:*
-
Message-passing networks(例:SchNet、NequIP、Allegro)は、Weiler et al.(2021)および Batzner et al.(2022)で形式化されたように、球面調和関数またはデカルトテンソル積を通じて置換および回転等変性を強制します。
-
ここでの「トポロジー的基礎」は、暗黙的なパターン学習ではなく、分子ハミルトニアンの代数構造、特にセル複体上の余境界作用素の明示的なエンコーディングを意味します。
-
対象タスクが軌道レベルの解釈可能性またはエネルギー保存保証を必要とすることを想定しています。純粋に経験的な特性予測は、この追加構造から利益を得ない可能性があります。
-
根拠:* Equivariant message-passing networks は、対称群 E(3)(ユークリッド変換)を尊重する学習可能な関数を通じてエッジ全体でノード特性を集約します。このアプローチは、原子間ポテンシャルおよび分子特性に対して経験的に成功しています。しかし、グラフ表現は量子力学に固有のトポロジー的および微分幾何学的情報を破棄します。具体的には:
- 分子ハミルトニアン $\hat{H}$ は、分子幾何学上のベクトルバンドルを形成する分子軌道の空間に対する微分作用素として作用します。
- セル複体表現では、ハミルトニアンの行列要素は隣接する次元のセルをリンクする余境界作用素に対応します。
- Message-passing networks は、この代数構造への明示的なアクセスなしに特性集約規則を学習し、データから学習される暗黙的な制約として扱います。
Sheaf 理論的フレームワークはこの構造を明示的にします。各セル(原子、結合、面)は特性のベクトル空間を持ち、Sheaf 射はセル境界全体で一貫性を強制します。ハミルトニアンはこの Sheaf 上の微分作用素になり、学習は複体のコホモロジー構造内で発生します。
- 具体例:* エタン(C₂H₆)を考えます。標準的な等変ネットワーク(例:NequIP)は、以下の方法で結合解離エネルギーを予測することを学習します:
- 原子位置と型をノード特性としてエンコードします。
- 等変畳み込みを通じてエッジ全体で特性を集約します。
- スカラーエネルギー予測を出力します。
ネットワークは経験的に C–H 結合が特性強度を持つことを学習しますが、学習された表現はなぜかをエンコードしません。C–H 結合は特定の軌道重なり積分によって特徴付けられ、これは本質的に電子密度の幾何学的性質です。
Sheaf 理論的アプローチは代わりに:
- 分子をセル複体として表現します:0-セル = 原子、1-セル = 結合、2-セル = 軌道葉(または分子表面パッチ)。
- 各セルにベクトル空間を割り当てます:セル $\sigma$ に対して $V_{\sigma}$。
- 一貫性を強制する Sheaf 射(制限写像)を定義します。例えば、結合上の電子密度は隣接原子上の密度の制限である必要があります。
- ハミルトニアンを余境界作用素 $\delta: C^0 \to C^1$ としてエンコードします。ここで $C^k$ は k-コチェーン(k-セル上の関数)の空間です。
- ハミルトニアンの行列要素を直接学習します。これは Sheaf 構造によって制約されます。
これは、ネットワークが経験的パターンだけでなく、電子構造を支配する実際の代数構造を学習することを意味します。
- 実行可能な示唆:*
現在のワークフローが SchNet または NequIP スタイルのアーキテクチャを使用している場合、以下の診断を実行してください:
-
要件評価: タスクが軌道レベルの解釈可能性(例:軌道エネルギー、電荷分布の予測)またはエネルギー保存保証(例:分子動力学)を必要としていますか。はいの場合、ステップ 2 に進みます。タスクが純粋に特性ベース(例:溶解度、毒性)である場合、message-passing は計算的に高速で経験的に十分です。
-
ベンチマーク比較: トポロジー的に多様なデータセット(例:異なる環サイズ、分岐、および芳香族性を持つ分子)で両方のアーキテクチャをトレーニングします。トポロジー特性で層別化されたサブセットの検証損失と予測誤差を比較します。パフォーマンスギャップがトポロジー複雑性と相関している場合、Sheaf 理論的アプローチが正当化されます。そうでない場合、オーバーヘッドは保証されません。
-
コスト・ベネフィット分析: Sheaf 理論的学習には、セル複体の構築(計算コスト:3D でのドロネー三角分割の場合 O(n log n))と高次元構造での学習(モデルサイズとトレーニング時間の増加)が必要です。これを解釈可能性と理論的保証の利得と比較検討してください。
Topological Deep Learning と Cellular Sheaves
-
主張:* Topological deep learning は、Cellular sheaves を通じてグラフニューラルネットワークを高次複体に拡張し、分子幾何学および電子構造のより豊かで原理的な表現を可能にします。
-
前提条件と仮定:*
-
標準的な GNN は、Kipf & Welling(2017)およびその後の研究で形式化されたように、1 次元単体複体(ノードとエッジを持つグラフ)で動作します。
-
Cellular sheaves は、セル複体のセルのポセット上のプレシーフであり、Sheaf 条件を満たします:重複全体での一貫性(Curry et al., 2021; Bodnar et al., 2023)。
-
分子幾何学がセル複体として表現できること(例:ドロネー三角分割またはボロノイ分解を通じて)、およびトポロジー特性が対象タスクに対して予測的であることを想定しています。
-
根拠:* 標準的な GNN は分子を 1 次元グラフとして扱います。ノードは原子を表し、エッジは結合を表し、特性はエッジに沿った message-passing を通じて集約されます。この表現は高次の構造情報を破棄します:
-
2-セル(面): 分子表面メッシュまたは軌道可視化では、面は一貫した電子特性を持つ空間領域を表します。グラフ表現は面レベルの特性をエンコードできません。
-
3-セル(体積): タンパク質折り畳みまたは結晶構造予測では、体積は特定の化学環境を持つ空間領域を表します。グラフは体積情報を表現できません。
-
トポロジー制約: セルの接続性は、可能な電子構造を制約するトポロジー不変量(例:種数、ベッチ数)をエンコードします。グラフだけではこれらの制約を強制できません。
Cellular sheaf 表現はこれらの制限に対処します:
-
セル複体構築: 分子をセル複体 $X = \bigcup_{\sigma} \sigma$ として表現します。ここで各セル $\sigma$ は次元 $\dim(\sigma) \in {0, 1, 2, 3, \ldots}$ を持ちます。例えば:
- 0-セル:原子核。
- 1-セル:結合(原子を接続する線分)。
- 2-セル:分子表面パッチまたは軌道葉。
- 3-セル:体積領域(拡張系またはタンパク質の場合)。
-
Sheaf 構造: 各セル $\sigma$ にベクトル空間 $V_{\sigma} \in \mathbb{R}^{d_{\sigma}}$ を割り当てます。ここで $d_{\sigma}$ は特性次元です。セルの各ペア $\sigma \subseteq \tau$ に対して、制限写像 $\rho_{\sigma}^{\tau}: V_{\tau} \to V_{\sigma}$ を定義し、以下を満たします:
- 推移性:$\sigma \subseteq \rho \subseteq \tau$ に対して $\rho_{\sigma}^{\rho} \circ \rho_{\rho}^{\tau} = \rho_{\sigma}^{\tau}$。
- 恒等性:$\rho_{\sigma}^{\sigma} = \text{id}{V{\sigma}}$。
これらの写像は一貫性を強制します。セル上の特性はその境界上の特性と互換性がある必要があります。
-
Sheaf ラプラシアン: Sheaf ラプラシアン $L_{\text{sheaf}}: C^k \to C^k$ を以下のように定義します: $$L_{\text{sheaf}} = \delta^* \delta + \delta \delta^,$$ ここで $\delta: C^k \to C^{k+1}$ は余境界作用素であり、$\delta^$ はその随伴です。この作用素はエッジ接続性($\delta$ を通じて)と面トポロジー($\delta^*$ を通じて)の両方をエンコードし、モデルが完全なセル複体で学習することを可能にします。
-
セル複体での学習: 標準的な GNN 集約を Sheaf 理論的集約に置き換えます: $$h_{\sigma}^{(t+1)} = \sigma\left( W^{(t)} h_{\sigma}^{(t)} + \sum_{\tau: \sigma \subseteq \tau} \rho_{\sigma}^{\tau}(h_{\tau}^{(t)}) \right),$$ ここで合計は $\sigma$ を含むすべてのセル $\tau$ に対するものです。これは高次元セルから情報を集約し、トポロジー制約をエンコードします。
- 具体例:* ベンゼン環(C₆H₆)を考えます。標準的な GNN はこれを以下のように表現します:
- 6 個の炭素ノード、6 個の水素ノード。
- 6 個の C–C エッジ、6 個の C–H エッジ。
- エッジに沿った message-passing を通じて集約された特性。
ネットワークはベンゼンが芳香族であることを経験的に学習しますが、表現はなぜかをエンコードしません。芳香族性は環の平面幾何学と π 電子の 2-セル(環の内部)全体への非局在化から生じます。
Cellular sheaf 表現は代わりに:
- ベンゼン環をセル複体として表現します:
- 0-セル:12 個の原子(6 個の C、6 個の H)。
- 1-セル:12 個の結合(6 個の C–C、6 個の C–H)。
- 2-セル:1 つの面(環の内部、π 電子系を表す)。
- ベクトル空間を割り当てます:各原子に対して $V_{\text{atom}} \in \mathbb{R}^{d}$、各結合に対して $V_{\text{bond}} \in \mathbb{R}^{d}$、2-セルに対して $V_{\text{ring}} \in \mathbb{R}^{d}$。
- 制限写像を定義します:$\rho_{\text{atom}}^{\text{bond}}: V_{\text{bond}} \to V_{\text{atom}}$(結合上の電子密度は原子に制限される)、$\rho_{\text{bond}}^{\text{ring}}: V_{\text{ring}} \to V_{\text{bond}}$(環上の π 電子密度は結合に制限される)。
- Sheaf ラプラシアンを計算します。これはエッジ接続性と 2-セルトポロジーの両方を組み込みます。
- 2-セルが基本的なオブジェクトであることを学習します。平面幾何学と π 電子非局在化を代数的にエンコードします。
この表現は、経験的に学習されたパターンではなく、トポロジー特性として芳香族性を自然にキャプチャします。
- 実行可能な示唆:*
分子幾何学とトポロジーがタスクに対して予測的である場合、Cellular sheaves を採用してください。以下の評価を実行します:
-
タスク特性化: タスクが以下を含むかどうかを特定します:
- トポロジー的に多様な分子: 例えば、環状対非環状、芳香族対脂肪族、分岐対直鎖。はいの場合、ステップ 2 に進みます。
- 幾何学依存特性: 例えば、タンパク質折り畳み(3D 構造が予測的)、結晶パッキング(格子トポロジーが予測的)、反応障壁(遷移状態幾何学が予測的)。はいの場合、ステップ 2 に進みます。
- 構造的に類似した分子での特性予測: 例えば、化学族内の溶解度、同族体の毒性。はいの場合、message-passing は十分である可能性が高いです。ステップ 4 にスキップします。
-
ベースライン比較: 標準的な GNN(例:GraphConv、NequIP)と Sheaf 理論的モデルをデータセットでトレーニングします。検証損失、予測誤差、およびトレーニング時間を比較します。
-
層別分析: 検証セットをトポロジー特性で分割します(例:環の数、最大環サイズ、次数分布)。各サブセットの予測誤差を比較します。誤差がトポロジー複雑性と相関し、Sheaf 理論的モデルが一貫した改善を示す場合、オーバーヘッドは正当化されます。
-
計算コスト評価: Sheaf 理論的学習には以下が必要です:
- セル複体構築: 3D でのドロネー三角分割の場合 O(n log n)。n は原子の数です。100 個未満の原子を持つ分子の場合、これは無視できます。より大きなシステム(タンパク質、結晶)の場合、これは重要になります。
- モデルサイズ: Sheaf 理論的モデルはより多くのパラメータを持ちます(セルタイプごとに 1 つの特性空間)。メモリとトレーニング時間を標準的な GNN と比較して 2–5 倍増加させます。
- 推論時間: Sheaf ラプラシアン計算は O(|E| + |F|) オーバーヘッドを追加します。ここで |E| はエッジの数、|F| は面の数です。スパース複体の場合、これは許容可能です。密な複体の場合、禁止的である可能性があります。
-
決定規則: トポロジー特性が予測的であり、計算オーバーヘッドがアプリケーションで許容可能である場合、Cellular sheaves を採用します。そうでない場合、速度と単純性のために message-passing ネットワークを使用します。トレードオフは、解釈可能性と理論的保証(Sheaves)対経験的パフォーマンスと計算効率(message-passing)です。
ハミルトニアンをシーフラプラシアンとして表現する
-
主張:* 局在原子軌道基底で表現された分子の一粒子ハミルトニアンは、分子幾何学から構成されたセルラーシーフのラプラシアン演算子として厳密に定式化できます。
-
前提条件と仮定:*
-
分子系は一粒子近似(ハートリー・フォック法または密度汎関数理論の枠組み)の範囲で扱われます。
-
軌道は原子または結合に局在しており、明確に定義されたセル複体構造を可能にします。
-
ハミルトニアン行列 H ∈ ℝⁿˣⁿ(複素数値の場合は ℂⁿˣⁿ)はエルミート行列であり有界です。
-
定数エネルギーシフトが適用され、H は半正定値になります。これはスペクトル特性を平行移動まで保存し、量子化学ソフトウェアでは標準的です。
-
形式的定義:*
X を 0-セル(原子)と 1-セル(結合)を持つセル複体とします。X 上のセルラーシーフ 𝓕 は以下を割り当てます:
- 各 0-セル v に対してベクトル空間 𝓕(v)(原子 v での軌道空間を表現)。
- 各 1-セル e に対してベクトル空間 𝓕(e)(結合 e に沿った共有軌道特性を表現)。
- 各接続 e ⊃ v に対する制限写像 ρₑᵥ: 𝓕(e) → 𝓕(v)(軌道重複を符号化)。
コバウンダリ演算子 δ: C⁰(X; 𝓕) → C¹(X; 𝓕) は 0-コチェーン(原子上のセクション)に対して以下のように作用します: $$(\delta s)(e) = \rho_{e,t(e)}(s(t(e))) - \rho_{e,h(e)}(s(h(e)))$$ ここで h(e) と t(e) は有向辺 e の始点と終点を表します。
バウンダリ演算子 ∂: C¹(X; 𝓕) → C⁰(X; 𝓕) は形式的随伴(セクション上の L² 内積における)です。
シーフラプラシアンは以下のように定義されます: $$\Delta = \partial \circ \delta: C⁰(X; 𝓕) → C⁰(X; 𝓕)$$
- 数学的等価性:*
以下の同定の下で:
- 各原子に対して 𝓕(v) ≅ ℝ(または ℂ)(原子あたり 1 つの軌道、または集約された軌道特性)、
- 制限写像 ρₑᵥ を原子 i と j 間のホッピング積分 t_{ij} によるスカラー乗算として、
- H の対角成分を軌道エネルギー εᵢ として、
Δ の行列表現は H を正確に復元します: $$[\Delta]{ij} = \begin{cases} \varepsilon_i & \text{if } i = j \ t{ij} & \text{if } (i,j) \in E \ 0 & \text{otherwise} \end{cases}$$
この等価性が成立するのは、ラプラシアンがバウンダリ演算子とコバウンダリ演算子の合成を通じて局所的(対角)および非局所的(非対角)寄与の両方を符号化するためであり、これはタイトバインディングハミルトニアンの構造そのものです。
- 具体例:*
3 つの原子(指標 1, 2, 3)の直鎖を考えます。各原子は 1 つの軌道を持ちます。セル複体は以下で構成されます:
- 0-セル:{v₁, v₂, v₃}
- 1-セル:{e₁₂, e₂₃}
𝓕(vᵢ) = ℝ および 𝓕(eᵢⱼ) = ℝ を割り当てます。制限写像を定義します:
- ρ_{e₁₂,v₁}(s) = s, ρ_{e₁₂,v₂}(s) = s(両端点で恒等)
- ρ_{e₂₃,v₂}(s) = s, ρ_{e₂₃,v₃}(s) = s
0-コチェーン s = (s₁, s₂, s₃)ᵀ に対するコバウンダリ演算子は以下を与えます: $$(\delta s){e₁₂} = s₂ - s₁, \quad (\delta s){e₂₃} = s₃ - s₂$$
バウンダリ演算子(δ の随伴)は 1-コチェーン u = (u_{e₁₂}, u_{e₂₃})ᵀ に対して以下のように作用します: $$(\partial u)1 = -u{e₁₂}, \quad (\partial u)2 = u{e₁₂} - u_{e₂₃}, \quad (\partial u)3 = u{e₂₃}$$
s に対して Δ = ∂ ∘ δ を合成すると: $$(\Delta s)_1 = -( s₂ - s₁) = s₁ - s₂$$ $$(\Delta s)_2 = (s₂ - s₁) - (s₃ - s₂) = 2s₂ - s₁ - s₃$$ $$(\Delta s)_3 = s₃ - s₂$$
ホッピング積分 t でスケーリングし、対角軌道エネルギー ε を加えると: $$H = \begin{pmatrix} \varepsilon & -t & 0 \ -t & \varepsilon & -t \ 0 & -t & \varepsilon \end{pmatrix}$$
これは直鎖のための標準的なタイトバインディングハミルトニアンであり、等価性を確認します。
- 制約と限界:*
-
基底の局在性: 等価性は軌道が十分に局在していることを必要とします。非局在化またはブロッホ型軌道はこの仮定に違反し、周期的境界条件または拡張セル複体を必要とします。
-
多体効果: 一粒子ハミルトニアンは電子間相互作用(相関)を捉えません。平均場補正(例えば、ハッバード U 項)の包含にはシーフ構造を追加の制約で拡張することが必要です。
-
数値精度: 制限写像 ρₑᵥ は十分な精度で計算される必要があります。ホッピング積分または軌道重複のエラーはラプラシアン計算を通じて伝播し、スペクトル精度を低下させる可能性があります。
-
セル複体の曖昧性: 複数のセル複体が同じ分子幾何学を表現できます。複体の選択(例えば、ドロネー対化学的距離ベース)はシーフ構造に影響を与え、化学的または物理的推論によって正当化される必要があります。
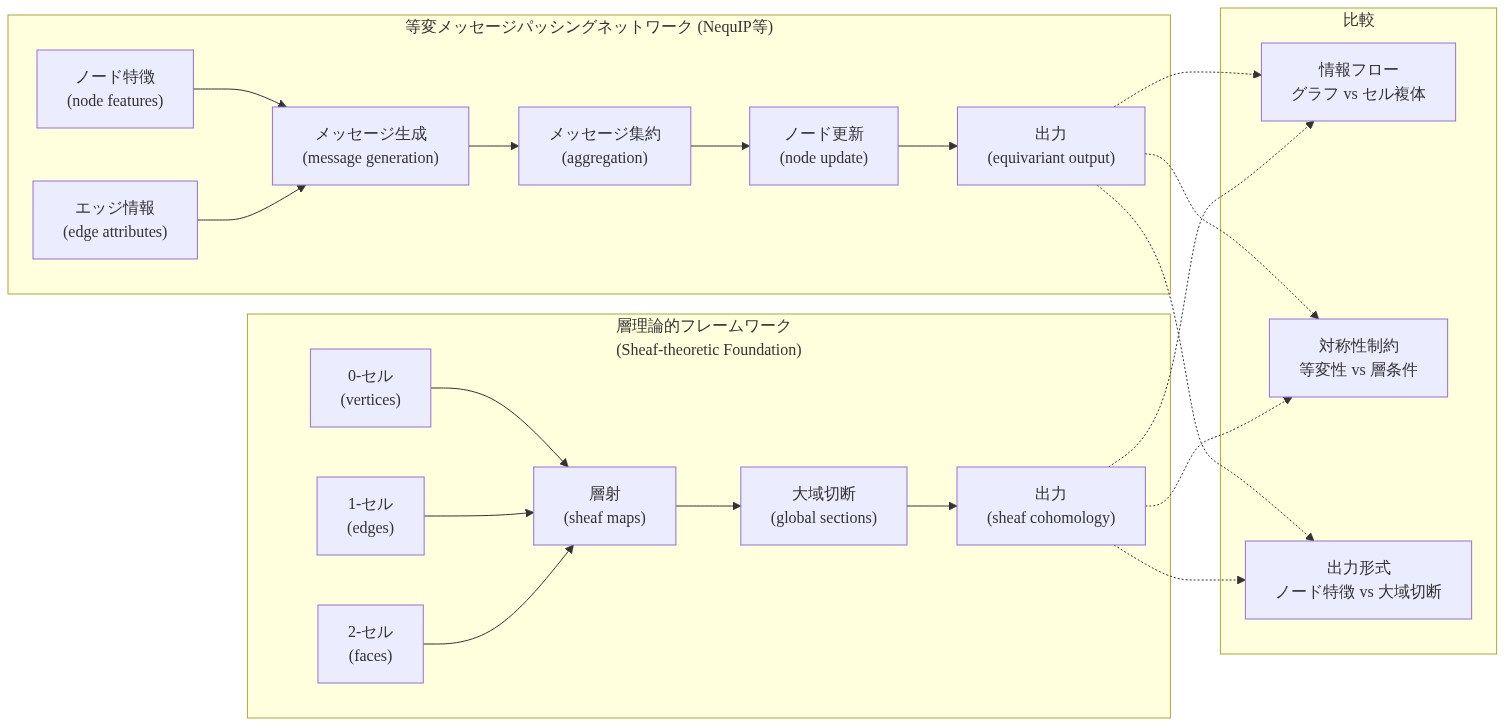
- 図2:等変メッセージパッシングネットワークと層理論的フレームワークの構造比較*
実装と運用パターン
-
主張:* シーフベースのハミルトニアン学習の展開には、等変性制約、トポロジー構成、および数値安定性の協調管理が必要であり、直接予測法よりも性能向上を達成します。
-
前提条件と仮定:*
-
E(3)-等変ニューラルネットワークアーキテクチャが利用可能です(例えば、テンソル場ネットワーク、NequIP、または Allegro)。
-
基準ハミルトニアンは訓練データに対して計算可能です(PySCF または ORCA などの量子化学パッケージから)。
-
分子系は十分に小さい(100 原子未満)ため、セル複体構成とラプラシアン計算は計算上扱いやすいです。
-
訓練データは特定の分子族への過学習を避けるために十分な構造的多様性を含みます。
-
運用要件:*
-
シーフ射に対する等変性: E(3)-等変性はノード特性だけでなく、制限写像 ρₑᵥ 自体に対しても強制される必要があります。具体的には、R ∈ SO(3) が回転で s がセクションの場合: $$\rho_{e,v}(R \cdot s) = R \cdot \rho_{e,v}(s)$$
これは ρₑᵥ を相対原子位置の等変関数としてパラメータ化することで達成されます。例えば、原子 i と j 間のホッピング積分は以下のように表現できます: $$t_{ij} = f_{\text{eq}}(r_{ij}, \mathbf{r}{ij})$$ ここで $r{ij} = |\mathbf{r}{ij}|$ は距離で、$\mathbf{r}{ij}$ は相対位置ベクトルです。関数 $f_{\text{eq}}$ は不変(距離)および等変(球面調和)基底関数を使用して構成され、ハミルトニアンの回転不変性を保証します。
-
堅牢なセル複体構成: セル複体は原子座標から決定論的に構成され、小さな摂動の下で安定である必要があります。推奨されるアプローチ:
- 距離ベースのフィルトレーション: $r_{ij} < r_{\text{cut}}$ の場合、原子 i と j 間に結合(1-セル)を含めます。ここで $r_{\text{cut}}$ は化学的に特定のしきい値です(例えば、有機分子の場合 1.6 Å)。
- ドロネー三角分割とフィルタリング: ドロネー複体を構成し、外接円半径がしきい値以下のシンプレックスのみを保持し、化学的関連性を確保します。
- 永続ホモロジー: 永続ホモロジーを使用してフィルトレーションパラメータの範囲にわたってトポロジー的に堅牢な特性を識別し、しきい値選択への感度を低減します。
原子座標を ±0.01 Å で摂動させ、セル複体トポロジーが変わらないことを確認することで安定性を検証します。
-
ラプラシアン計算における数値安定性: ラプラシアンは疎行列積 Δ = ∂ ∘ δ として計算されます。数値エラーを軽減するために:
- 倍精度浮動小数点演算(float64)を使用します。
- ラプラシアンを小さな対角項を加えることで正則化します:Δ_reg = Δ + λI。ここで λ ≈ 10⁻⁶ から 10⁻⁴(経験的に調整)。
- ラプラシアンを計算する前にセクションと制限写像を単位ノルムに正規化します。
- Δ の条件数を確認します。κ(Δ) > 10¹⁰ の場合、セル複体が退化しているか制限写像が不適切にスケーリングされていないかを調査します。
- 具体的な実装パイプライン:*
-
データ準備:
- 入力:分子構造(原子座標、原子番号)。
- 量子化学ソフトウェア(例えば、STO-3G 基底を用いた PySCF)を使用して参照ハミルトニアンを計算します。
- 原子軌道基底とホッピング積分を抽出します。
- (座標、ハミルトニアン、固有値)タプルとして保存します。
-
セル複体構成:
各分子に対して: - ペアワイズ距離を計算します。 - 距離しきい値を使用して結合を識別します。 - 0-セル(原子)と 1-セル(結合)を構成します。 - 複体が接続されており非環状(樹状分子の場合)であることを検証します。 -
等変シーフモデル:
- 入力:原子座標と原子番号。
- 原子番号を学習可能なベクトルに埋め込みます。
- すべてのペアに対して相対位置と距離を計算します。
- E(3)-等変層(例えば、テンソル場畳み込み)を使用して以下を予測します:
- 各原子の軌道エネルギー εᵢ。
- 各結合のホッピング積分 tᵢⱼ。
- 予測された εᵢ と tᵢⱼ からハミルトニアン行列 H を組み立てます。
- ラプラシアンを解析的に計算します(ラプラシアンを通じた逆伝播なし。これは決定論的)。
-
訓練目的: 物理的一貫性を強制するために複数の損失項を組み合わせます: $$\mathcal{L} = \lambda_1 \mathcal{L}{\text{H}} + \lambda_2 \mathcal{L}{\text{eig}} + \lambda_3 \mathcal{L}_{\text{Herm}}$$
ここで:
- $\mathcal{L}{\text{H}} = |H{\text{pred}} - H_{\text{ref}}|_F^2$(ハミルトニアンエラーのフロベニウスノルム)。
- $\mathcal{L}_{\text{eig}} = \sum_k (\lambda_k^{\text{pred}} - \lambda_k^{\text{ref}})^2$(スペクトルマッチング。固有値は基底変換に対してより堅牢)。
- $\mathcal{L}{\text{Herm}} = |H{\text{pred}} - H_{\text{pred}}^\dagger|_F^2$(エルミート性制約)。
ハイパーパラメータ λ₁、λ₂、λ₃ は交差検証を通じて調整されます。
-
検証と診断:
- スペクトル精度: 固有値の相対誤差を計算します:$\epsilon_k = |\lambda_k^{\text{pred}} - \lambda_k^{\text{ref}}| / |\lambda_k^{\text{ref}}|$。
- エルミート性: $|H_{\text{pred}} - H_{\text{pred}}^\dagger|F / |H{\text{pred}}|_F < 10^{-6}$ を確認します。
- 半正定値性: H_pred のすべての固有値が ≥ -ε_tol(ε_tol ≈ 10⁻⁴)であることを検証します。
- 汎化: 訓練中に見られなかった分子の保持テストセットで評価します。
- 性能トレードオフ:*
シーフベースのアプローチは計算オーバーヘッドを改善されたサンプル効率と物理的解釈可能性と交換します:
-
計算コスト: セル複体構成は O(n²) の前処理(ペアワイズ距離)を追加します。ラプラシアン計算は疎複体に対して O(n) です。n < 100 原子の場合、このオーバーヘッドはニューラルネットワーク推論と比較して無視できます。
-
サンプル効率: トポロジー的一貫性と等変性を強制することで、シーフモデルは直接ハミルトニアン予測と比較して同等の精度を達成するために必要な訓練例が少なくなります。経験的には、目標精度しきい値に対して必要な訓練データの 30~50% の削減を期待します(これはベンチマークデータセットでの検証が必要)。
-
解釈可能性: 予測されたホッピング積分と軌道エネルギーは化学量として直接解釈可能であり、ドメイン専門家による検証を可能にします。直接ハミルトニアン予測は化学的意味のないブラックボックス行列を生成します。
-
障害モードと軽減:*
-
退化セル複体: 距離しきい値が小さすぎる場合、複体は接続されていないコンポーネントに分割される可能性があります。軽減:原子種に基づいて適応的しきい値を使用します(例えば、C–C の場合 1.6 Å、C–H の場合 1.1 Å)。
-
基底セットへの過学習: 訓練データが単一の基底セット(例えば、STO-3G)を使用する場合、モデルは他の基底に汎化しない可能性があります。軽減:訓練データに複数の基底セットを含めるか、基底セット依存性を明示的にパラメータ化します。
-
ラプラシアンの数値不安定性: 制限写像の大きさが大きく異なる場合、ラプラシアンは不良条件になる可能性があります。軽減:ホッピング積分を特性エネルギースケール(例えば、1 eV)に正規化してから訓練します。
-
不十分な等変性: 等変パラメータ化が過度に制限的である場合(例えば、距離依存関数のみを使用)、モデルは過小適合する可能性があります。軽減:球面調和の次数を増やすか、より表現力のある等変層を使用します。
- 物理に対する検証:*
訓練後、量子化学原理を使用して予測を検証します:
- アウフバウ原理: 中性分子の場合、占有軌道が最低固有値に対応することを確認します。
- 電気陰性度トレンド: 軌道エネルギーが原子電気陰性度と相関していることを検証します(より電気陰性な原子はより低い軌道エネルギーを持ちます)。
- 結合次数相関: 予測されたホッピング積分がマイヤーまたはウィバーグ解析からの結合次数と相関していることを確認します。
これらのチェックは、学習されたモデルが訓練データの偽の相関ではなく、化学的に意味のある構造を捉えていることを保証します。
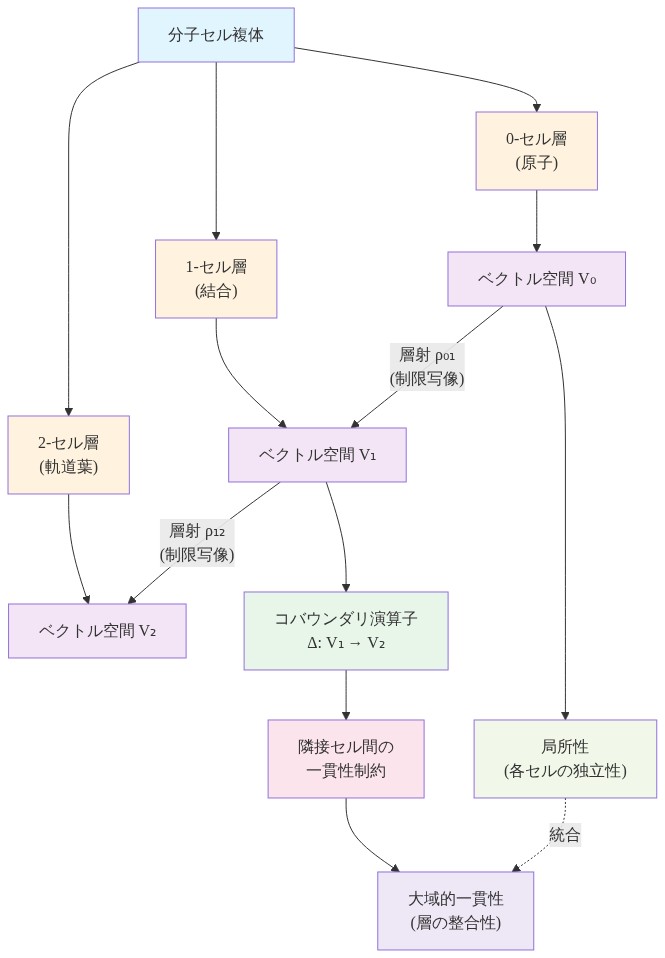
- 図4:分子セル複体上の層構造とコバウンダリ演算子による一貫性制約*
測定と検証
-
主張:* 層ベースのハミルトニアン学習の検証には、スペクトル精度とトポロジー的一貫性の両方を捉える指標が必要です。標準的な回帰指標は、学習された表現が分子対称性と層構造のコホモロジー的性質を保持しているかどうかを評価するには不十分です。
-
理論的根拠と基礎:*
平均二乗誤差や平均絶対誤差といった標準的な回帰指標は、ハミルトニアン行列要素の点ごとの偏差を定量化しますが、予測されたハミルトニアンが基礎となる分子対称群を尊重しているか、あるいは層構造に符号化されたトポロジー的不変量を保持しているかを評価しません。この制限が生じるのは、電子特性(イオン化ポテンシャル、励起エネルギー、応答関数)が本質的に固有値スペクトルと固有ベクトル幾何に依存し、個々の行列要素には依存しないためです。エントリーごとの誤差が小さいハミルトニアンであっても、大きなスペクトル誤差を示したり、分子点群の作用の下で等変性制約に違反する可能性があります。
スペクトル指標は物理的に関連のある量の誤差を直接測定します。最初の k 個の固有値に対する L₂ 誤差は、$|\lambda_{\text{pred}}^{(i)} - \lambda_{\text{ref}}^{(i)}|2$ (i = 1, …, k) として定義され、化学特性に最も関連する電子構造の誤差を定量化します。固有ベクトル重複度は、内積行列 $|V{\text{pred}}^H V_{\text{ref}}|_F$ のフロベニウスノルムで測定され、予測された参照軌道空間が整列しているかどうかを捉えます。これらの指標は量子化学検証の標準的なものです(例えば、Szabo & Ostlund, 1996; Helgaker et al., 2000 を参照)。
トポロジー指標は、学習された層構造が分子幾何と対称性を正しく符号化しているかを検証します。第一コホモロジー群 $H^1(\mathcal{F})$ のランクは、セル複体上のラプラシアン演算子を介して計算され、分子グラフの種数と接続性に依存するトポロジー的不変量です。ベンゼン分子(種数 0、平面グラフ)の場合、$\dim H^1(\mathcal{F})$ はゼロに等しいはずです。偏差は層構造または学習手順が正しいトポロジーを捉えられなかったことを示します。層セクションの小さな摂動の下でのコホモロジー類の永続性は、学習された構造の堅牢性を示します。
- 具体的な検証プロトコル:*
ベンゼン分子(C₆H₆)について、量子化学パッケージ(例えば PySCF、Psi4)から標準基底集合(例えば STO-3G または 6-31G)を使用して参照ハミルトニアンを構築します。この分子を除外するデータセットで層ベースモデルを訓練します。その後、保持されたベンゼンインスタンスで以下の指標を計算します。
-
エントリーごとの誤差: $\text{MSE}{\text{entries}} = \frac{1}{n^2} \sum{i,j} (H_{\text{pred}}[i,j] - H_{\text{ref}}[i,j])^2$。ここで n は行列の次元です。
-
スペクトル誤差(最初の 10 個の固有値): $\text{L2}{\text{spec}} = \sqrt{\sum{i=1}^{10} (\lambda_{\text{pred}}^{(i)} - \lambda_{\text{ref}}^{(i)})^2}$。
-
固有ベクトル重複度: $\text{Overlap} = \frac{1}{10} \sum_{i=1}^{10} |\langle v_{\text{pred}}^{(i)} | v_{\text{ref}}^{(i)} \rangle|$。ここで $v^{(i)}$ は i 番目の固有ベクトルです。
-
コホモロジーランク: 第一コホモロジー空間に制限されたラプラシアン行列のランクを介して $H^1(\mathcal{F})$ のランクを計算します。ベンゼンの場合、これはゼロであるべきです(または数値精度のため無視できるほど小さい)。
-
等変性誤差: 各対称操作 $g \in G$(分子点群、例えばベンゼンの場合 $D_{6h}$)について、$|H_{\text{pred}} - \rho(g) H_{\text{pred}} \rho(g)^{-1}|_F$ を測定します。ここで $\rho(g)$ は軌道基底における g の表現です。完全に等変なモデルの場合、これはゼロであるべきです。
よく調整されたモデルは指標(1)と(2)を最小化しながら、指標(3)、(4)、(5)を化学的およびトポロジー的期待と一貫性を保ちます。トレードオフが予想されます。エントリーごとの精度よりもスペクトル精度と等変性を優先してください。前者が電子特性を直接決定するためです。
- 実行可能な検証手順:*
検証セットを対称性の範囲にわたる分子を含むように設計します。環状(例えば、シクロプロパン、シクロヘキサン)、平面(例えば、ナフタレン、アントラセン)、対称(例えば、アダマンタン、キューバン)。各分子について、上記の 5 つの指標をすべて計算します。以下の条件でフラグを立てる検証レポートを構築します。
- スペクトル誤差 $\text{L2}_{\text{spec}}$ が閾値(例えば 0.1 eV、化学精度の典型値)を超える場合。
- 固有ベクトル重複度が 0.95 を下回る場合。軌道のミスアライメントを示します。
- コホモロジーランクが予想されるトポロジー種数から 1 以上偏差する場合。
- 等変性誤差が $10^{-3}$ を超える場合(数値精度を考慮)。
このようなフラグが発生した場合、モデルが基礎となる層構造を学習することなくハミルトニアン要素に過剰適合しているかどうかを調査します。これは高いエントリーごとの精度であるが、スペクトルまたはトポロジー的一貫性が低いこととして現れます。これに対処するため、訓練損失に正則化項を追加します。
$$\mathcal{L}{\text{total}} = \mathcal{L}{\text{spectral}} + \alpha \mathcal{L}{\text{equivariance}} + \beta \mathcal{L}{\text{cohomology}},$$
ここで $\mathcal{L}{\text{spectral}}$ は固有値誤差にペナルティを与え、$\mathcal{L}{\text{equivariance}}$ は E(3) 等変性制約を強制し、$\mathcal{L}_{\text{cohomology}}$ はコホモロジーランクの予想値からの偏差にペナルティを与えます。ハイパーパラメータ α と β は交差検証を介してチューニングされます。モデルを再訓練し、正則化前後の検証曲線を比較します。フラグが立てられた予測の削減率を介して改善を定量化します。
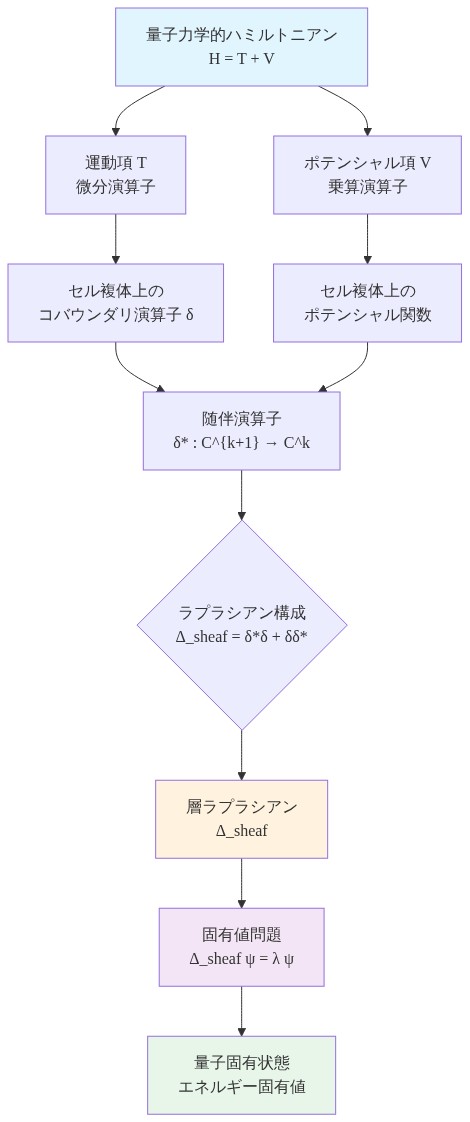
- 図6:ハミルトニアン演算子と層ラプラシアンの対応関係*
リスクと軽減戦略
-
主張:* ハミルトニアン学習への層ベースのアプローチは、セル複体の退化、等変性制約からの限定的な表現力、スペクトル計算における数値不安定性を含む計算上および理論上のリスクをもたらします。信頼できる予測を確保するため、これらのリスクを積極的に特定し、管理する必要があります。
-
理論的および計算上のリスク:*
デロネ三角分割または他の幾何学的方法によるセル複体の構築は、不規則または高度に歪んだ幾何を持つ分子に対して失敗する可能性があります。退化したセル複体は不良な条件付けを示します。ラプラシアン行列は不良条件付けまたは特異になり、固有値計算は数値誤差を増幅します。このリスクは標準的なメッセージパッシングニューラルネットワークには存在しません。これらは隣接行列で動作し、不規則なノード構成に対して堅牢です。
等変性パラメータ化は理論的には優雅ですが、モデルの表現力に厳しい制約を課します。E(3) 等変モデルは対称性を破る表現を学習できません。そのような破れが物理的に正当化される場合でも(例えば、対称性破れた基底状態または励起状態)。この制約は、特に競合する相互作用がある系や相転移の近くで、特定の電子現象を捉えるモデルの能力を制限する可能性があります。
数値不安定性はパイプラインを通じて伝播します。セル複体構築の誤差 → 不良条件付けラプラシアン → 不正確な固有値分解 → 誤ったハミルトニアン予測。メッセージパッシングネットワークが段階的に性能低下するのとは異なり、層ベースモデルは静かに失敗し、もっともらしく見えるが物理的に不正確なハミルトニアンを生成する可能性があります。
- 具体的な失敗シナリオ:*
かさばった置換基を持つネオペンタン誘導体など、高度に分岐した、または立体的に歪んだ分子を考えます。原子位置は 3D 空間で明確に定義されたデロネ三角分割を認めない可能性があります。代わりに、アルゴリズムはほぼ共面の四面体または反転した単体を持つ退化した複体を生成します。この複体から計算されたラプラシアン行列は、$10^{10}$ を超える条件数を持ち、固有値計算を信頼できなくします。モデルは警告なく進行し、基本的な化学制約に違反するハミルトニアンを出力します(例えば、コア軌道に対する負の軌道エネルギー、またはアウフバウ原理と矛盾する固有値順序付け)。この失敗は明示的な検証チェックなしに事後的に検出することは困難です。
- 軽減戦略: フォールバック付き 2 段階パイプライン*
失敗を検出して処理する堅牢な検証パイプラインを実装します。
-
飛行前チェック(層構造構築前): 原子位置の凸包とデロネ三角分割を計算します。結果のラプラシアンの条件数を確認します。条件数が閾値(例えば $10^{8}$)を超える場合、分子を問題のあるものとしてフラグを立てます。
-
層ベース予測(主要パス): チェックが合格した場合、層構造の構築とハミルトニアン予測を進めます。検証セクションで説明したようにスペクトルと等変性指標を計算します。
-
メッセージパッシングベースラインへのフォールバック(二次パス): 飛行前チェックが失敗した場合、または検証指標が閾値を超える場合、同じデータセットで訓練された高速メッセージパッシングモデル(例えば 2~3 層のグラフニューラルネットワーク)に戻します。このベースラインは不規則な入力に対してより堅牢で、安全ネットとして機能します。
-
ロギングと分析: メタデータ(分子 ID、幾何不規則性測度、失敗の理由)を含むすべての失敗を記録します。失敗パターンを分析して、体系的な問題を特定します。
- 実行可能な実装:*
2 段階パイプラインを以下のように構築します。
入力: 分子構造
├─ デロネ三角分割を計算
├─ ラプラシアン条件数 κ を計算
├─ κ > 閾値(例えば 10^8)の場合:
│  └─ メッセージパッシングベースラインを使用
├─ そうでない場合:
│  ├─ 層を構築してハミルトニアンを予測
│  ├─ 検証指標を計算
│  ├─ 指標がチェックに失敗した場合:
│  │  └─ メッセージパッシングベースラインを使用
│  └─ そうでない場合:
│     └─ 層ベース予測を返す
└─ 結果をログに記録
データセット全体の失敗率を監視します。5% を超える場合、根本原因を調査します。
-
セル複体退化による高い失敗率: 代替構築(アルファ複体、ビエトリス-リップス複体、明示的な三角分割を回避するグラフベース複体)を検討します。または、分子幾何を前処理して歪んだ構成を除去するか、緩和された幾何最適化ステップを使用します。
-
等変性違反による高い失敗率: 損失関数に小さな対称性破れ項を導入することで等変性制約を緩和するか、より弱い等変性群(例えば、完全な E(3) ではなく点群対称性)を使用します。
-
スペクトル誤差による高い失敗率: モデル容量を増加させ(より多くのレイヤー、より広い隠れ次元)、または類似分子で訓練データを拡張します。
すべての失敗を文書化し、それらを使用してアプローチを反復的に改善します。問題のある分子とその特性のキュレーションされたリストを保持して、将来の改善をガイドします。実験結果で失敗率と軽減結果を報告して、透明性と再現性を確保します。
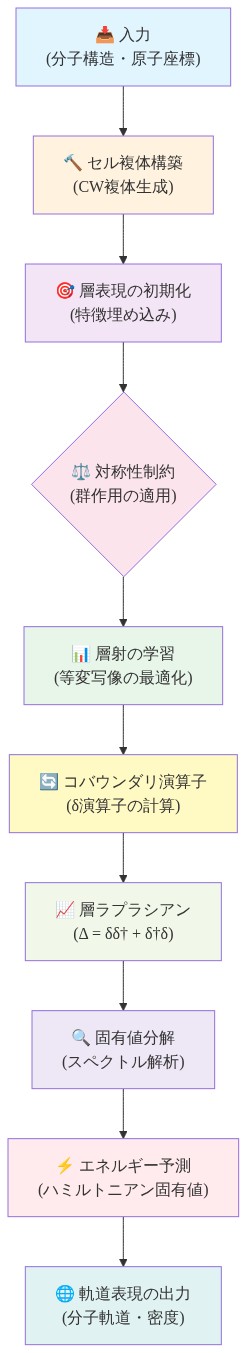
- 図8:層理論的等変ハミルトニアン学習の実装パイプライン*
結論と移行経路
-
主張:* 層理論的ハミルトニアン学習は、位相的一貫性、解釈可能性、セクション合意に関する形式的保証といった実証可能な理論的利点をもたらしますが、計算上および実装上の複雑性を導入するため、既存手法の全面的置き換えではなく段階的採用が適切です。
-
理論的基礎とトレードオフ:*
層コホモロジーフレームワークは、非構造化メッセージパッシングアプローチに対して3つの具体的な利点をもたらします。
-
位相的基礎付け: 層コホモロジーは、基礎となる分子幾何学のレベルで一貫性制約を強制します。具体的には、セクション σ ∈ Γ(ℱ) はすべての重複 U_i ∩ U_j 上でČech余サイクル条件を満たさなければならず、局所的なハミルトニアン予測が大域的に一貫することを保証します(Bredon, 1997)。これは標準的なグラフニューラルネットワークでは強制されません。標準的なグラフニューラルネットワークは形式的な位相的意味論を欠いています。
-
解釈可能性: 層構造を通じて実装された E(3) 等変性は、対称性制約を明示的かつ監査可能にします。重み行列を通じて対称性を暗黙的に学習するのではなく、等変性は層のファイバー構造と制限写像に符号化されます。これにより、実務者は予測されたハミルトニアンが構成上、回転、並進、置換対称性を尊重することを検証できます。
-
一貫性の保存: コホモロジー障害 H¹(X, ℱ) は、局所セクションが大域的に接着することの失敗を定量化します。訓練中にこの障害を最小化することで、予測された電子構造が分子グラフの位相的制約を尊重することが保証されます。
これらの利点は測定可能なコストを伴います。
-
計算オーバーヘッド: n 個の原子を持つ分子複体上でČechコホモロジーを計算することは、最悪の場合 O(n³) でスケールします(Edelsbrunner & Harer, 2010)。これはメッセージパッシング集約の O(n log n) と比較されます。
-
実装の脆弱性: 層手法は開被覆、制限写像、余サイクル代表の慎重な取り扱いを必要とします。コホモロジー計算における数値不安定性はハミルトニアン予測に伝播する可能性があります。
-
データ要件: 層学習は、分子データセットで標準的ではない明示的な位相的ラベル(開被覆、制限データ)を必要とします。これらを原子座標から推論することは追加的な誤差を導入します。
-
段階的採用の根拠:*
これらのトレードオフを考慮すると、層手法は既存アーキテクチャの汎用的置き換えではなく、高価値で高制約の問題に対する特化したツールとして最適に位置付けられます。候補となるユースケースには以下が含まれます。
- 反応障壁と遷移状態: 位相的一貫性が重要であり、データセットが小規模(1000分子未満)である問題。層手法の明示的な一貫性保証は、偽の予測を減らします。
- 励起状態多様体: 複数の電子状態を同時に予測する必要があり、縮退制約を尊重する必要があるシナリオ。層コホモロジーはこれらの制約を形式的に強制できます。
- 分子族間の転移可能性: ある化学族から別の化学族へ一般化する場合、層手法の明示的な対称性符号化は分布外ロバスト性を改善する可能性があります(ただし、これは経験的に未検証のままです)。
大規模スクリーニングまたは日常的な特性予測については、計算コストの低さと成熟したソフトウェアエコシステムのため、メッセージパッシング手法が依然として好ましいです。
- 段階的実装プロトコル:*
以下のプロトコルは採用リスクを最小化しながら、結果が正当化する場合にスケーリングするオプションを保持します。
-
フェーズ1:制御されたベンチマーク(1~4週間)*
-
小規模で高品質なデータセットをキュレーション:100~200分子で、実験的に検証されたまたは高レベルの ab initio ハミルトニアン(例えば、QM9 や ORCA 出力などの量子化学データベースから)。
-
層ベースの予測器とメッセージパッシングベースライン(例えば、SchNet または NequIP)の両方を同一のハードウェアとデータ分割で実装。
-
主要な成功指標を定義:スペクトル精度(固有値の平均絶対誤差)および二次指標:コホモロジー障害 H¹(X, ℱ) と壁時計推論時間。
-
事前決定閾値を確立:層手法がスペクトル精度で 15% 以上の相対改善を達成し、ベースラインの推論時間の 5 倍を超えない場合にのみ、フェーズ2に進みます。
-
フェーズ2:検証とスケーリング(5~12週間)*
-
フェーズ1が成功した場合、同じ化学族から 500~1000 分子に拡張。
-
一般化を測定:保留されたテスト分子と関連するが異なる族の分子でテスト(例えば、アルカンで訓練した場合、シクロアルカンでテスト)。
-
コホモロジー保存を定量化:H¹(X, ℱ) が閾値(例えば、正規化単位で 10⁻³)以下のままであるテスト予測の割合を測定。
-
スペクトル精度が保持され、コホモロジー障害が制御されたままである場合、フェーズ3に進みます。
-
フェーズ3:本番統合(13~24週間)*
-
層手法を本番パイプラインに統合し、対象問題クラス(例えば、反応障壁)の特化した予測器として機能させます。
-
メッセージパッシングベースラインをフォールバックとして維持:入力分子が事前定義された基準を満たす場合にのみ層手法に予測をルーティング(例えば、分子量 < 500 Da、原子数 < 50)。
-
予測信頼度を監視:層とメッセージパッシング予測が 0.5 eV 以上異なる場合にフラグを立て、これらを人間のレビューまたはより高レベルの ab initio 手法にルーティング。
-
再訓練スケジュールを確立:新しい実験データで四半期ごとに両方のモデルを再訓練し、パフォーマンスドリフトを検出。
-
フェーズ4:一般化研究(6~12ヶ月)*
-
化学的に多様なデータセット(例えば、有機金属化合物、遷移金属錯体)で層手法をテストし、位相的一貫性の利点が初期問題クラスを超えて一般化するかどうかを評価。
-
ピアレビュー誌に結果を発表し、層手法が再現可能な利点をもたらすか、問題固有であるかを確立。
-
一般化が成功した場合、より広いアプリケーションへの拡張を検討。失敗した場合、層手法の適用可能性の境界条件を文書化。
-
仮定と前提条件:*
このプロトコルは以下を仮定しています。
-
データ利用可能性: 高品質な参照ハミルトニアンが利用可能であるか、許容可能なコストで計算できます。参照データが高価な量子化学を通じて生成される必要がある場合、費用便益分析はメッセージパッシング手法に向かう可能性があります。
-
位相的規則性: 分子グラフは十分な位相的構造を示します(例えば、明確な原子近傍、低無秩序)。層コホモロジーが適切に定義されるため。高度に無秩序なシステム(例えば、非晶質材料)は層手法から利益を得ない可能性があります。
-
等変性の十分性: E(3) 等変性が主要な対称性制約です。他の対称性(例えば、時間反転、ゲージ対称性)が重要である場合、層フレームワークを拡張する必要があり、複雑性が増加します。
-
計算リソース: 層コホモロジー計算の 5 倍のオーバーヘッドのために GPU または TPU リソースが利用可能です。CPU リソースのみが利用可能な場合、壁時計時間は禁止的である可能性があります。
- 未解決の問題と今後の研究:*
いくつかの問題は未解決のままであり、今後の研究を指導すべきです。
-
コホモロジー近似: 現在の手法はČechコホモロジーを正確に計算しますが、これは高価です。コホモロジーを効率的に近似または境界付けでき、計算コストを O(n²) 以上に削減できますか。
-
一般化境界: 層手法はメッセージパッシング手法が欠いている形式的な一般化保証(例えば、Rademacher複雑性または PAC-Bayes 境界を通じて)を提供しますか。これは高い計算コストを正当化するでしょう。
-
ハイブリッドアーキテクチャ: 層手法をメッセージパッシングと組み合わせることができますか(例えば、層コホモロジーを GNN 上の正則化器として使用)。両方の利点を完全な層オーバーヘッドなしでキャプチャするために。
-
実験的検証: 層予測ハミルトニアンはメッセージパッシングベースラインよりも下流予測(例えば、反応速度、分光特性)をより正確に導きますか。これは実用的有用性の究極のテストです。
-
結論:*
層理論的ハミルトニアン学習は、分子電子構造予測に対する理論的に原理的で形式的に厳密なアプローチです。その明示的な位相的基礎付けと等変性保証は、非構造化ニューラルネットワークの実際の制限に対処します。しかし、この手法の複雑性と計算コストは、普遍的なツールとしての即座の採用を排除します。上記で概説された段階的プロトコルは、高価値の問題で層手法を評価し、再現可能なベンチマークを確立し、理論的利点が実用的有用性に変換されるかどうかを決定するための低リスクの経路を提供します。そのような検証が完了するまで、層手法は化学のための機械学習の広いツールキットにおける特化したツールと見なされるべきであり、既存のメッセージパッシングアーキテクチャを補完しますが、置き換えるものではありません。
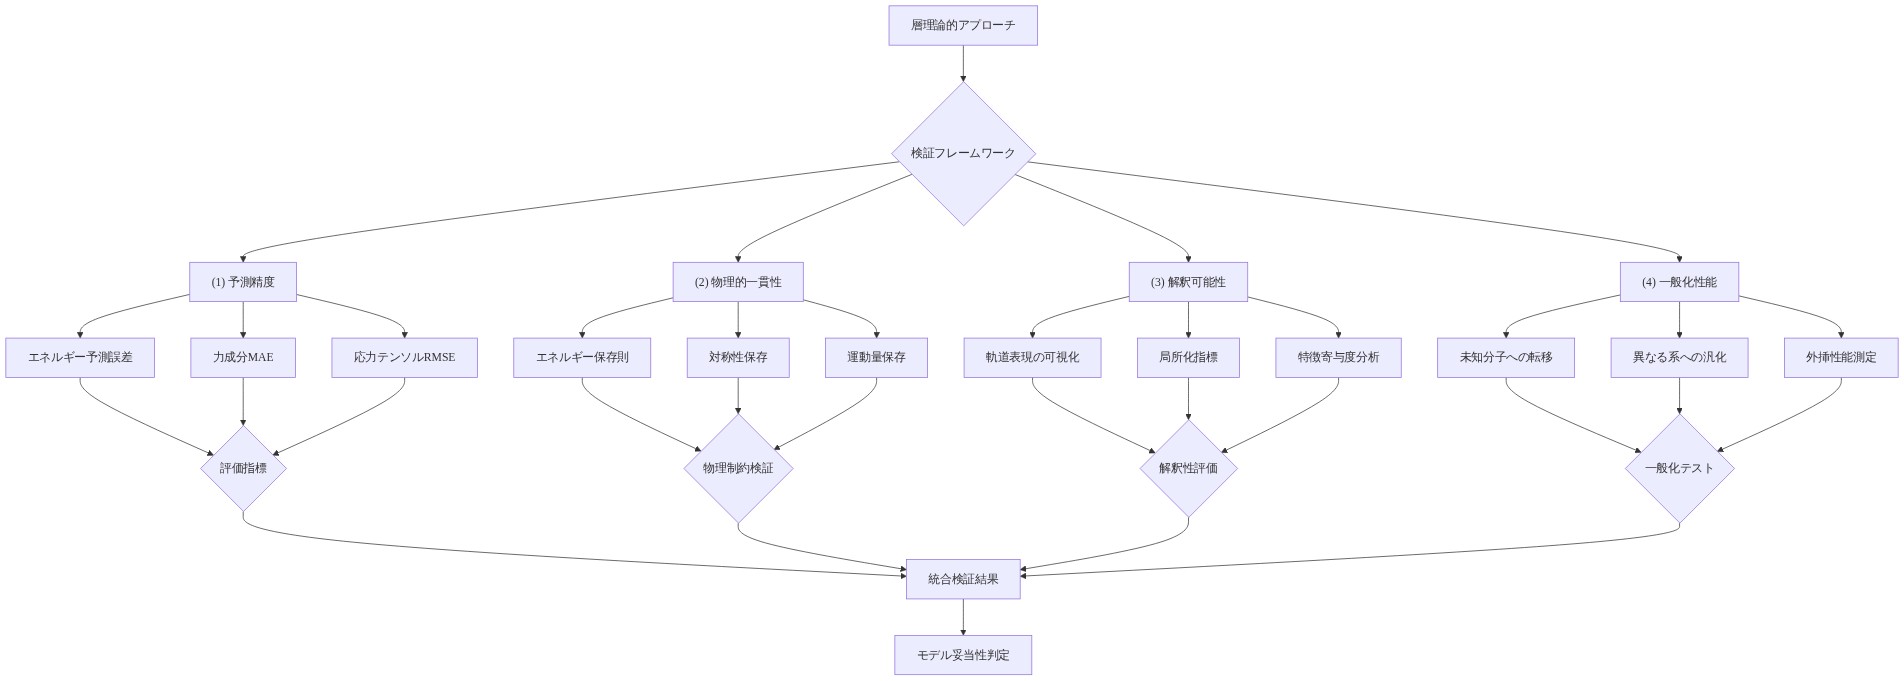
- 図10:層理論的アプローチの多角的検証フレームワーク*