長い契約書をチャットボットに貼りつけて、14条について質問したとしよう。モデルは答えを書くあいだ、貼られた言葉をすべて「作業用の記憶」として持ち続ける必要がある。
この記憶にはお金がかかる。ある新しい論文は、記憶を小さくするよくある方法が、人気のあるタイプのモデルでは気づかないうちにうまくいかなくなると指摘している。
そのタイプとは、Mixture-of-Experts(MoE)だ。MoEは、1つの単語をネットワークの専門家役の部品のうち、ごく一部にだけ通す。これで単語あたりの計算量が減る。
論文 MoEZip(arXiv:2610.30206) は、作業用の記憶は同じようには小さくならないと指摘する。さらに、この記憶を削ると、答えを書く専門家の顔ぶれが変わりうることも見いだしている。1
この記事のポイント
- MoEは1トークン(モデルが読む文字のかたまり)ごとに使う重みが少ない。それでもKV(キー・バリュー)キャッシュは、入力が長くなるほど増える。1
- 既存のKVキャッシュ圧縮は、標準の「密な」モデル向けに作られた。著者らによると、削った結果、専門家の選ばれ方が変わる点を見落としている。1
- MoEの圧縮では、正確な注意と、安定した専門家選びの2つを守る必要がある。
計算は軽くなっても、メモリの請求書は重いまま
MoEはトークンごとの計算を減らすが、ここまでの会話を覚えておくメモリは減らさない。 この記憶は、入力が増えるたびに大きくなる。
長い入力では、今も大きなボトルネックだ。1
MoEが計算を減らす仕組み
MoEモデルには、たくさんの「専門家」がいる。専門家とは、独立した重みのまとまりのことだ。ルーターという小さな部品が、各トークンに点数をつけ、ごく少数の専門家にだけ送る。
こうすると、モデル全体の大きさは増やせる。それでも、1つのトークンが触れる重みはほんのわずかで済む。
大きな病院を思い浮かべてみよう。専門医をどれだけ増やしても、患者全員がその全員に診てもらうわけではない。受付が選んだ2、3人の医師だけが診る。
メモリが減らない理由
節約が止まるのは、注意(アテンション)の部分だ。モデルは、見たすべてのトークンについて、キーとバリューを保存する。
どの専門家がそのトークンを担当したかは関係ない。この保存場所がKVキャッシュで、入力が長くなるほど増えていく。
MoEZipの著者らは、このことをはっきり述べている。長い文脈を扱う推論では、KVキャッシュが系列の長さとともに増えるため、メモリが大きなボトルネックのままだという。1
次の表は、MoEが減らすコストと、手をつけないコストを整理したものだ。
| 資源 | 何に応じて増えるか | MoEの効果 |
|---|---|---|
| トークンごとの計算 | 動かす専門家の数 | 減る |
| 専門家の重み | 専門家の総数 | 大きいが一定 |
| KVキャッシュ | 入力長×層数×バッチ | 減らない |
2種類のメモリコスト
この2つのメモリコストは、性質が違う。重みは1回だけかかるコストだ。一度読み込んだら、ハードウェアに分けて置いておける。
キャッシュは、かかり続けるコストだ。バッチ内のリクエストが増えるたび、そしてモデルが新しいトークンを出すたびに大きくなる。
入力がとても長く、同時のリクエストも多いと、キャッシュがメモリ全体の大きな割合を占めることがある。
それがいつ起きるかは、モデルの設計しだいだ。特に次の3つが効く。
- 層の数:層ごとに、自分のキーとバリューを持つ。
- KVヘッドの数:ヘッドが多いほど、1トークンあたりの保存量が増える。
- グループ化クエリアテンション:複数のアテンションヘッドが同じキーとバリューを共有する設計で、キャッシュが小さくなる。
運用する側の選択肢
長い入力は当たり前になりつつある。だから、この負担は現実の問題だ。メモリが足りなくなると、運用する側には主に3つの選択肢がある。
- バッチを小さくする:単純だが、同時にさばけるリクエストが減る。
- キャッシュを外に出す:遅いメモリに移せば品質は保てる。ただし、移すたびに遅れが加わる。
- 圧縮する:キャッシュの項目を捨てたり小さくしたりする。いちばん魅力的な手だ。MoEZipの論文は、MoEモデルでこれが気づかれないまま失敗しうることを示している。1
注意のずれが、ルーティングのずれになるまで
MoE(Mixture-of-Experts)モデルでは、注意のわずかなずれが、トークンを別の専門家へ送ってしまうことがある。 その切り替わりは、少しずつ動くのではなく、跳ぶように起きる。
普通のモデルなら安全な近道でも、MoEでは答えを変えてしまいうる。
従来の「捨て方」の考え方
KVキャッシュの削除は、ふつう「価値」の問題として考えられる。どの項目が、使うメモリに見合っているのか。どれなら、注意への影響を最小にして捨てられるのか。
この見方は、分離型サービングでの学習型KVキャッシュ保持で掘り下げられている。密なトランスフォーマーにはよく合う考え方だ。
ただし、注意の小さな誤差は出力の小さな誤差にしかならない、という前提を黙って置いている。MoEでは、この前提が崩れる。
密なモデルが被害を吸収できる理由
密なモデルでは、まずい削除の被害は主に注意に出る。注意の出力が少しずれると、隠れ状態も少しずれる。
そのあとのフィードフォワード層は、いつもと同じ重みを使う。
下流で進路が変わることはない。だから誤差は、原因に比例した大きさにとどまりやすい。層を重ねるうちに積もることはあるが、積もり方はゆるやかだ。
MoEが跳ぶ理由
MoEモデルでは、注意から出てきた隠れ状態がルーターに入る。ルーターはすべての専門家に点数をつけ、上位k人にトークンを送る。
上位kを選ぶというのは、線を引くことだ。通勤で、所要時間がほぼ同じ2つの路線から選ぶ場面を考えてみよう。
片方が1分遅れただけで、ルートごと入れ替わることがある。削除で隠れ状態が線のすぐ向こうへずれると、トークンは別の専門家へ行く。
次の表は、同じ注意の誤差に対する2種類のモデルの反応を比べたものだ。
| 項目 | 密なトランスフォーマー | MoEトランスフォーマー |
|---|---|---|
| 注意の誤差の影響 | 小さく、ゆるやかなずれ | 動く専門家が入れ替わる |
| 次の計算 | どちらでも同じ重み | 切り替われば別の重み |
| 誤差の育ち方 | 原因とほぼ同じ歩調 | 境界で跳び、積み重なる |
専門家は、それぞれ得意分野を持っている。だから、間違った専門家は、正しい専門家とはかなり違う形でトークンを変換する。
出力の誤差は、原因になった注意の誤差よりずっと大きくなりうる。 変わった結果は次の層の注意とルーターにも流れ込む。そのため、誤差は層が深くなるほど育つことがある。
影響が答えの生成中に表れる理由
MoEZipの要旨は、被害が答えの生成中に出ると位置づけている。このタイミングには納得がいく。
新しいトークンは、圧縮された文脈への注意から作られた隠れ状態をもとに、送り先が決まる。
モデルが1トークンずつ書いていくとき、ある時点でルーティングが変われば、選ぶ単語が変わりうる。その単語は、以後のすべての手順に影響する。
プロンプトの圧縮で生じた注意の誤差が小さくても、最終的な答えは変わることがある。
問題は1つではなく2つ
MoEモデルのKVキャッシュ削除は、2つの問題を同時に解く必要がある。
- 注意の忠実さ:残した項目で、注意の出力を十分に近く再現できるか。
- ルーティングの維持:残した項目で、ルーターの上位kの選択が変わらずに済むか。
標準的な方法は、累積した注意スコアでトークンを並べたり、直近のトークンの窓を残したりする。これらが狙うのは、1つ目の問題だけだ。注意が最も重く見るトークンは、ちゃんと残せるかもしれない。
それでも、ルーティングの判断を境界の正しい側にとどめているトークンは、捨ててしまうことがある。
ルーティングを意識した削除方針をつくる
中心になる考えは単純だ。キャッシュの項目を捨てるとき、ルーティングも「残す理由」の1つにする。 捨てると、トークンの選ぶ専門家が変わってしまう項目には、特別な保護を与える。
要旨は、この問題とこの目標を示している。仕組みの細部までは書いていない。
以下の設計上の問いは、この考えに基づくどんな方針にも当てはまる。MoEZip自体がどう動くかの説明ではない。
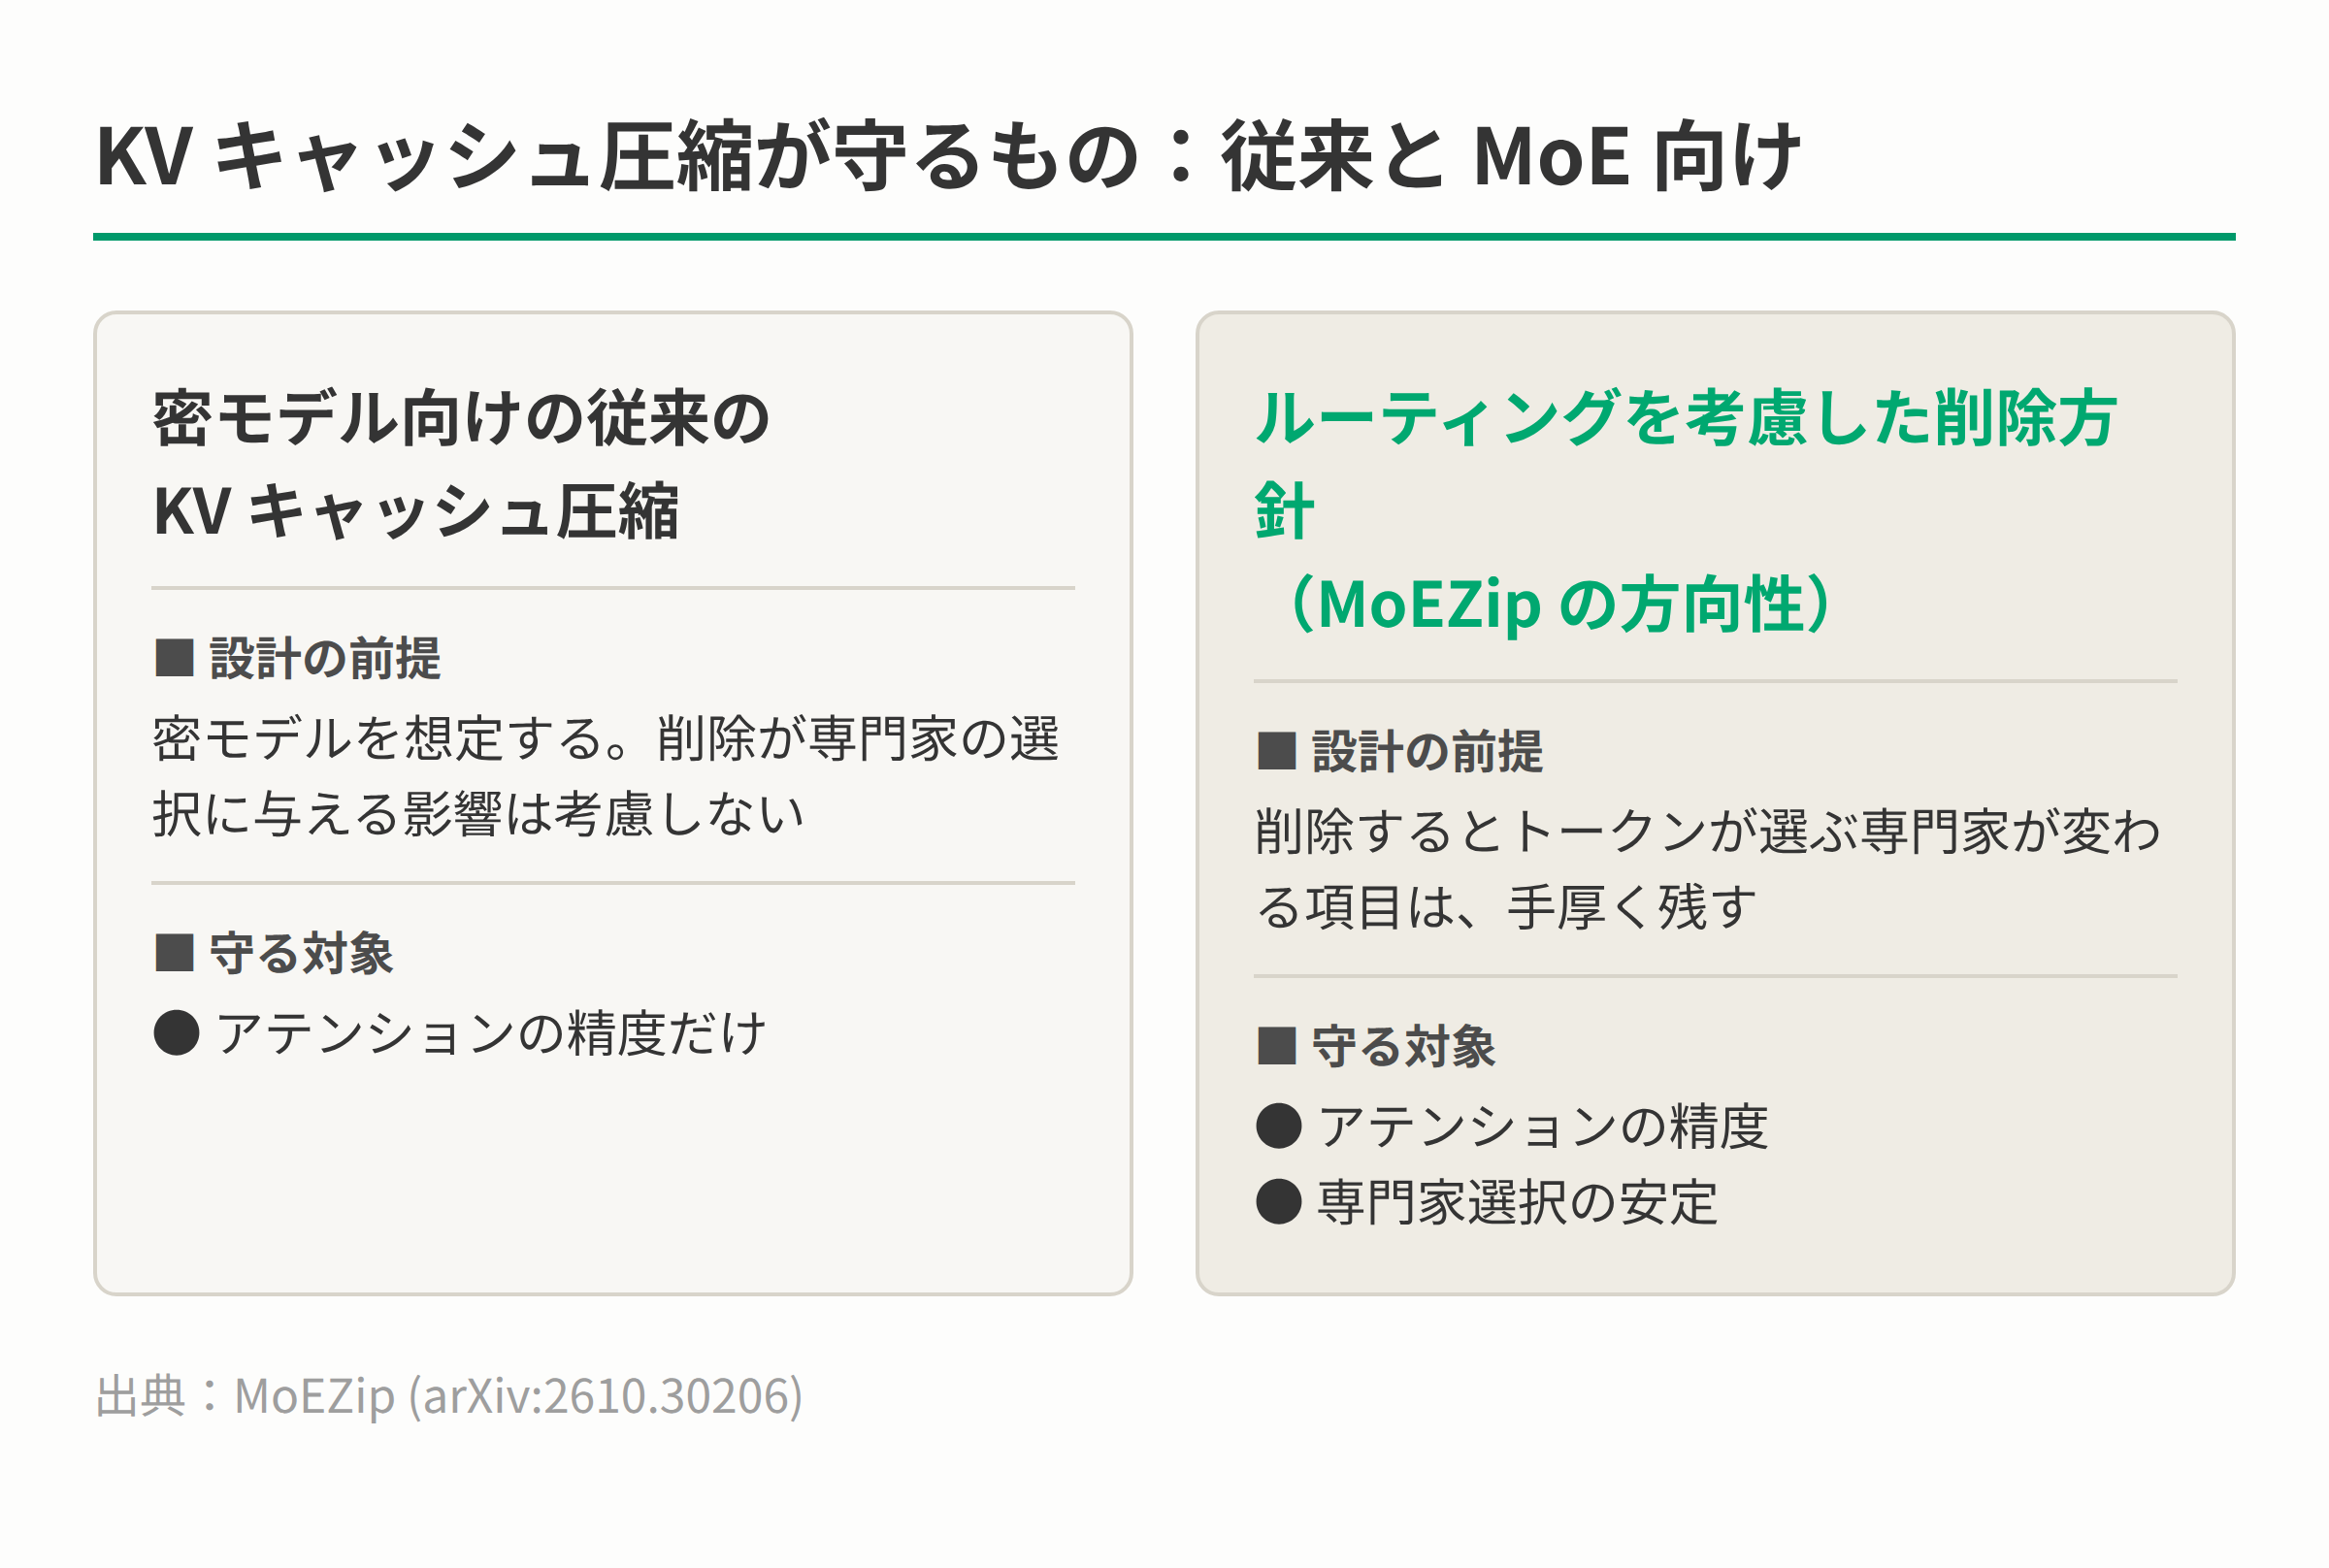
図3:従来の圧縮とルーティングを考慮した圧縮が守るもの(出典:MoEZip (arXiv:2610.30206))
使えるほど安い信号はどれか
方針には、どのルーティング判断が壊れやすいかを見分ける手がかりが要る。候補になる信号は、分かることも、集めるコストも違う。
次の表は、3つの候補を比べたものだ。
| 信号 | 測るもの | コスト |
|---|---|---|
| ルーターのロジット | 各MoE層の専門家の生スコア | ほぼゼロ(計算済み) |
| top-kのマージン | 最後に選んだ専門家と次点の差 | 低い(ロジットから算出) |
| ルーティングの安定性 | 層や手順をまたいで選択が保たれるか | 高い(履歴の管理が要る) |
最初に試すのにいちばん自然なのは、top-kのマージンだ。安くて局所的で、ルーティングが切り替わる仕組みに直接つながっている。
接戦の投票を想像してほしい。最後に選ばれた専門家が次点にわずかな差で勝っただけなら、ちょっとした揺れで順位が入れ替わる。マージンが小さいのは、まさにそういう壊れやすい判断の印だ。
壊れやすいトークンと、鍵になる項目のあいだのすき間
マージンには、はっきりした限界がある。マージンが表すのは、いま送り先を決めているトークンの状態だ。その判断を支えているのがどのキャッシュ項目なのかは、これだけでは分からない。
だから、方針には両者をつなぐ手段が要る。1つの案は、注意を使って寄与を探る方法だ。
壊れやすいクエリが、キャッシュ内の各キーにどれだけ重みを置いているかを見る。こうしたつながりがなければ、マージンは問題の存在を知らせても、守るべき項目を指せない。
保護は層ごとか、トークンごとか
この選択は、方針がメモリをどこまで細かく配分するかに関わる。どちらも無料ではない。
- 層ごと:ルーティングが壊れやすい層に多くのキャッシュを割り当て、頑丈な層には少なくする。壊れやすさが深さによって実際に違う場合にだけ報われる。ありそうな話ではあるが、出典では確認されていない。
- トークンごと:個々の項目を保護する。より正確だが、項目ごとの追跡にコストがかかる。
スコアはどう組み合わせるか
方針は、ルーティングを、注意が必要とするものの通常の尺度と比べて重みづけする必要がある。
妥当な方法の1つは、重み付きの和だ。注意の重要度に、ルーティングの感度の項を足す。バランスは1つの重みで決まる。
この重みを間違えると、失敗の仕方は2通りある。
- 低すぎる場合:ルーティングがほとんど考慮されず、方針は密なモデル向けの普通の経験則と変わらなくなる。
- 高すぎる場合:注意が必要とするトークンが足りなくなる。答えが引き出すべき、遠くにある事実などだ。
ルーティングを意識するコスト
ルーティングを意識すると、余分な負担が生じる。品質が上がっても、その分と比べて考える必要がある。
- 余分な状態:項目ごと、層ごと、ヘッドごとに感度を追跡しなくてはならない。
- 遅れの増加:新しいトークンを出すたびにスコアを計算すると、毎回の手順が遅くなる。
- 予算の下限:ルーティングの信号が別の方向を指していても、注意に欠かせないトークンのために、一定のキャッシュは取っておく必要がある。
学習型の保持とのつながり
ルーティングを意識する考え方は、学習型の保持とも相性がいい。学習型のスコアラーは、すでにキャッシュ項目の特徴を受け取り、残すか捨てるかを決めている。
ルーティングをこのスコアラーに取り入れる流れは、次のように考えられる。
- 手作業で調整したルールの代わりに、ルーティングのマージンと安定性を入力の特徴に加える。
- 特定のモデルでスコアラーを学習させる。
- そのモデルでルーティングがどれだけ重要かを、スコアラーに学ばせる。
これが手で設計したルールより優れるかは、まだ分からない。答えを出せるのは実験だけだ。
証拠が示すべきこと
ベンチマークの点数が上がっただけでは、ルーティングを守ることが決め手だったとは言えない。
説得力のある検証は、2種類の被害を切り分けなくてはならない。注意がゆがんだことと、専門家の選択が入れ替わったことだ。
修理したあとで車の調子が悪くなった場合を考えてみよう。悪くなったと分かるだけでは足りない。
どの部品が原因かを知る必要がある。ここでも同じことが言える。
説得力のある評価に入れたい5つのこと
次の項目は、「点数が上がった」と「ルーティングが理由だ」のあいだにあるすき間を、それぞれ別の形で埋める。
- 専門家選択の一致率。 同じ入力を、完全なキャッシュと圧縮したキャッシュで動かす。top-kの専門家の選択を、層ごと、手順ごとに比べる。これでルーティングのずれを直接測れる。
- 一致率と品質の関係。 注意の誤差がほぼ同じでも、一致率が下がれば答えが悪くなる、という関係が要る。これがないと、ずれは原因ではなく副作用かもしれない。
- 長い文脈での検索タスク。 答えが入力のはるか前にある情報に左右される試験だ。生成中の注意とルーティングの両方に負荷がかかる。
- そろえたメモリ予算。 密なモデル向けの手法にも、同じキャッシュサイズを与える。多くのメモリを残したから勝っただけの手法では、何も証明できない。
- 圧縮率ごとの結果。 ルーティングの説明が正しければ、強く削るほどずれが効くはずだ。軽い圧縮率では、ルーティングを意識する方法と密なモデル向けの方法で、点数がほぼ同じになることもありうる。
決着をつけうる実験
特に決め手になる実験が1つある。キャッシュは圧縮する。ただし、ルーターには、完全なキャッシュで動かしたときの専門家の選択を、そのまま使わせる。
- 品質がほぼ戻るなら、損失の大半はルーティングの入れ替わりで説明できる。
- 戻らないなら、より大きな問題は注意のゆがみで、ルーティングの説明は弱くなる。
まだ分かっていないこと
1つのMoEモデル群で出た結果が、ほかのモデルにも当てはまるとは限らない。モデルによって、専門家の数や、トークンごとに選ぶ数(top-k)が違う。すべてのトークンが共有する専門家がいるかどうかも違う。
要旨が裏づけているのは仕組みであり、効果の大きさまでは示していない。 MoEZipがどれだけ役立つかの数字は、論文の全文で確かめる必要がある。
MoEの運用基盤にとっての意味
キャッシュの項目を捨てると、モデルの選ぶ専門家が変わりうるなら、密なモデルで実証された手法は、MoEで検証し直す必要がある。 それらの手法は、注意の誤差がコストのすべてだという前提で確かめられてきた。
この話は、よく使われるいくつかの手法に及ぶ。
- 学習型の保持:どのキャッシュ項目を残すかを決めるスコアラー。
- オフロードの階層:キャッシュ項目を、遅くて安いメモリに移す方法。
- プレフィックスの共有:プロンプトの処理(プリフィル)とトークンの生成(デコード)を別のマシンで動かすとき、リクエスト間でキャッシュを再利用する方法。
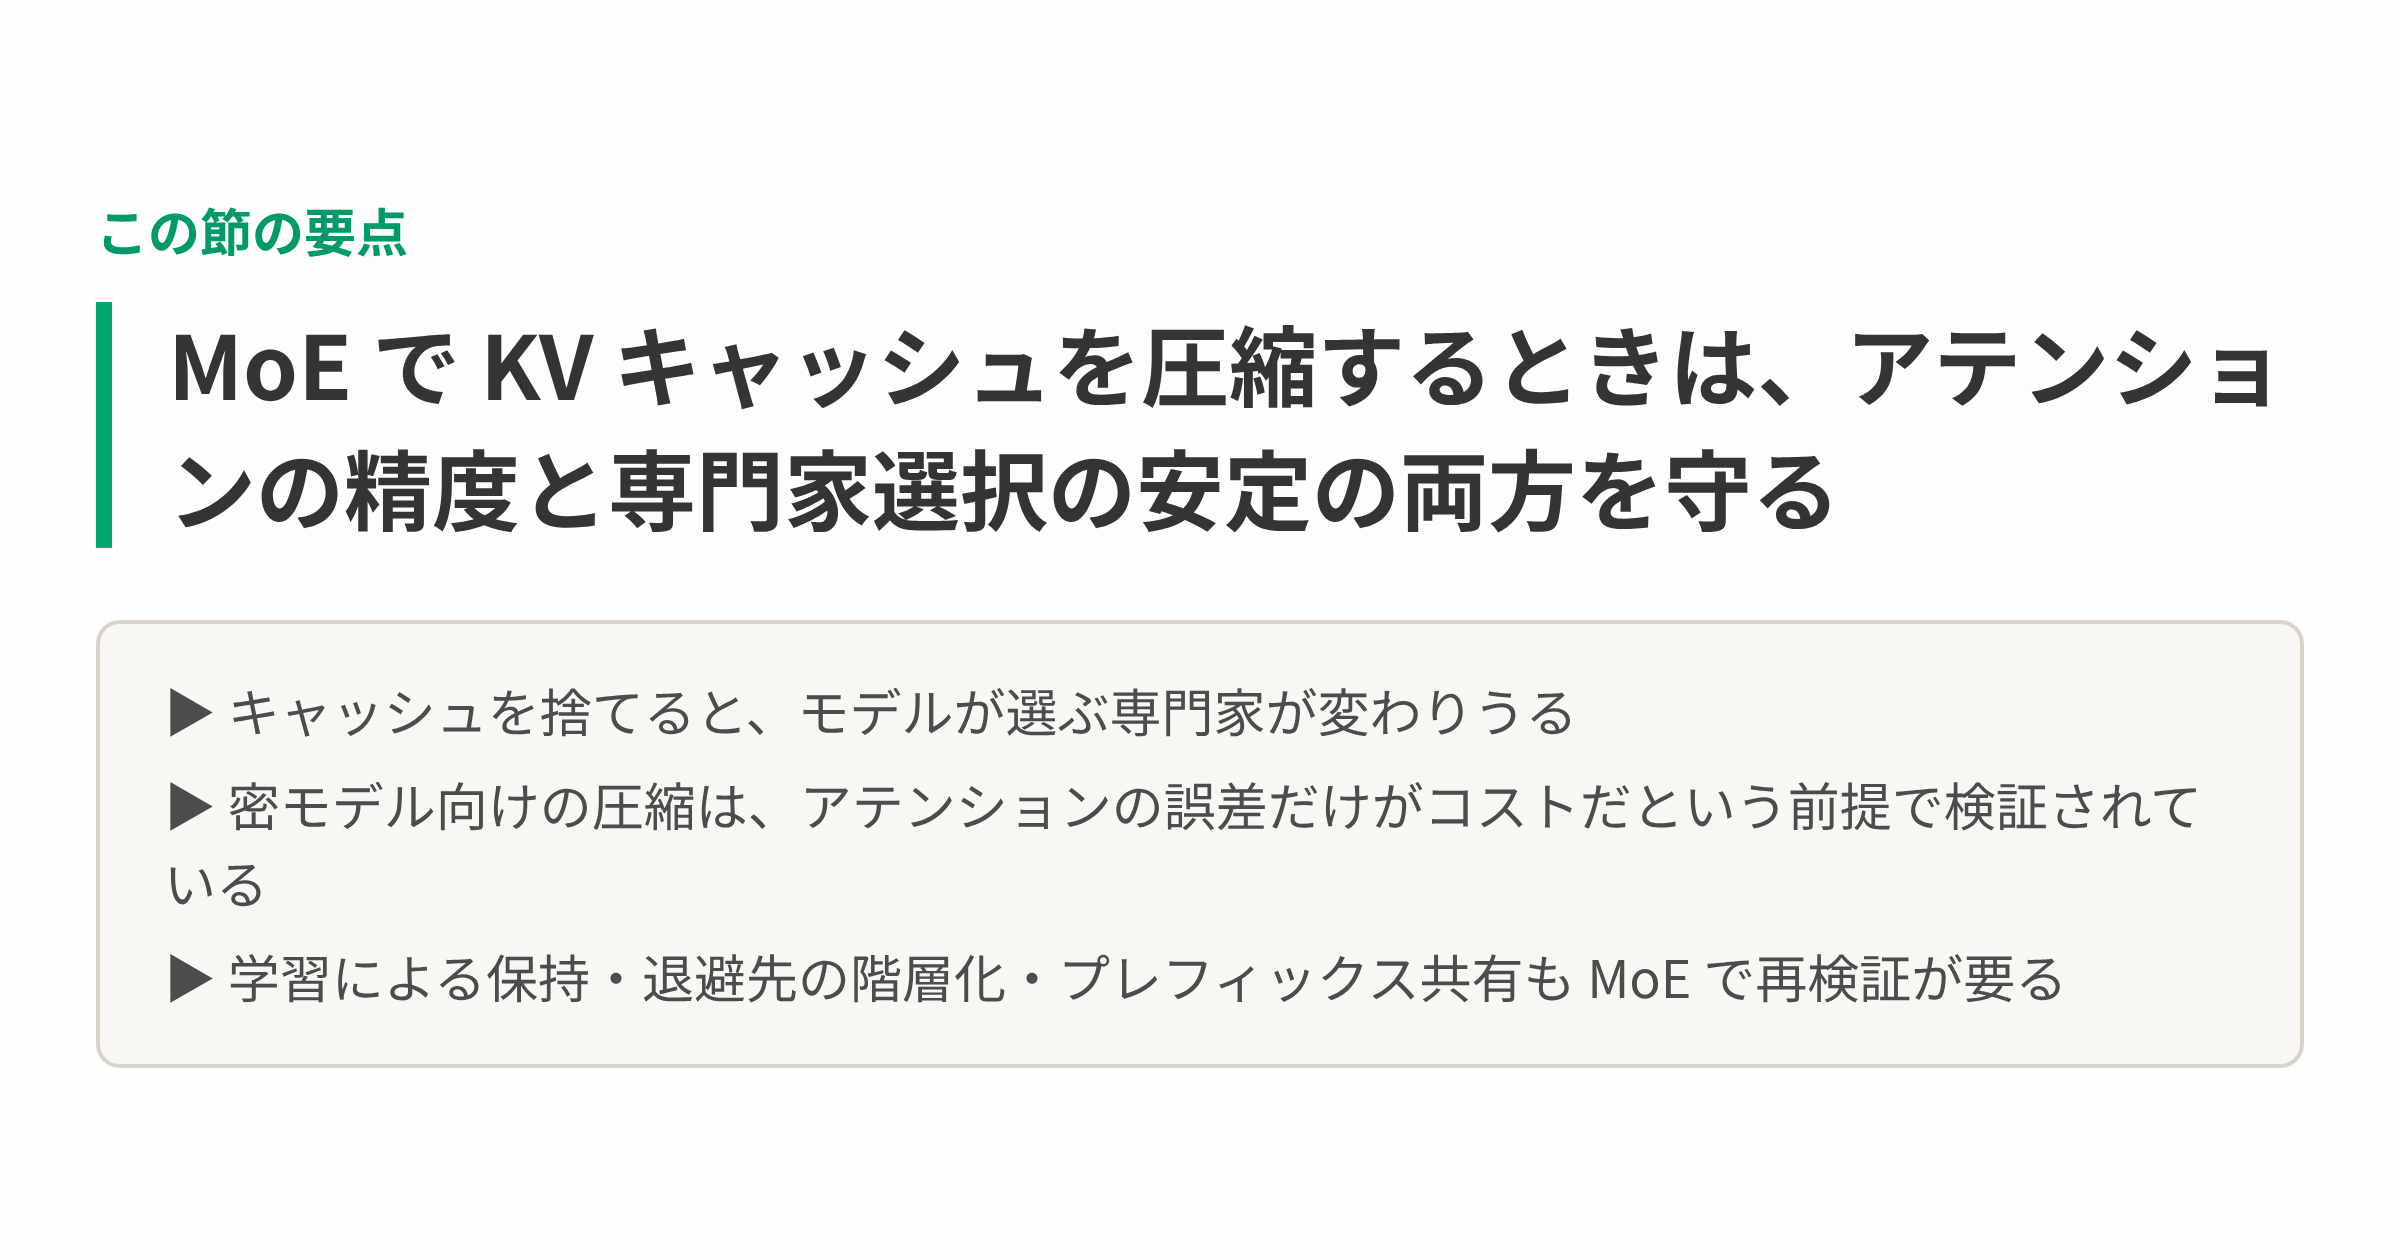
図4:MoE の推論基盤で KV キャッシュを圧縮するときに守る 2 つの条件(出典:MoEZip (arXiv:2610.30206))
修正はどこに置けるか
ルーティングへの配慮をどこに置くかには、実際に選択の余地がある。次の表は3つの案を比べたものだ。ここでのトレードオフは、各層の仕組みから考えたもので、測定した結果ではない。
| 置き場所 | 考えられる利点 | 欠点 |
|---|---|---|
| モデル(頑丈なルーター) | 根本の原因に届く | 学習が必要で専門化が鈍るかも |
| キャッシュ管理 | 削除を直接制御できる | モデルがルーターの信号を出す必要 |
| スケジューラー | 敏感な依頼に大きな予算を渡せる | 粗い(項目単位でなく依頼単位) |
モデル側の案は、もう少し詳しく見る価値がある。圧縮されたり雑音の入ったりした文脈で訓練したルーターは、削除の影響を受け流すことを学ぶかもしれない。そうなれば、密なモデル流の圧縮がふたたび安全になる。
ただし、落とし穴がある。あらゆる乱れを無視するルーターは、役に立つ信号まで無視する可能性がある。誰かが試すまでは、仮説のままだ。
専門家の並列化で賭け金が上がる理由
専門家が複数のチップに分散していると、ルーティングは各トークンの移動先も決める。だから、1つの判断が入れ替わると、3つのことに同時に響く。
- 出力の品質:別の専門家が計算する。
- 通信量:トークンが別の装置へ行く。
- 負荷の分散:専門家のあいだで通信量が移る。
圧縮のせいで、トラフィックが同じ少数の専門家にばかり寄っていくとしよう。それらの専門家が混雑の中心になり、システム全体を遅くするかもしれない。
これは可能性であり、確認された結果ではない。圧縮率が高いときや、負荷が偏った仕事で起きやすそうに思える。もし起きれば、品質のスコアより先に、スループットなどの運用指標に表れる可能性が高い。
1つの変更がシステム全体に波及する
ここから言える広い教訓は、MoEのシステムは部品を1つずつ調整できないということだ。キャッシュを圧縮すると、ルーティングが変わりうる。
ルーティングが変わると、チップ間の通信が変わる。通信が変わると、応答時間が変わる。
メモリの節約が、気づかないうちにシステム全体の振る舞いを変える結果につながることがある。
慎重に導入するときに確かめたいこと
長い文脈を扱うMoEモデルを動かすチームには、上の議論から5つの確認が浮かぶ。
- 公開前のルーティングのずれ。 実際のトラフィックのサンプルで、完全なキャッシュと圧縮した実行の専門家選択を比べる。
- 実際の圧縮率。 仕組みから考えて、強く削るほどずれが大きくなるなら、穏やかなテスト用の圧縮率ではずれが隠れてしまう。
- 入力としてのルーターのマージン。 学習型の保持スコアラーを使っているチームなら、各ルーティング判断がどれだけ僅差だったかを渡せる。
- 公開後の専門家の負荷。 新しい混雑や通信の急増が、警告のサインになる。専門家がチップに分散している場合は特にそうだ。
- 重要なトークンのための保護枠。 注意に欠かせない項目の場所を確保しておけば、ルーティングの保護が遠くの事実を押し出すことはない。
ちょっと立ち止まって
多くの効率化の工夫は、モデルのどの部分も単独で絞れると、暗黙のうちに考えている。MoEは、その前提が崩れる場所を見せてくれる。
疎な計算は、代償のない節約に見えた。ところが、注意のすぐ後ろに、はっきりした切り替えスイッチも置いている。ルーターが、どの専門家を動かすかを選ぶのだ。
密なモデルでは、キャッシュの小さな誤差は出力を少し動かすだけだ。MoEでは、同じ誤差で、選ばれる専門家が入れ替わることがある。
だから、圧縮したキャッシュが元とほぼ同じに見えても、モデルは別の道に入ることがある。「出力はどれだけ近いか」を測るだけでは、話の半分しか分からない。もう半分は、「どの選択が変わったか」だ。
あなたが、ソフトウェアや仕事の中で頼っている近道を思い浮かべてみてほしい。「はい・いいえ」を決める直前に、安上がりな近似を置いてはいないだろうか。
そして、ある近道が「十分によい」かを判断するとき、結果がどれだけ似て見えるかを確かめているだろうか。それとも、その後に起きたことが変わったかどうかを確かめているだろうか。
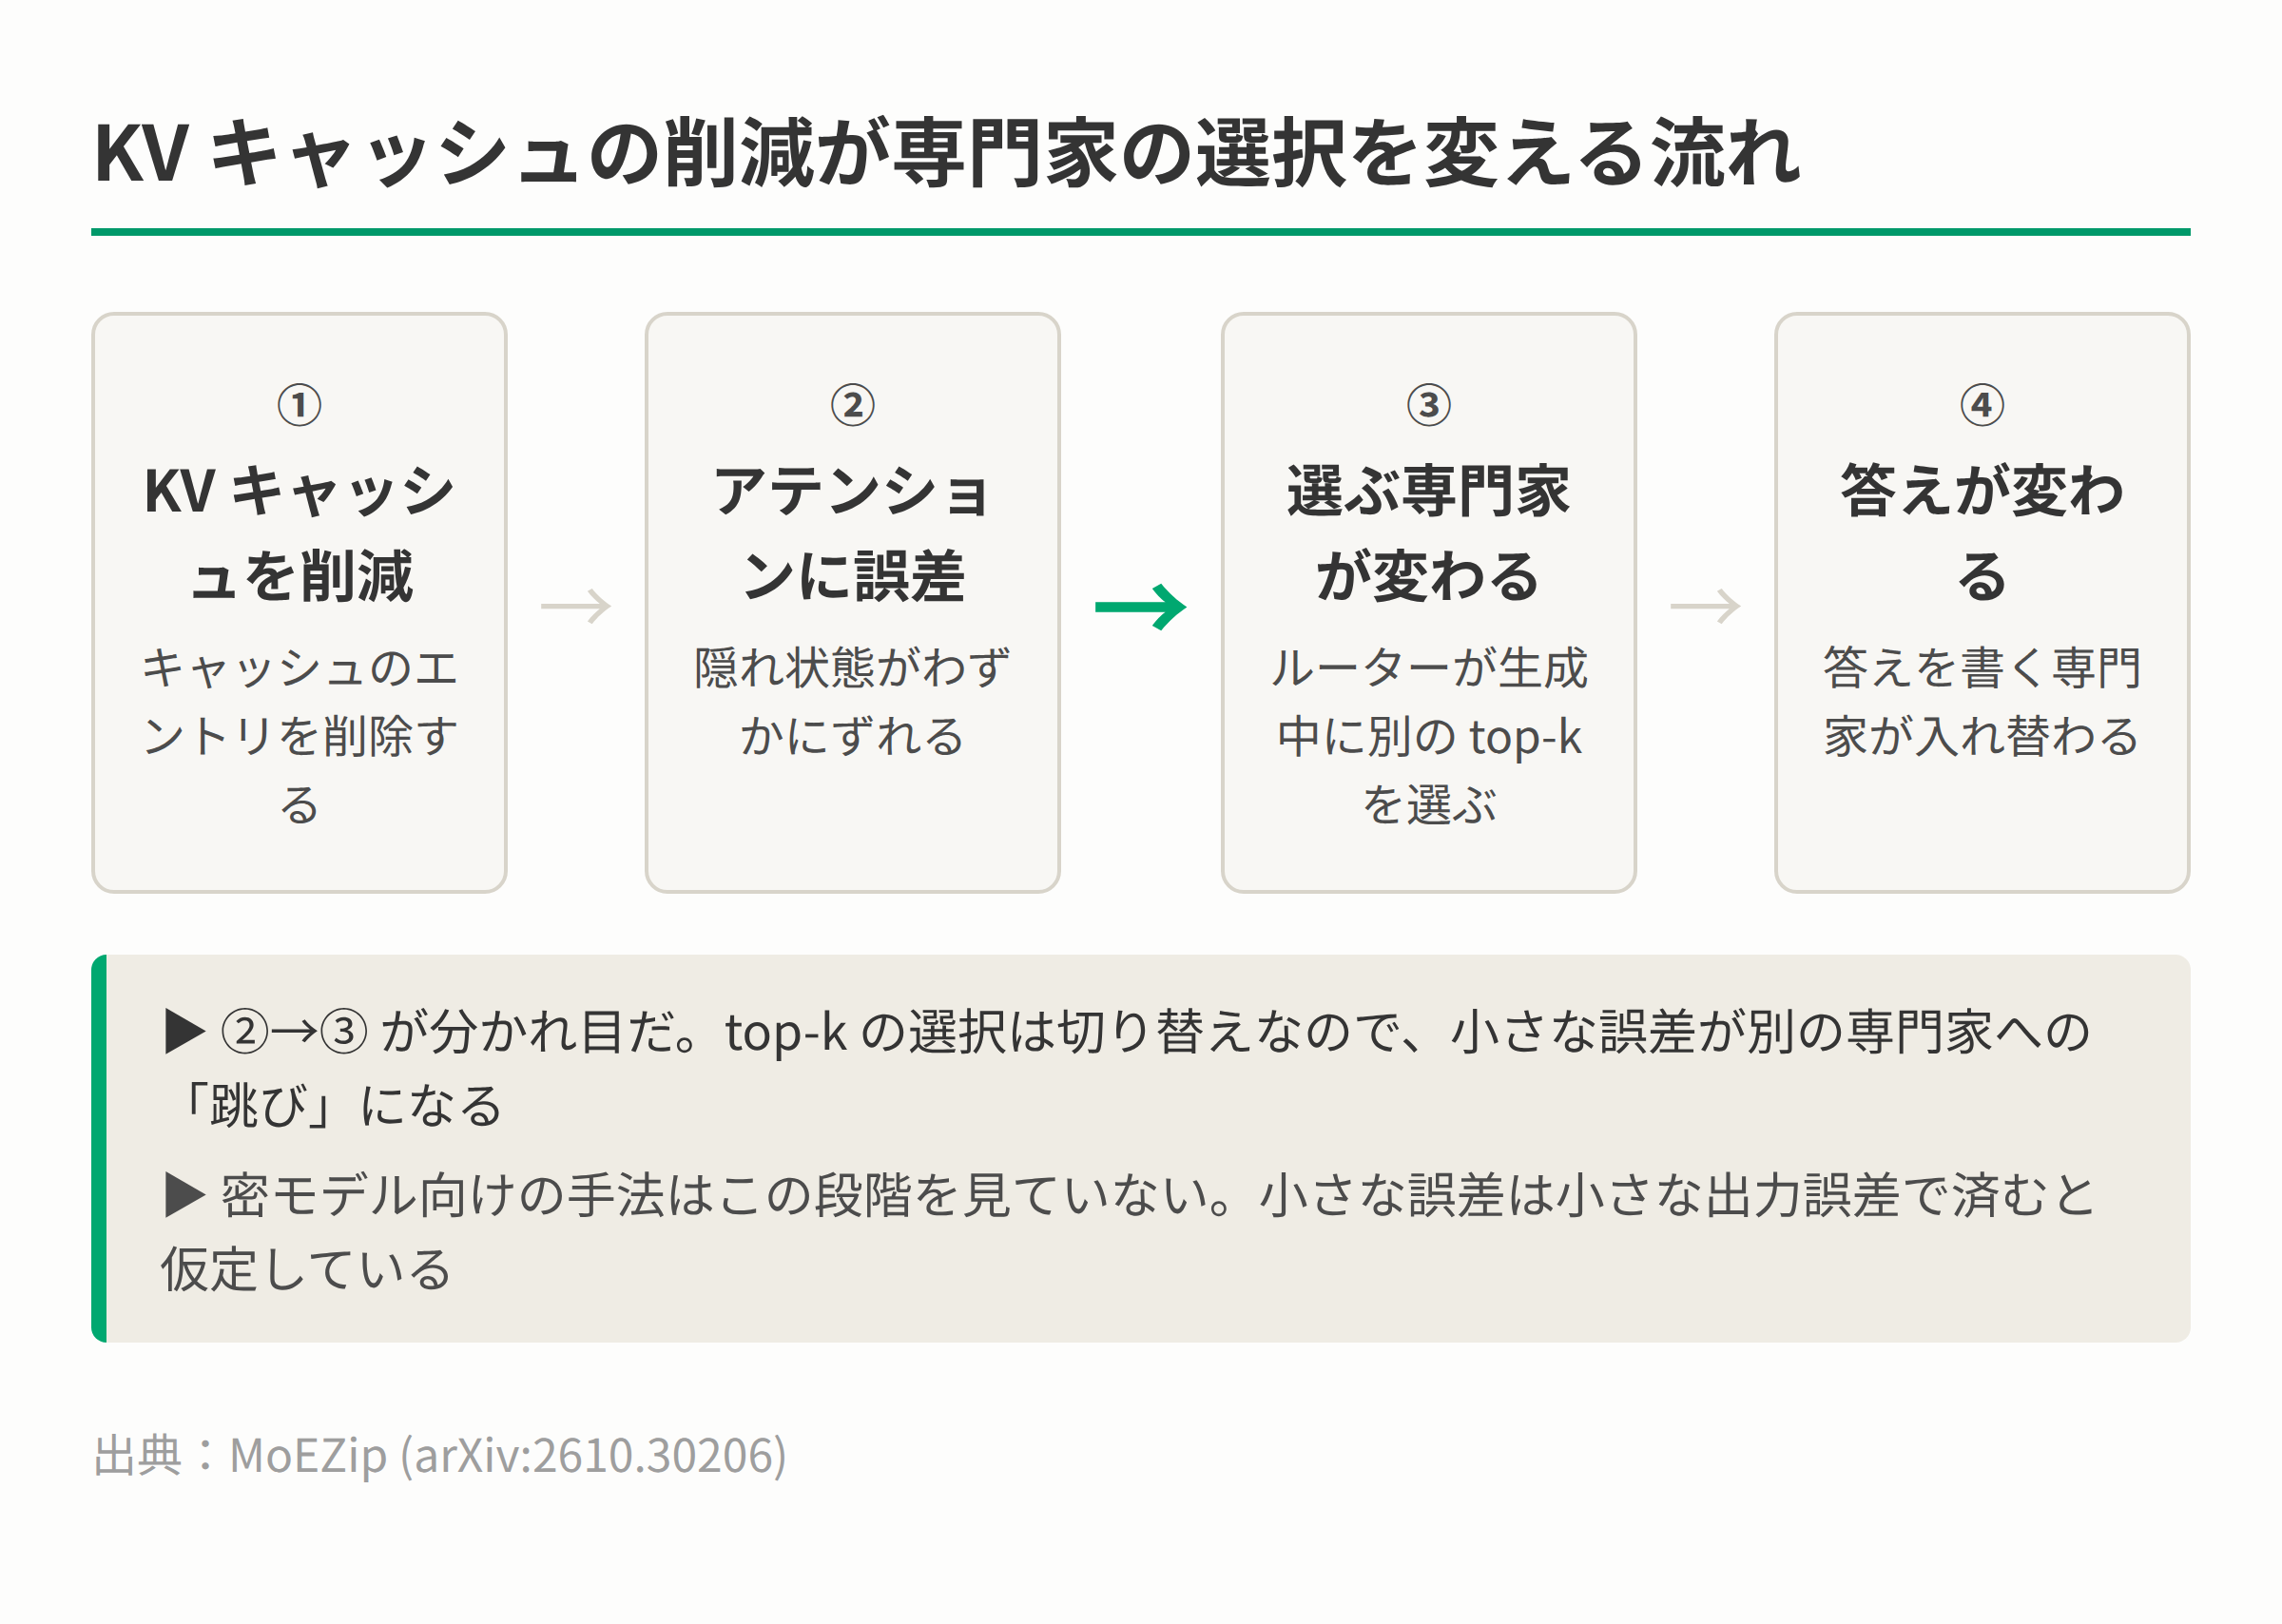
図2:アテンションの誤差がルーティングの誤差に変わる流れ(出典:MoEZip (arXiv:2610.30206))