新しいAIモデルが発表されるたび、「これまでとは別次元」という言葉が並ぶ。Metaが発表した「Muse Wonder」も例外ではない。
その言葉は、あなたが次に使うAIや、日々開くアプリの中身にまで関わってくる。では、本当に飛躍なのだろうか。それとも、よくできた小さな一歩にすぎないのだろうか。
Metaは、幅広い推論力とマルチモーダル(文章だけでなく画像なども扱える)機能を前面に出している。ただ、詳しい情報はまだ少ない。
発表の時点では、包括的なベンチマーク(性能の比較テスト)は公開されていない。第三者による評価も限られている。
企業が何を強調し、何をあいまいにするかは、その企業が以前どこで見劣りしたと感じているかを映すことが多い。
Metaが推論とマルチモーダルを強調するのは、この2つで力を示す必要があると考えているからかもしれない。
問いは単純だが、決着をつけるのは難しい。Muse Wonderは現実の仕事で明らかに良い結果を出すのか。それとも、投資家や開発者に向けた位置づけの演出が中心なのか。
この記事のポイント
- Metaは従来のモデルから大きく進んだと主張するが、発表時点で第三者の検証は限られている。
- 信頼性は、宣伝文句と測定できる性能との差にかかっている。
- 今回の発表からは、汎用型の設計、オープン性、設備投資、製品への組み込みという戦略上の選択も見えてくる。
飛躍は本物なのか
ベンチマークと実際の利用状況が、いちばん確かな手がかりになる。 発表当日の主張だけでは、判断の材料として弱い。第三者による評価、ブラインドテスト、開発者が実際にどう使うかのほうが、ずっと重みを持つ。
見るべき点は、現実の作業で明らかに良くなったかどうかだ。投資家や開発者向けの位置づけの話と、実際の性能の話は、切り分けて見たほうがいい。
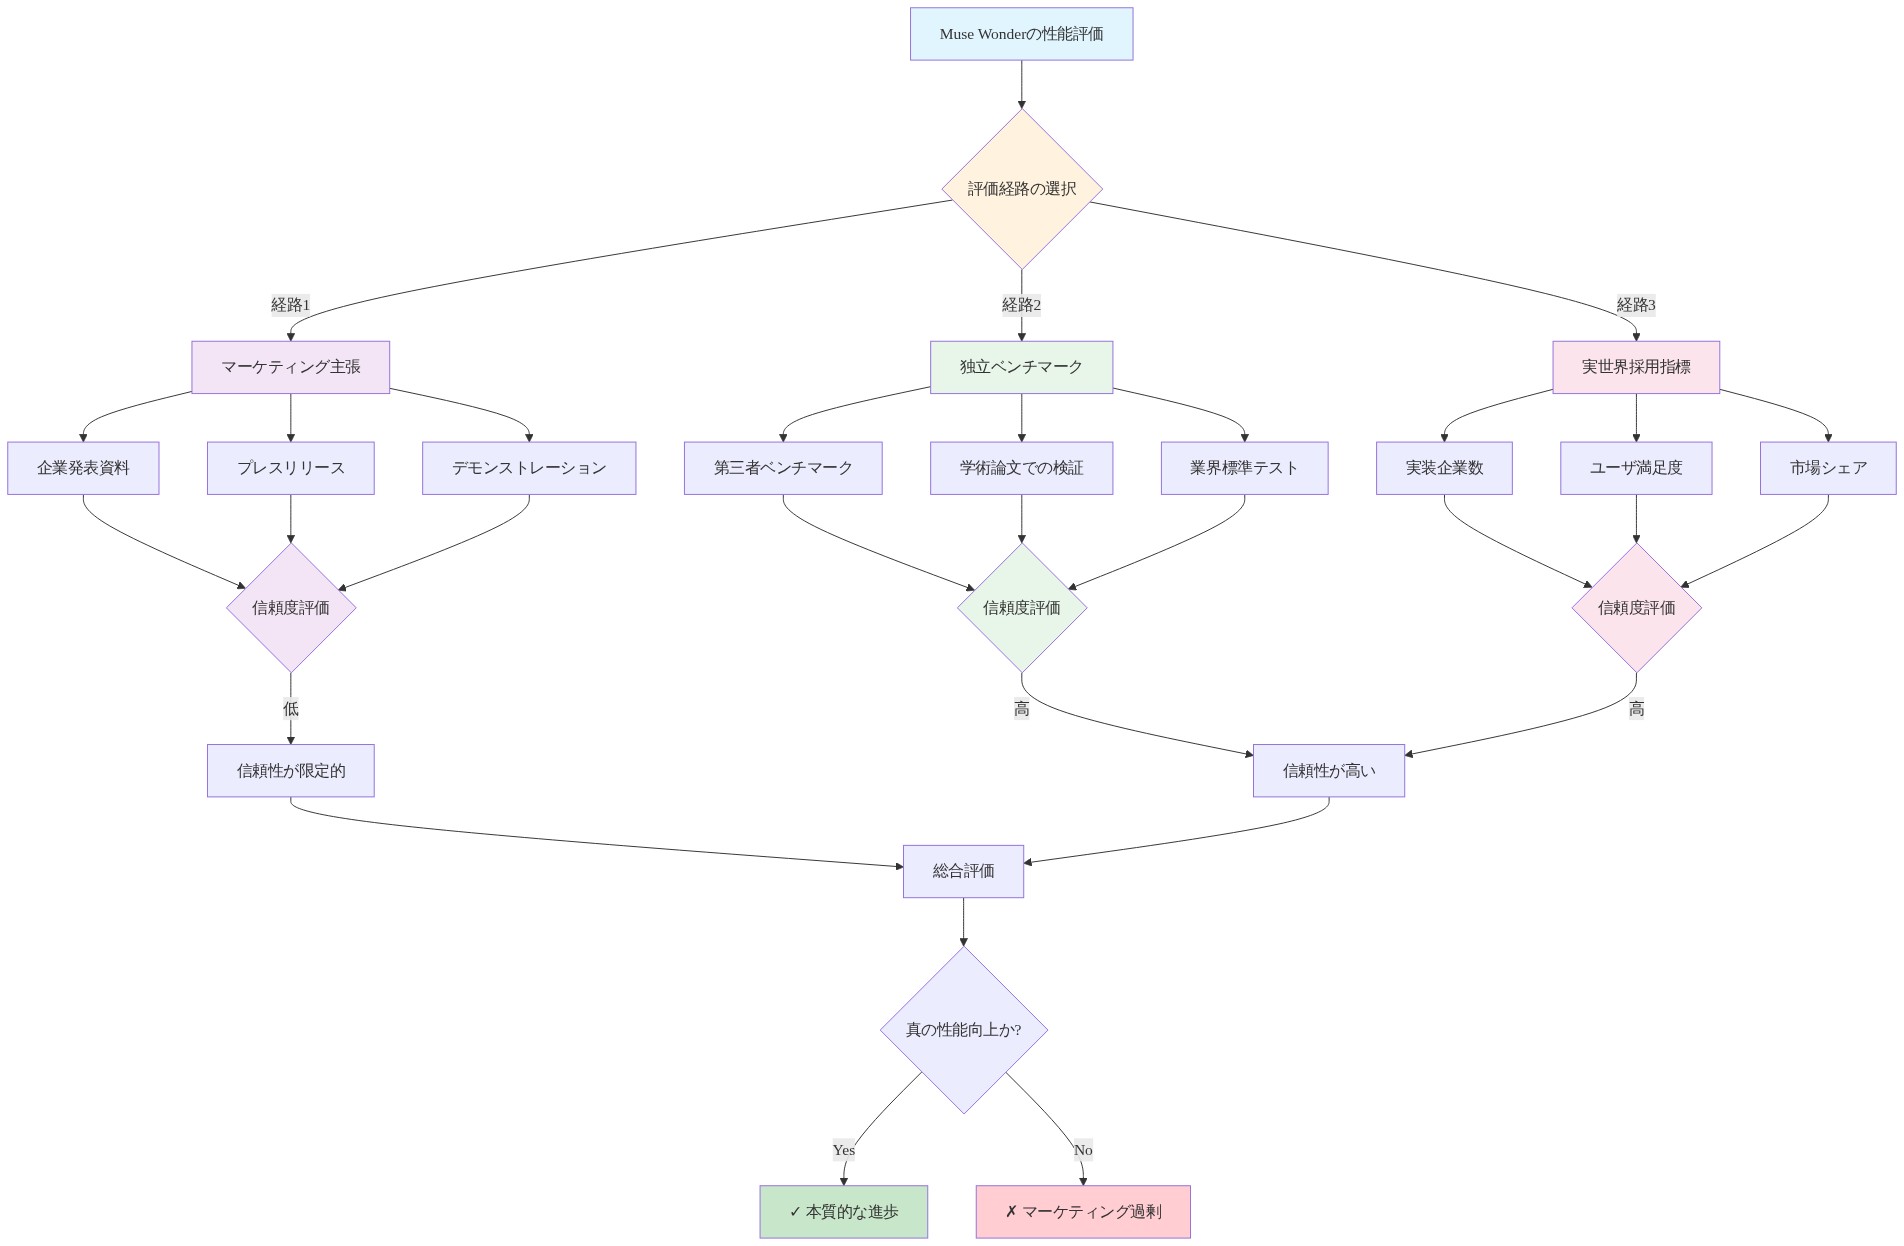
図2:Muse Wonderの性能評価フレームワーク - 3つの検証経路による信頼性判定
何でもこなす型と、得意分野を磨く型
Metaが選んだのは、幅広い用途に使える汎用型のシステムだ。一方、GoogleのGemini 4 Argonは、コード生成とセキュリティに力を集中させている。
2つの発表は、AIが何をいちばん得意とすべきかという、異なる考え方を映している。
次の表は、汎用型と特化型を比べたものだ。
| 観点 | 汎用型(Metaの方針) | 特化型(Gemini 4 Argonの方針) |
|---|---|---|
| 基本の考え方 | 1つのシステムで多くの仕事をこなす | 価値の高い分野を深く掘る |
| 強み | 規模の効果と、消費者への幅広い浸透 | 正確さが問われる場面での決定的な勝ち |
| 投資家への説明 | 単純で、広がりがある | 企業向けの価値に焦点を絞る |
| 主なリスク | 分野ごとに調整された競合に負けうる | 対象となる市場が狭い |
| 主な分野 | メッセージ、SNSのフィード、広告ツール | ソフトウェア開発、セキュリティ、防衛、金融 |
Metaの選択は、同社の持ち味に合っている。毎日使うユーザーは数十億人にのぼり、統合されたプラットフォームも抱えている。
汎用モデルのほうが、特化型よりも、メッセージ、SNSのフィード、広告ツールに広げやすい。画面ごとに別のモデルを作らなくても、1つのシステムを調整して使い回せる。
これが意図した戦略なのか、Metaの事業構造から自然にそうなったのかは、はっきりしない。 どちらの見方も成り立つ。
Metaほどの広がりを持つ企業なら、どちらにしても汎用型に傾くだろう。そのため、強い信念から選んだのか、都合がよかったから選んだのかは見分けにくい。
大手2社が、これほど優先順位の違う主力モデルを出してきた。となると、市場は「唯一の最高のモデル」に向かってまとまっているわけではなさそうだ。
むしろ、層に分かれていく可能性がある。消費者向けの幅広いモデルと、専門的で要求の高い仕事向けの特化型モデルが並ぶ形だ。そうなれば、買う側は総合順位ではなく、用途に合わせてモデルを選ぶことになる。
揺れるMetaのオープン路線
Metaは、AI分野での存在感の多くを、オープンな公開によって築いてきた。その評判は開発者からの好意を集めた。周辺のツールや派生プロジェクトの大きな輪にも、影響力を持つことができた。
状況は変わっている。オープンモデルを出す開発者どうしの力関係は、大きく動いた。
競合のオープンモデルも成熟した。最先端のシステムを訓練するコストは、ずっと高くなっている。
Muse Wonderについては、基本的な問いが残る。完全に公開されるのか、一部だけなのか、非公開なのか。
次の表は、公開の仕方ごとにMetaの得るものと手放すものを整理したものだ。
| 公開方法 | Metaが得るもの | Metaが手放すもの |
|---|---|---|
| オープン | 開発者の好意と、エコシステムへの影響力 | 競合がモデルを自由に使えるため、競争上の優位 |
| 一部オープン | エコシステムの利点を保ちつつ、管理も強められる | 分かりやすさ。開発者が何に頼れるのか判断しにくい |
| クローズド | 巨額の研究開発投資の保護 | かつて持っていた、オープンモデルとしての違い |
初期の兆候からは、Muse Wonderが過去のオープンウェイト(学習済みの重みを公開する方式)の取り組みよりも、制限が強い可能性がうかがえる。それが確認されれば、損得の計算が変わったことを示すことになる。
競合のオープンモデルが弱かった頃は、オープンにすることがMetaの個性になった。
いまは強力なオープンの選択肢があり、訓練費用も上がっている。最先端のモデルを無償で配っても、失うものは大きく、際立つ度合いは小さい。
この判断は、Metaの戦略にある緊張関係をあらわにする。オープンにすることは、長い目で見れば競争上の強みになりうる。ただ、巨額の研究費に対して近い将来の見返りを得る必要性とは、天秤にかけなければならない。
Metaの過去のモデルの上で開発してきた人たちにとって、この結果は他人事ではない。Metaがオープンから退くのか、やり方を磨き直すのかを知りたいはずだ。
退くなら、他のオープンモデルに移る人も出るだろう。一部を公開し、残りは閉じるといった磨き直しなら、コミュニティの一部はとどまるかもしれない。ただ、次に何が出てくるのか分からないという不安は残る。
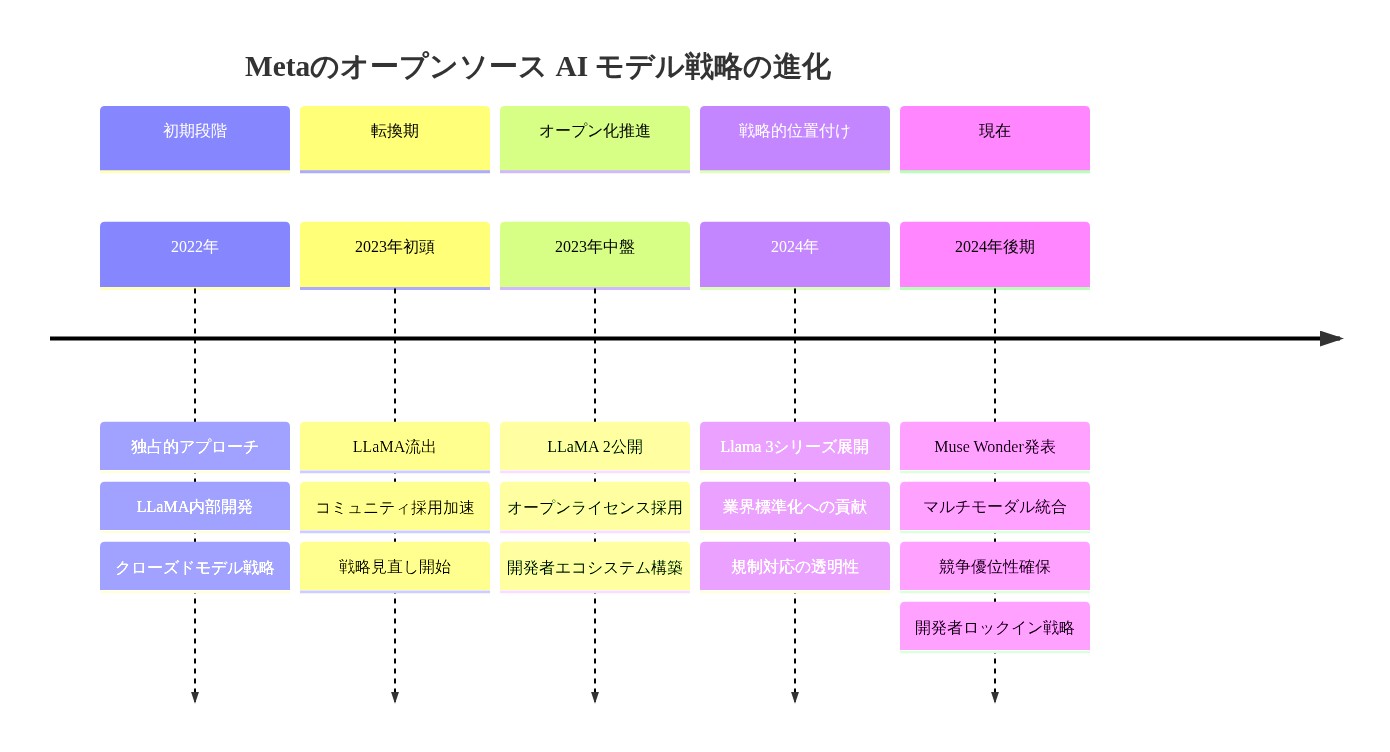
図7:Metaのオープンモデル戦略の進化
モデルの裏にある資金競争
Muse Wonderは、計算資源、人材、市場での地位をめぐる、激しさを増す競争の一手にすぎない。投資額の約束や、半導体の調達先との関係が、競争の地図をますます左右している。
この競争を形づくる動きは、いくつかある。
- 巨額の支出は、利益率が下がっても耐えるという表明だ。 Metaの投資姿勢は、競争力を保つためなら当面の財務負担を受け入れることを示している。
- モデルの発表は、財務上のメッセージも兼ねる。 発表は、ユーザーだけでなく資本市場にも向けた発信になっている。
- 業界は循環する構造になりつつある。 半導体メーカー、モデル開発者、プラットフォームが、互いに出資し合っている。
- 相互依存が、競争に加われる企業を絞る。 この結びつきが、最先端のシステムを本気で訓練できる企業を左右している。
この循環構造は重要だ。半導体の供給元、モデルの開発者、プラットフォームが資金面でつながっていると、競争は「誰が最高のモデルを作るか」だけでは決まらない。
誰が有利な条件で計算資源、提携先、資金を確保できるかも勝負になる。そうしたネットワークの外にいる企業は、いっそう険しい坂を登ることになる。
Metaにとって、この支出は野心であると同時に、やむを得ない面もある。中核の事業は、広告と、自社のプラットフォームをユーザーの生活の中心に置き続けることにかかっている。
AIで後れを取れば、その両方が弱まりかねない。より強いモデルを持つ競合なら、より良いおすすめや、効果の高い広告、魅力的な機能を提供できるからだ。
大手テック企業にとって、この資金競争は存亡に近い問題になっている。Muse Wonderは1つの製品だ。同時に、この競争にとどまり続けるというMetaの決意表明でもある。
モデルから製品へ
どれほど優れたモデルでも、使える形で人々に届かなければ意味がない。この点で、Metaには際立った強みがある。
同社の配信網は、メッセージ、SNSのフィード、広告、そしてスマートグラスのようなハードウェアにまで及ぶ。
Muse Wonderは、こうした接点にいくつかの形で組み込まれうる。関連性の高い相手に広告を届ける精度を上げる。
ユーザーや広告主が文章や画像を作るのを手伝う。フィードやサービスで表示される内容を左右する。
ただし、組み込みには課題もつきまとう。
1つ目は、使い心地の摩擦だ。すでに使っている製品にAIを足すと、余計な一枚が挟まったように感じられることがある。
慣れた使い方を邪魔する機能や、頼んでいない機能は、利用ではなく反発を招くかもしれない。導入は、押しつけではなく役に立つと感じられる形でなければならない。
2つ目は、収益化だ。Metaがモデルの質を収益に変えられるかどうかは、まだ分からない。広告の成果が上がることは、考えられる道筋の1つだ。
しかし、高度なAIをMetaの規模で提供するには、費用がかかる。改善が小さければ、その費用が得られる利益を上回るかもしれない。
次の表は、結果の見え方と財務への影響を整理したものだ。
| 結果 | どう見えるか | 財務への影響 |
|---|---|---|
| 価値が明確 | 広告の成果やクリエイティブ生成で、測れる改善がある | 投資が元を取れる |
| 価値がまちまち | 便利な機能はあるが、利用が偏る、または改善が小さい | 提供コストを回収しきれないかもしれない |
| 使い道が不明 | 優れた能力はあっても、製品での使い道がはっきりしない | モデルがコストだけを生む部門になる |
成功するかどうかは、モデルの能力がそのままユーザーの価値や広告主の見返りに変わる使い道があるかにかかっている。
配信網があれば、Metaは桁違いの規模で人々に届くことができる。ただ、届くことが成果を保証するわけではない。
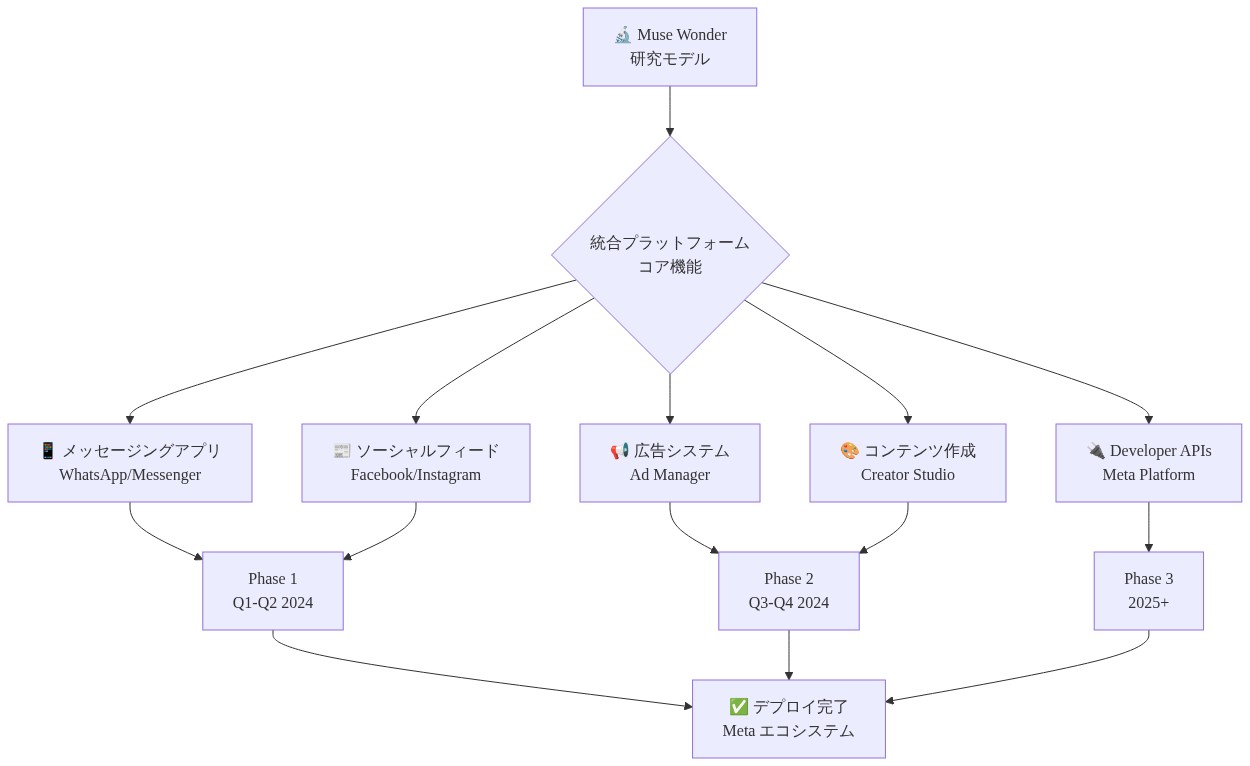
図11:Muse Wonderのモデルからプロダクトへの統合ロードマップ
これから見るべきこと
Muse Wonderの意味は、これから数か月に集まる証拠で決まる。発表当日の主張だけでは、重みは小さい。推論、コーディング、マルチモーダルな理解で現実にどれだけ性能を出せるかが、ずっと大事になる。
次の表は、各シグナルが示す2つの読み方を並べたものだ。
| シグナル | 飛躍が本物だったことを示す場合 | 位置づけの主張だったことを示す場合 |
|---|---|---|
| 第三者による評価 | 競合のシステムに対して強い結果が出る | 競合に劣るか、並ぶだけにとどまる |
| ブラインドテスト | Muse Wonderが代替のモデルを上回る | はっきりした優位がない |
| 開発者の採用 | 開発者が自分のツールに組み込む | 採用が伸び悩む |
| 競合の発表 | Muse Wonderが差を縮める、または広げる | 数か月のうちに競合がより強いシステムを出す |
| Meta自身の製品 | 競争上の優位につながる、測れる改善がある | 製品や成果に目立った変化がない |
いちばん明確な手がかりは、Meta自身から出てくるだろう。同社の製品が測れる形で良くなり、その改善が競争上の優位や株主にとっての価値に結びつけば、今回の発表は謳い文句どおりだったことになる。
Muse Wonderを自分の目で見極めるには、次のことが役に立つ。
- 第三者のベンチマークを待つ。 発表資料よりも、外部の評価を重く見る。
- 作り始める前にライセンスを確かめる。 ソフトウェアを開発する人は、使うと決める前に、Muse Wonderが実際にどこまでオープンなのかを確認する。
- 用途に合ったモデルを選ぶ。 汎用型と特化型は、一般的な順位ではなく、自分がやりたい仕事に照らして比べる。
- Metaの製品の変化に気づく。 メッセージ、フィード、広告のAI機能が、自分の使い心地を本当に良くしているかを見る。
- Metaの資金の振り向け方を追う。 支出の変化は、この戦略への本気度がどう動いているかを示す。
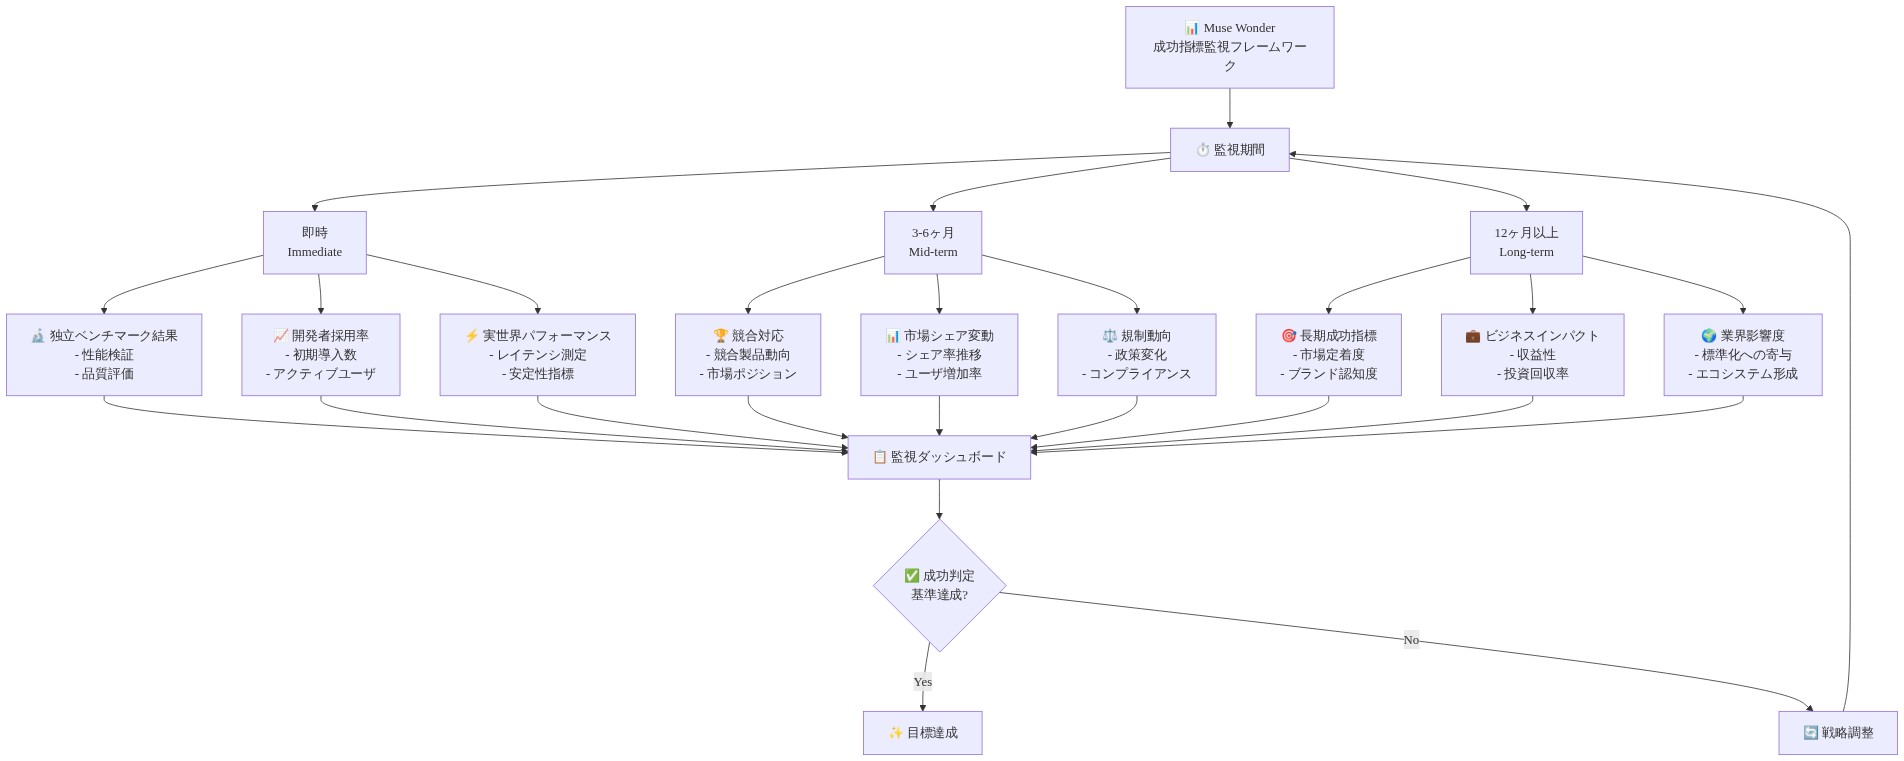
図13:Muse Wonder成功指標の監視フレームワーク(時間軸別メトリクス追跡体系)
ちょっと立ち止まって
Muse Wonderは、大きな主張と、乏しい公開証拠を携えて登場した。発表当日の熱気に流されるのは簡単だ。すべてを誇大宣伝と切り捨てるのも、同じくらい簡単だ。
新しいAIモデルが本当に優れていると、何があれば納得できるだろうか。ベンチマークの点数だろうか。毎日頼りにする道具だろうか。
それとも、すでに使っているアプリで気づく変化だろうか。次の画期的な発表が来る前に、この問いに答えを出しておくと、その後に続く主張を見極めやすくなるかもしれない。
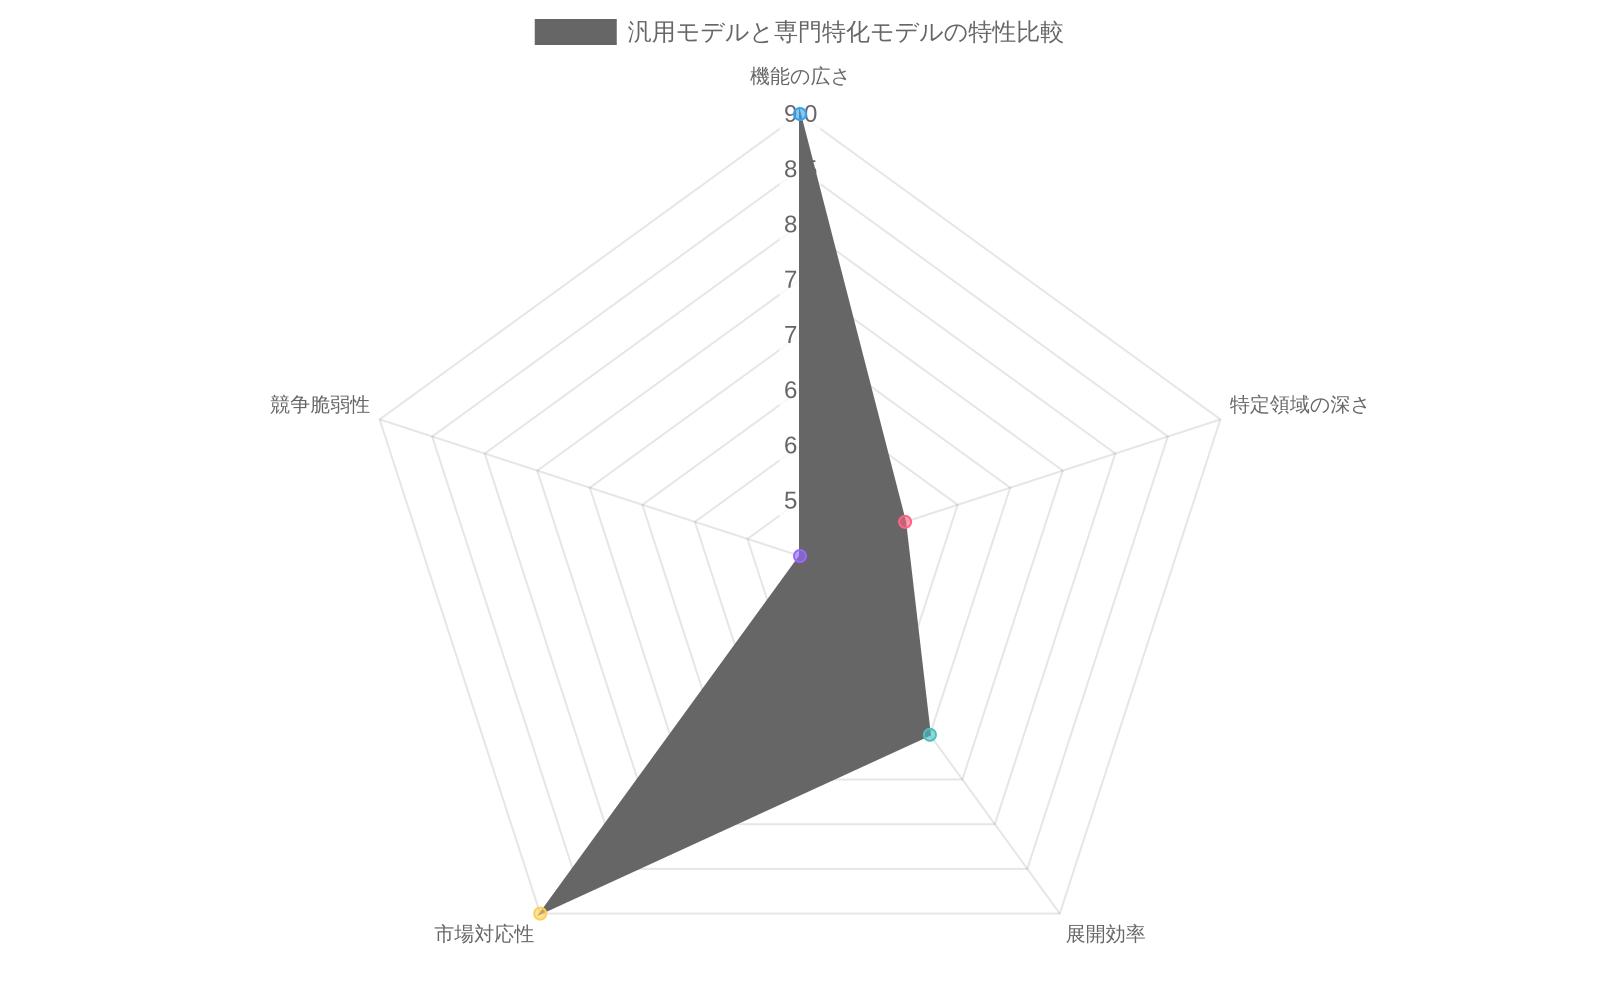
図5:汎用モデルと専門特化モデルの特性比較レーダーチャート(出典:記事分析)
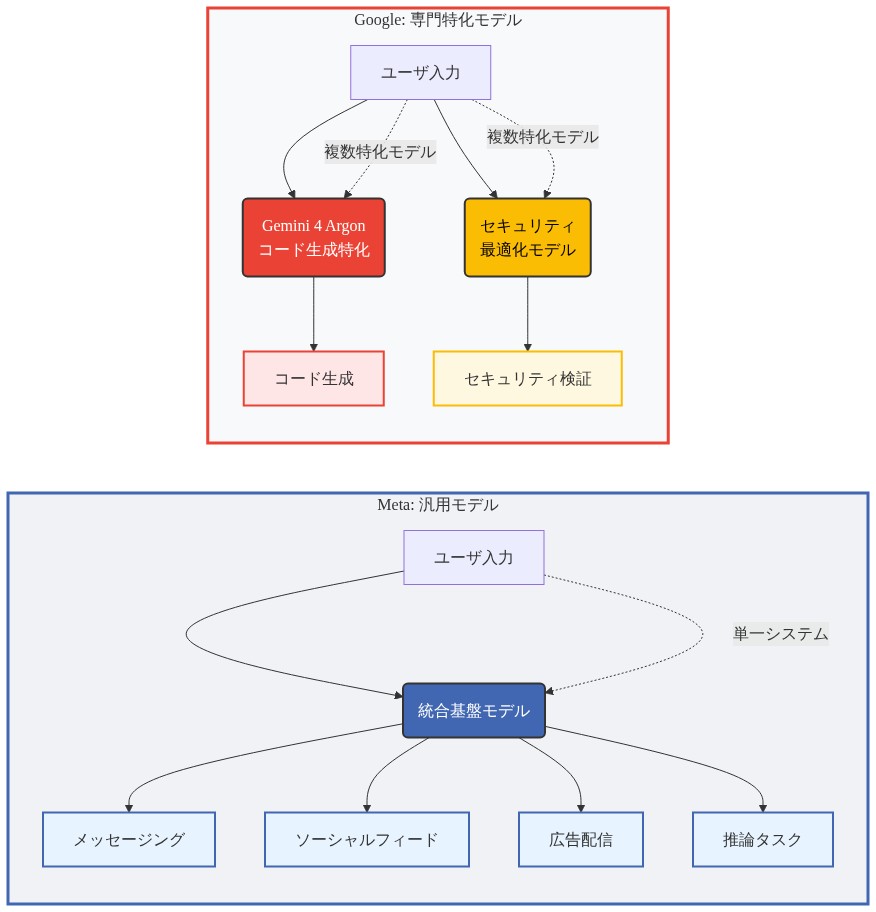
図4:汎用モデル vs 専門特化モデルのアーキテクチャ比較