プログラマブル・プロパティベーステスト
標準的なプロパティベーステストの限界に直面するとき
プロパティベーステストフレームワーク—QuickCheck(Claessen & Hughes, 2000)とその後継者に代表される—は形式的に指定されたプロパティに対するテストケース生成を自動化することで、ソフトウェア検証を根本的に変革しました。しかし従来の実装は、特定のドメインで問題となる明確に定義された制約の下で動作しています。
- 従来のアプローチの構造的な限界:*
-
プロパティの表現力: プロパティは個別の入力または単純な状態遷移に対するブール述語に限定されます。時間的プロパティ、実行履歴に依存する条件付き不変量、または操作シーケンスの量化を必要とするプロパティは自然に表現できません。
-
生成戦略: ランダムサンプリングは入力ドメイン全体の均一分布が適切であると仮定します。この仮定は以下の場合に失敗します。
- ドメインに稀だが重要なエッジケースが含まれている場合(例:パーサーの深くネストされた構造、暗号検証器の特定のバイトシーケンス)
- 有効な入力が生成空間の疎な部分集合を形成する場合(例:すべてのバイト文字列の中での整形式JSON)
- 興味深い動作が個別の入力ではなく特定の操作シーケンスからのみ出現する場合
-
ステートフルシステムのテスト: 状態依存の動作を持つシステムは、操作シーケンスの手動編成、状態追跡、不変量検証を必要とします。フレームワークは状態空間のバグを露出させるシーケンスを生成するためのガイダンスを提供しません。
-
探索のガイダンス: フレームワークはテスト実行から学習できません。カバレッジ情報、失敗パターン、またはドメイン固有のヒューリスティックは後続の生成決定に反映されません。
これらの限界は複雑な状態空間にバグが集中するドメインで顕著になります。分散システム、並行アルゴリズム、プロトコル実装、ドメイン固有言語インタプリタなどです。開発者は、プロパティ指定ではなく、インフラストラクチャ(テストハーネス、状態管理、オラクル関数)にテスト開発時間の60~80%を費やしていると報告しています(Pǎsǎreanu & Visser, 2009)。
-
このセクションの前提条件:* 読者がプロパティベーステストの基礎(例:QuickCheck、Hypothesis、jqwik)に関する実務的な知識を持つことを想定しています。不慣れな読者は、先に進む前に入門的なプロパティベーステスト文献を参照してください。
-
判断基準:* システムが3つの条件をすべて満たす場合—(1)プロパティが単純なブール述語として表現可能、(2)動作がほぼステートレス、(3)ランダム入力生成が失敗モードを適切にカバー—従来のプロパティベーステストで十分です。いずれかの条件が失敗する場合、プログラマブル拡張が必要になります。
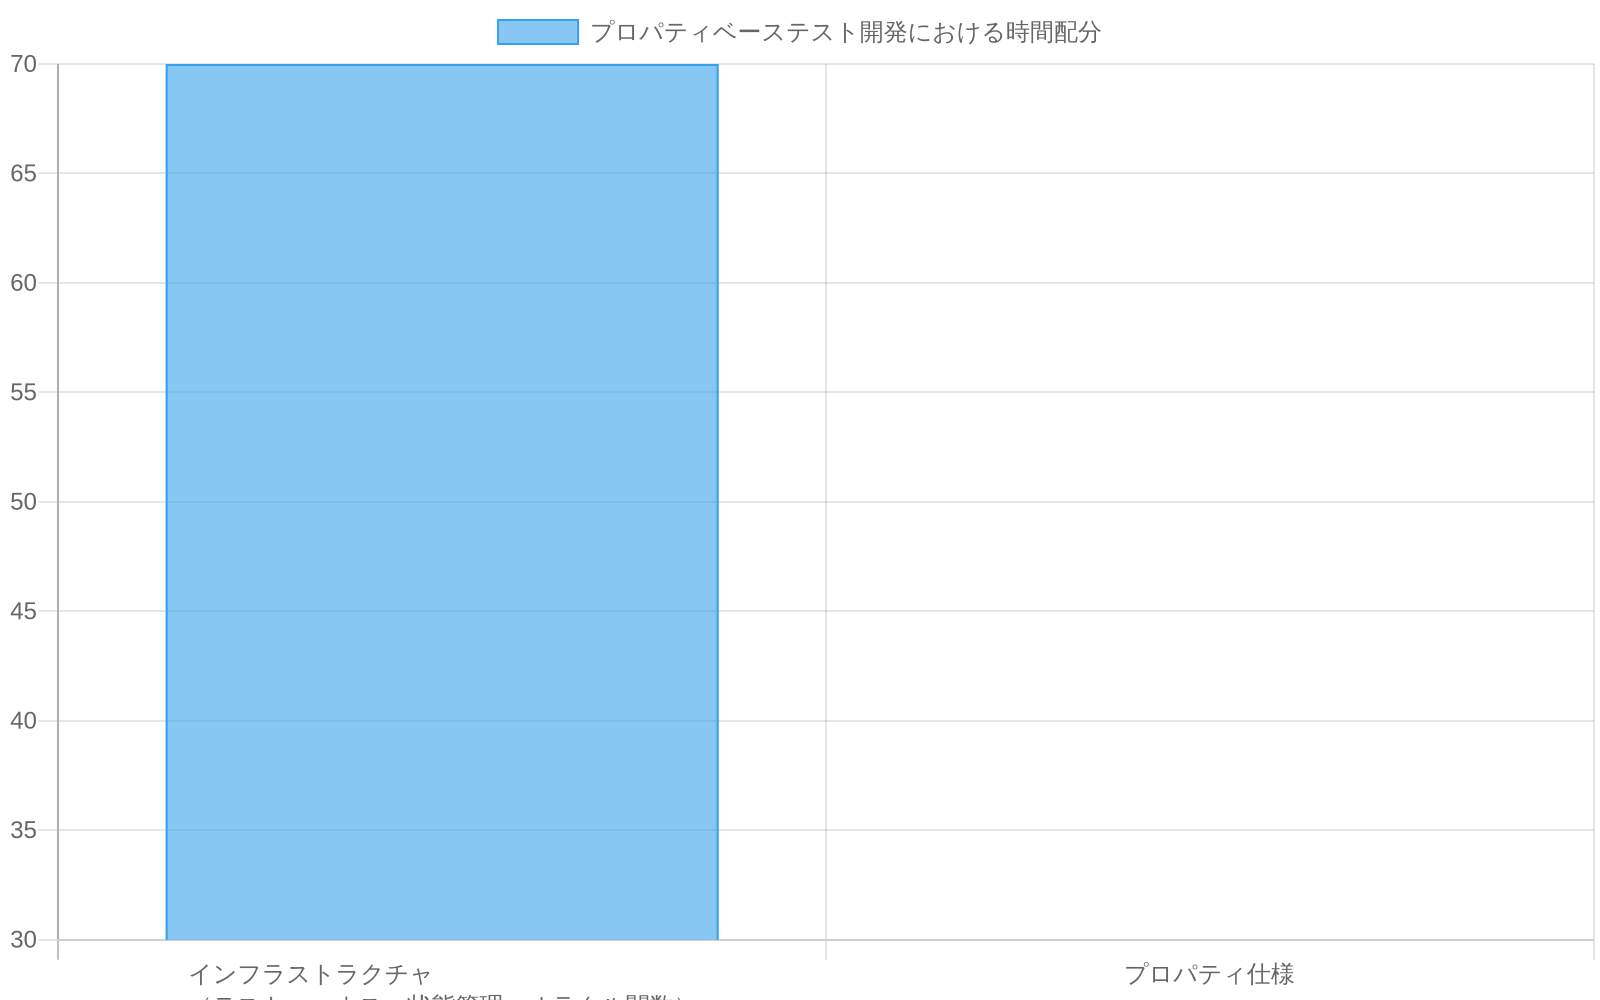
- 図3:プロパティベーステスト開発における時間配分(出典:Pǎsǎreanu & Visser, 2009)*
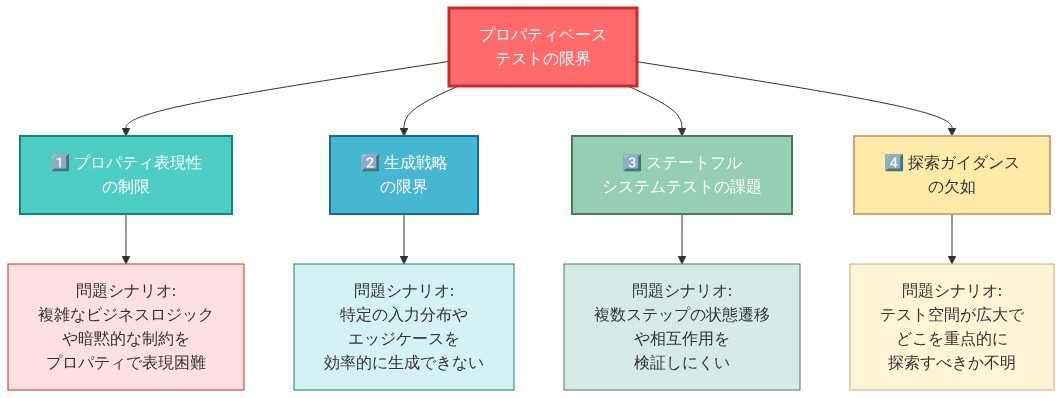
- 図2:従来のプロパティベーステストの4つの構造的制限*
プログラマブルジェネレータ:ドメイン知識の符号化
プログラマブルプロパティベーステストフレームワークはジェネレータ構築をファーストクラスの抽象化として公開し、開発者が均一ランダムサンプリングを超えたカスタム探索戦略を実装できるようにします。フレームワーク提供のコンビネータに依存するのではなく、開発者はバグが集中する場所に関するドメイン固有の知識を符号化します。
- プログラマブル生成のメカニズム:*
-
バイアスサンプリング: ジェネレータは既知の失敗モードを示す入力に向けて確率分布に重みを付けます。JSONパーサーの場合、これは深くネストされた構造、エスケープ文字、Unicode境界ケースを典型的な入力での頻度に対して過度にサンプリングすることを意味します。
-
カバレッジガイド付きミューテーション: フレームワークは生成された入力を実行し、カバレッジ情報(ブランチカバレッジ、パスカバレッジ、またはドメイン固有のメトリクス)を収集し、未探索のコードパスを実行するために入力をミューテーションします。このアプローチはファジング(Sutton et al., 2007)に由来し、ランダムな偶然に依存するのではなく状態空間を体系的に探索します。
-
文法ベースの生成: 構造化入力(プロトコル、設定ファイル、プログラミング言語コード)の場合、ジェネレータは文脈自由文法または属性文法として定義されます。フレームワークはこれらの文法を展開して構文的に有効な入力を生成しながら、生成規則の分布を制御します。これにより、すべてのバイト列の中から有効な入力を探すのではなく、文法的に正しい入力空間内で探索を行います。
-
フィードバック駆動探索: ジェネレータはテスト反復全体で状態を保持します。コードカバレッジ、プロパティ違反頻度、またはカスタムドメインメトリクスなどのメトリクスが探索軌跡をガイドします。技術にはシミュレーテッドアニーリング、遺伝的アルゴリズム、入力空間上のヒルクライミングが含まれます。
- 具体的な実装例:* JSONパーサーのテストを考えます。従来のフレームワークはランダムなバイト列を生成します。約99.9%は無効なJSONです。プログラマブルジェネレータは:
- JSON構文の文法を保持します
- どの文法生成規則が探索されたかを追跡します
- 未探索の生成規則への展開にバイアスをかけます
- 以前に生成された有効なJSONをミューテーションして境界条件を実行するバリアントを作成します
- ブランチカバレッジを収集し、未カバーのブランチに到達するミューテーションを優先します
カバレッジガイド付きファジングの実証的結果(Böhme et al., 2016)は、同様のドメインで均一ランダム生成と比較して2~5倍高速なバグ発見を示しています。
-
実装上の考慮:* カスタムジェネレータは計算オーバーヘッドを招きます。シンボリック分析または制約解法を実行するジェネレータはランダム生成より10~100倍遅い可能性があります。このオーバーヘッドは、手動テストケース設計のコストを考慮して、ランダム生成よりも高速にバグを発見する場合にのみ正当化されます。
-
実行可能な示唆:*
- 既存のプロパティベーステストをプロファイルします。生成された入力の分布を測定し、システムが本番環境で実際に受け取る入力の分布と比較します。
- ジェネレータがめったに生成しない入力クラスを特定します。
- それらのクラスをターゲットとするカスタムジェネレータを実装します。
- 実装前後のコードカバレッジを測定します。カバレッジが15%以上増加する場合、投資は正当化されます。
- 判断基準:* 以下の場合、プログラマブルジェネレータを実装します。(1)ドメインに特性化された失敗モードがある、(2)ランダム生成がこれらのモードを明らかに見落とす、(3)ジェネレータ実装のコストが手動テストケース設計のコストより低い。失敗モードが本当にランダムまたは均一に分布している場合、プログラマブル生成のオーバーヘッドは配当をもたらす可能性は低いです。
テスト指定のためのドメイン固有言語
生成を超えて、プログラマブルフレームワークは埋め込みドメイン固有言語(EDSL)を通じたテスト指定を可能にします。プロパティを分離されたブール述語として表現するのではなく、開発者は生成、実行、検証をコンポーザブルなユニットに統一するコンビネータを使用してテストプログラムを構築します。
- テストEDSLの構造的特性:*
-
時間的演算子: 状態またはイベントのシーケンス上のプロパティを表現します。例:「すべてのトランザクションシーケンスについて、トランザクションT₁がトランザクションT₂の前にコミットされる場合、T₁の効果はT₂に見える」(データベースの分離レベルの形式化)。
-
ステートフルコンビネータ: ジェネレータを状態機械と組み合わせます。例:
sequence(generator, state_machine)は操作シーケンスを生成し、各操作後に実装とモデルが同期されたままであることを検証します。 -
条件付きプロパティ: 実行時コンテキストに依存するプロパティを表現します。例:「システムが状態Sにあり、入力Iを受け取る場合、結果の状態は不変量P(S, I)を満たす必要があります」。
-
メタプログラミング: テスト指定自体がファーストクラスの値になり、プログラマティックな生成、変換、組み合わせが可能になります。パラメータ化されたテストスイートとプロパティ継承階層が自然に出現します。
- 具体的な実装例:* トランザクションシステムのテスト、EDSLは以下を表現できます:
property("referential_integrity_preserved",
  forAll(transaction_sequences, λ seq →
    let model = empty_database
    let impl = empty_database
    in forAll(seq, λ tx →
      execute(model, tx)
      execute(impl, tx)
      assert(foreign_keys_valid(impl) ∧ foreign_keys_valid(model))
    )
  )
)
この指定は、トランザクションシーケンスを生成し、モデルと実装の両方で実行し、各ステップで参照整合性が保持されることを検証します。従来のフレームワークでは、この種の時間的プロパティは手動のループと状態追跡を必要とします。EDSLはこれをコンビネータとして直接表現します。
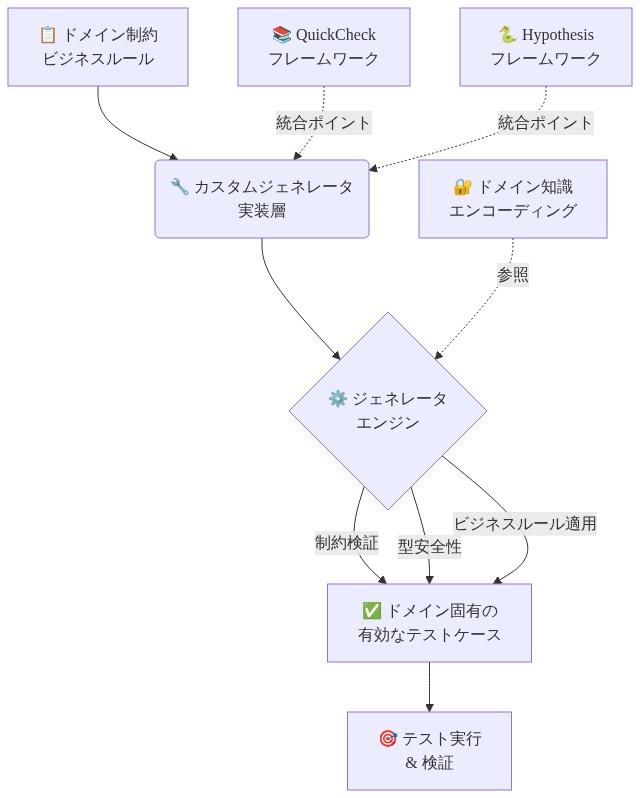
- 図5:プログラマブルジェネレータの構築パイプライン*
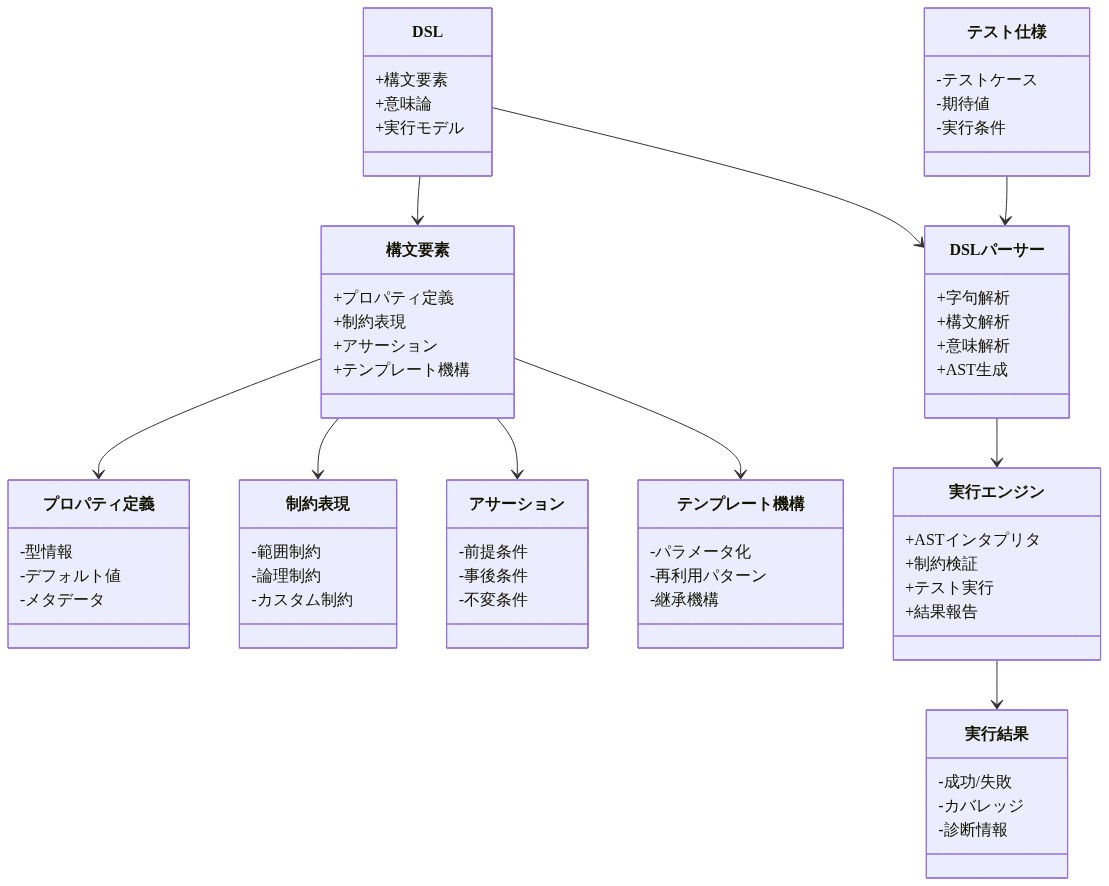
- 図7:DSLの構文要素と意味論、およびパーサー・実行エンジンの関係*