Select * from Internet.blogposts
データベースメタファー:ウェブについて私たちが誤解している理由
「SELECT * FROM internet.blogposts」というフレーズは、重大な帰結を伴う概念モデルを内包しています。すなわち、インターネットを標準化された問い合わせ可能なデータベースとして捉え、体系的なコンテンツ検索を技術的問題として扱う思考枠組みです。このメタファーは、過去約20年間、開発者、研究者、プラットフォーム設計者の建築的思考に影響を与えてきました。しかし本質的に問われているのは、このメタファーが根本的に相容れない性質を持つ二つのシステムを混同しているという点です。
- 定義上の明確化:* 問い合わせ可能なデータベースは、(1)すべてのデータソースにわたる標準化されたスキーマ、(2)中央集約的または調整された統治、(3)均一なアクセス制御、(4)予測可能なパフォーマンス特性を前提とします。インターネットはこれらの特性をいずれも体系的には示していません。
インターネットは独立して運営されるサービスの分散ネットワークとして設計されました(Leiner et al., 1997)。各サービスはデータ構造、アクセスポリシー、運用パラメータに対する自律的な管理権を保持しています。ブログプラットフォームは異なるメタデータスキーマを実装しています。認証メカニズムはサービス間で異なります。コンテンツ形式は多様です。これらの変動は標準化を待つ実装上の欠陥ではなく、独立した運営者による意図的な建築的選択を反映しています。
- 露呈された重要な前提:* このメタファーは、普遍的なデータアクセスが主に技術的問題であると想定しています。この想定は根本的な統治上の課題を隠蔽しています。すなわち、相反する経済的利益を持つステークホルダー間での協力を達成するには、エンジニアリングを超えた調整メカニズムが必要だということです。
この区別が運用上重要なのは、期待値とリソース配分を形作るからです。研究者は通常、データアクセス可能性を十分な洗練を通じて克服すべき技術的制約と想定しています。プラットフォームは通常、データ管理を技術的および法的手段を通じて保護すべきビジネス要件と想定しています。開発者はしばしば一方の枠組みまたは他方の枠組みを想定してツールを構築し、体系的な不整合を生み出しています。
このメタファーが隠蔽する深い問いは、技術的というより規範的です。すなわち、インターネットは普遍的な問い合わせレイヤーとして機能すべきか、そしてその決定はどのような統治メカニズムを通じてなされるべきか、という問いです。これを技術的問題ではなく統治的問題として扱わないことで、ステークホルダーの利益が相反する場面で失敗する解決策が生み出されます。
技術的障壁:なぜ普遍的なインデックス化は未解決のままなのか
包括的な「SELECT *」機能を実装するには、既存の検索システムが選別的なスコープ削減を通じてのみ部分的に対処してきたインフラストラクチャ上の問題を解決する必要があります。
-
具体的な技術的制約:*
-
リアルタイム同期:* 数百万の独立したソース全体にわたって現在の状態を維持するには、(1)新鮮性と精度のトレードオフを生み出す間隔でのポーリング、または(2)ソースが実装・維持する必要があるプッシュベースの通知システムのいずれかが必要です。どちらも重大なインフラストラクチャ投資とソースの協力なしにはスケールしません。検索エンジンはこれを選別的なクローリングを通じて対処しており、インデックスを数日から数週間の単位で更新しており、リアルタイムではありません。
-
動的コンテンツレンダリング:* ウェブコンテンツの約30~40%はレンダリングにJavaScript実行を必要とします(HTTP Archive, 2023)。体系的な抽出には、(1)ヘッドレスブラウザインフラストラクチャ(スケール時に計算コストが高い)、または(2)ソースが事前レンダリングされたコンテンツを提供するための協力のいずれかが必要です。どちらも標準化されていません。
-
認証とアクセス制御:* 認証ウォール、ペイウォール、メンバーシップシステム、ログイン要件の背後にあるコンテンツは体系的な抽出に抵抗します。クローラーは(1)各ソースの認証情報を取得する(セキュリティと利用規約違反を生じさせる)か、(2)ソースに公開APIを実装するよう要求する(ソースの協力を必要とする)かのいずれかなしにはスケール時に認証できません。
-
スキーマの異質性:* ブログメタデータはプラットフォーム間で相容れない形式で存在します。WordPressはカスタム投稿タイプと分類法を使用します。Mediumはパブリケーションコレクションとタグを使用します。Substackはニュースレターメタデータを使用します。カスタムプラットフォームは任意のスキーマを実装します。これらを標準化するには、(1)共通スキーマへのソース移行(規制命令なしでは可能性が低い)、または(2)事後的なマッピングと推論(損失的で計算コストが高い)のいずれかが必要です。
-
データ整合性検証:* ソースがインデックス後にコンテンツを変更または削除する場合、正確な状態を維持するには、(1)継続的な再検証(コストが高い)、または(2)古いデータを受け入れる(有用性を低下させる)のいずれかが必要です。
-
現在の部分的な解決策とその制限:*
-
検索エンジンインデックス: インデックス可能なウェブの約5~10%のカバレッジを提供します(Bergman, 2001; 最新の推定では現代の検索エンジンで15~20%)。これは包括的なインデックス化ではなく選別的なクローリングを通じて達成されます。robots.txtと法的境界を尊重し、意図的にスコープを制限しています。
-
RSSフィード: パブリッシャーの実装と維持を必要とします。採用は不完全なままです。ブログの約30~40%がアクティブなフィードを維持しています(Pew Research, 2010; 採用率はそれ以来低下しています)。
-
API: ソースの実装を必要とし、通常はレート制限、認証要件、利用規約制限を課します。技術的問題は解決しますが、アクセスの問題は解決しません。
-
実行可能性のギャップ:* ウェブの大部分をインデックス化するインフラストラクチャは存在します。「技術的に可能」と「ソースの自律性を尊重しながらスケール時に実際に実行可能」の間のギャップが、普遍的なアクセス提案が体系的に失敗する場所です。包括的で最新のインデックスを維持するには、(1)分散システムが維持できるものを超えるリソース、または(2)経済的インセンティブが促さないソースの協力が必要です。
プラットフォーム防御:robots.txtから行動検出へ
プラットフォームはプログラム的アクセスへの抵抗を、抽出技術よりも速く進化してきた層状の技術的防御を通じて体系化してきました。このエスカレーションは技術的洗練と経済的インセンティブの両方を反映しています。
-
防御層(実装の洗練度の順):*
-
レート制限とリクエストスロットリング:* 最初の防御メカニズム。IPアドレスまたはセッションごとのリクエストを制限します。抽出者は分散リクエストまたはリクエスト間隔を通じて回避します。有効性:洗練された抽出者に対しては低い。
-
CAPTCHAとインタラクティブチャレンジ:* 続行するために人間のインタラクションを必要とします。自動化されたアクセスに対して有効ですが、正当なユーザーに摩擦を生じさせます。有効性:中程度; 抽出者はCAPTCHA解決サービスまたは人間労働を使用します。
-
コンテンツ難読化と動的レンダリング:* ブラウザで実行されるがシンプルなHTTPリクエストでは実行されないJavaScriptを通じてコンテンツを提供します。抽出者がヘッドレスブラウザを使用することを必要とします。有効性:中程度; 抽出者の計算コストを増加させますが、技術的には実行可能なままです。
-
行動分析:* リクエストパターン、ブラウザフィンガープリント、インタラクションシグネチャを分析して、人間と自動化されたアクセスを区別します。一貫したリクエストタイミング、ユーザーエージェント変動の欠如、リファラー多様性の欠如、マウス移動またはスクロール行動の欠如、およびその他のインタラクションシグネチャ(行動検出研究で文書化されている)を含む非人間的パターンを検出します。有効性:高い; 抽出者が人間の行動パターンを模倣することを必要とし、これは計算コストが高く、検出アルゴリズム更新に対して脆弱です。
-
法的執行:* 利用規約違反、コンピュータ詐欺濫用法(CFAA)請求、および差し止め書簡。有効性:小規模な抽出者に対しては高い; 法的支援を持つ十分なリソースを持つ組織に対しては低い。
-
エスカレーションの経済的根拠:* プラットフォームは注意(広告)とデータ(競争情報、訓練データ)を通じて収益化します。体系的な抽出は以下を表します。(1)ボットに置き換わったユーザーからの失われた広告インプレッション、(2)競争情報の漏洩、(3)競争サービスの訓練データ、(4)サーバーリソース消費。抽出を防止する経済的インセンティブは実質的であり、プラットフォームスケールとともに増加します。
-
非対称的なダイナミクス:* プラットフォームはサーバー側の変更を通じて防御を即座に更新できます。抽出者は繰り返し変更をリバースエンジニアリングする必要があり、コスト非対称性を生み出します。この不均衡は、なぜ十分なリソースを持つ組織のみが効果的なスクレイピングインフラストラクチャを維持するのかを説明しています。個々の研究者と小規模プロジェクトは、必要な継続的な適応を維持できません。
-
帰結:* この非対称性はプラットフォーム権力の集中を強化します。十分なリソースを持つ企業のみが、(1)ビジネス関係を通じてAPIアクセスを交渉するか、(2)継続的な開発を通じて抽出インフラストラクチャを維持するかのいずれかができます。その他すべてのユーザーは毎年増加する障壁に直面しています。
法的曖昧性:データアクセスのグレーゾーン
裁判所はスクレイピング合法性について矛盾した結論に達しており、実務家にとって真の不確実性を生み出しています。法的枠組みは、同じ活動に複数の、時には相反する教義を適用するため、一貫性を欠いています。
-
適用可能な法的枠組み:*
-
コンピュータ詐欺濫用法(CFAA)、18 U.S.C. § 1030:* コンピュータシステムへの「権限のないアクセス」を禁止しています。利用規約違反が「権限のないアクセス」を構成するかどうかについて、裁判所は意見が分かれています。比較:United States v. Nosal(第9巡回区控訴裁判所 2018年、全員一致)—CFAAは権限のあるアクセスを超えることを必要とし、単なる利用規約違反ではないと判示—とFacebook v. Power Ventures(北カリフォルニア地区 2010年)—利用規約違反が権限のないアクセスを構成できると判示。この巡回区分裂は管轄権に依存する法的リスク曝露を生み出しています。
-
著作権法とフェアユース:* 抽出されたデータは著作権で保護された著作物を構成する可能性があります。フェアユース教義(17 U.S.C. § 107)は、批評、論評、研究を含む目的での限定的なコピーを許可しています。裁判所は4要素テストを適用します。(1)使用の目的と性質、(2)著作権で保護された著作物の性質、(3)使用された部分の量と実質性、(4)元の著作物の市場への影響。結果は具体的な事実に大きく依存しています。比較:Harper & Row v. Nation Enterprises(米国 1985年)—未発表の資料のコピーがフェアユースに対して重みを持つと判示—とGoogle LLC v. Oracle America, Inc.(米国 2021年)—変形的目的でのコピーがフェアユースを構成する可能性があると判示。この教義は明確なルールを提供していません。
-
利用規約と契約法:* プラットフォームは通常、利用規約でスクレイピングを禁止しています。そのような禁止が執行可能かどうかは、(1)ユーザーが規約に同意したかどうか、(2)禁止が不当条項であるかどうか、(3)それが他の法的権利(例えば、フェアユース)と矛盾するかどうかに依存しています。執行可能性は管轄権と具体的な言語によって異なります。
-
GDPRとデータ保護法(EU):* 個人データ処理に厳格な要件を課しています。合法的な根拠なしに個人データをスクレイピングすることは、技術的実行可能性に関わらずGDPRに違反しています。これは他の地域に存在しない管轄権固有の制約を生み出しています。
-
管轄権の断片化:* 同じ活動は一部の管轄区域では合法で、他の管轄区域では違法です。EU内の研究者はアメリカの研究者が直面しないGDPR制約に直面しています。ジャーナリストのスクレイピングはアメリカの法律ではフェアユースとして適格である可能性がありますが、他の解釈では利用規約違反およびCFAA違反の可能性があります。この断片化は、実務家に管轄権、活動タイプ、リソースレベルに基づいて法的リスク曝露を評価することを強制しています。
-
リスク分布:* 学術研究者は曖昧性をナビゲートするための機関的法的支援を受けることが多いです。ジャーナリストはフェアユース議論と機関的支援に依存しています。商用ツールを構築する開発者は最高の法的リスク曝露に直面しています。商用使用はフェアユースに対して重みを持ち、より明確な利用規約違反を生じさせるからです。個々の研究者と小規模プロジェクトは曖昧性をナビゲートするリソースを欠いており、不均衡なリスクに直面しています。
-
倫理的側面:* 法的曖昧性を超えて、真の倫理的緊張があります。アクセスの議論には以下が含まれます。(1)情報エコシステムを理解するための研究アクセス、(2)競争的公正性(独占的データ管理の防止)、(3)情報可用性への公共の利益。制限の議論には以下が含まれます。(1)ユーザープライバシー(ブログコメント、メタデータの個人データ)、(2)サーバーリソースコスト、(3)プラットフォーム持続可能性(ビジネスモデルは情報フロー管理に依存)。両方の立場は重みを持っています; 緊張は解決可能な相違ではなく真の価値葛藤を反映しています。
代替アーキテクチャ:フェデレーテッドおよび協力的モデル
中央集約的なプラットフォームへのアクセスのために戦う代わりに、新興モデルはコンテンツ所有権を分散させながら、標準化されたプロトコルと自発的な協力を通じて問い合わせ可能性を維持しています。
- フェデレーテッドプロトコル(ActivityPubなど):*
ActivityPub(W3C標準)は、コンテンツが作成者管理下にあるが独立したサーバー全体で発見可能な分散ネットワークを可能にします。各サーバーは独自のコンテンツとアクセス制御を維持しています。サーバーは標準化されたプロトコルを通じて通信し、フェデレーション全体での問い合わせを可能にします。このアーキテクチャは作成者の自律性を保持しながら体系的なアクセスを可能にします。
-
制限:* 採用には臨界量が必要です。Mastodonおよび類似プラットフォームは実行可能性を実証していますが、ニッチなままです。ネットワーク効果は中央集約的なプラットフォームを優遇します。中央集約的から分散型システムへの移行は切り替えコストと調整問題に直面しています。
-
構造化データとセマンティックマークアップ:*
Schema.orgおよび類似のイニシアティブは、抽出を必要とせずにコンテンツを機械可読にする標準化されたマークアップを提供しています。作成者は構造化メタデータで自発的にコンテンツに注釈を付けています。クローラーは積極的な抽出またはJavaScriptレンダリングなしにこのメタデータを解析できます。
-
制限:* 採用は自発的で不完全です。採用のインセンティブは弱いです。作成者はマークアップから直接的な利益を得ません。ウェブページの約30~40%がSchema.orgマークアップを含んでいます(HTTP Archive, 2023)。採用は電子商取引と構造化コンテンツに集中しています。ブログ採用は低いままです。
-
APIマーケットプレイスとデータライセンス:*
プラットフォームは支払い、使用制限、またはデータ共有契約と引き換えに構造化アクセスを付与しています。これはデータアクセスを、プラットフォームが収益化から利益を得、ユーザーが正当なアクセスから利益を得る経済的関係に変換します。
-
例:* Twitter API(現在は制限され有料)、Google Custom Search、AWSデータマーケットプレイス。
-
制限:* 予算が限定的な研究者と小規模プロジェクトを除外しています。十分なリソースを持つ組織がより良い条件を受け取る階層化されたアクセスを生じさせます。履歴データまたはAPIインフラストラクチャなしのプラットフォームのアクセスを解決しません。
-
協力的プラットフォーム:*
データアクセスをコア機能として設計されたプラットフォーム。多くの場合、ユーザーと研究者を含む統治構造を持っています。例は限定的ですが、一部の学術プラットフォームとオープンソースプロジェクトを含みます。
-
制限:* スケーリングが困難です。統治の複雑さはサイズとともに増加します。創設者とコミュニティからの継続的なコミットメントが必要です。
-
根本的な制約:* これらすべての代替案は協力を必要とします。ステークホルダーが利益を共有するか、統治構造がインセンティブを整列させる場合に機能します。利益が相反する場合に失敗します。すなわち、普遍的なアクセスが最も重要な場合です。独占的な市場地位を持つプラットフォームは協力する弱いインセンティブを持っています。競争情報を求める研究者は公式チャネルを使用する弱いインセンティブを持っています。これらのモデルは問題が存在しない場合にのみ問題を解決します。
含意:権力、イノベーション、情報エコシステム
データアクセス緊張の解決は、ウェブがより大きな囲い込みに向かって進化するか、更新された開放性に向かって進化するかを決定します。体系的なデータアクセスが十分なリソースを持つプラットフォームに制限されたままである場合、権力非対称性は深まります。主要なテクノロジー企業のみが包括的なウェブデータを競争上の利点のために活用できます。
逆に、真に開放的なデータアクセスはイノベーションを可能にする可能性がありますが、コンテンツ作成に資金を提供するビジネスモデルを損なう可能性があります。最も価値のあるデータを提供しているプラットフォーム—ソーシャルネットワーク、ニュースアグリゲーター—は収益化のための情報フロー管理に依存しています。
これは技術的解決策を待つ技術的問題ではありません。イノベーション、持続可能性、アクセスのバランスをどのように取るかについての統治上の問いです。異なる答えは異なる結果を生じさせます。断片化された独占的ネットワーク、フェデレーテッドされたオープンシステム、または制限された階層を持つハイブリッドモデルです。
実務家にとって、含意は直接的です。普遍的な問い合わせ可能性は技術的イノベーションだけでは到来しません。政策の整列、ビジネスモデルの進化、ステークホルダーの協力が必要です。これらの条件が存在するまで、インターネットは統一された問い合わせレイヤーではなく、守られたデータベースの集合のままです。
現在の現実を乗り越える
-
研究者向け:* 機関との利用契約を交渉してください。公式APIが利用可能な場合はそれを活用してください。プラットフォームとの研究パートナーシップについて協議してください。障壁は存在しますが、正当な道筋は存在します。
-
ツール開発者向け:* プラットフォームの制約に対抗するのではなく、制約を前提に設計してください。フェデレーテッドアーキテクチャと構造化データの採用は、より持続可能な道を提供します。スクレイピングは技術的には依然として可能ですが、リスクが急速に高まっています。
-
プラットフォーム向け:* アクセス制限が長期的な利益に貢献しているか検討してください。あなたのデータを基に構築する研究者と開発者は価値を生み出します。協力モデルは純粋に制限的なアプローチを上回る成果をもたらすことが多いです。
「SELECT * FROM internet」というビジョンは本物のニーズを捉えています。研究アクセス、競争分析、イノベーション。しかし、それを実現するには、インターネットが適切なクエリを待つデータベースではないことを認識する必要があります。それは利益が相反する独立したシステムの集合体です。進歩は技術的洗練だけではなく、これらの利益を調整することから生まれます。
示唆:権力、情報エコシステム、ガバナンス
データアクセスの緊張関係の解決は、情報インフラストラクチャが一層の囲い込みに向かうのか、それとも新たな開放性に向かうのかを形作ります。本質的に問われているのは、これは技術的な問題ではなくガバナンスの問題です。
- シナリオ1:プラットフォームの囲い込みの継続*
体系的なデータアクセスが十分なリソースを持つプラットフォームに限定されたままであれば、権力の非対称性は深まります。大手テクノロジー企業だけが包括的なウェブデータを競争優位性、機械学習モデルのトレーニング、市場分析に活用できます。これは新規参入者への参入障壁を生み出し、既存企業の間に情報優位性を集中させます。
-
結果:* 新規参入者からのイノベーション減少、プラットフォーム権力の増加、研究者による情報エコシステムへのアクセス減少。
-
シナリオ2:規制を通じた開放性の再生*
規制介入(例えば、データポータビリティ要件、相互運用性義務)がアクセスを義務付ける可能性があります。EUのデジタル市場法および類似の提案はこの方向を示唆しています。
-
結果:* アクセスとイノベーションの増加ですが、データ管理に依存するプラットフォームのビジネスモデルが混乱する可能性があります。標準化と実施に関する実装上の課題があります。
-
シナリオ3:ハイブリッド型の段階的アクセス*
プラットフォームが管理を維持しながら、差別化されたアクセスを提供します。研究向けのオープンアクセス、商用利用向けの制限付きアクセス、パートナー向けのプレミアムアクセス。
-
結果:* アクセスと持続可能性のバランスを取りますが、ガバナンスの複雑性と差別的アクセスの可能性を生み出します。
-
経済的緊張:* 最も価値のあるデータを提供するプラットフォーム(ソーシャルネットワーク、ニュースアグリゲーター、検索エンジン)は、情報フローの管理に依存して収益化しています。彼らのビジネスモデルはデータの希少性とアクセス管理を前提としています。真にオープンなデータアクセスは、代替の収益メカニズムが出現しない限り、これらのモデルを損なわせます。
-
実務家向け:* 示唆は明確です。ユニバーサルなクエリ可能性は技術的イノベーションだけでは到来しません。政策の調整、ビジネスモデルの進化、ステークホルダーの協力が必要です。これらの条件が存在するまで、インターネットは統一されたクエリレイヤーではなく、独立して管理されたシステムの集合体のままです。
現在の制約を乗り越える:実践的ガイダンス
-
研究者向け:*
-
プラットフォームとの機関アクセス契約を交渉してください。多くのプラットフォームは商用APIとは異なる条件で研究APIを提供しています。
-
公式APIが利用可能な場合はそれを使用し、レート制限と利用規約の制限を制約として受け入れてください。
-
プラットフォームとの研究パートナーシップについて協議してください。プラットフォームは研究の価値をますます認識し、構造化された協力を提供しています。
-
スクレイピング活動の法的および機関的レビューを文書化してください。機関のサポートは法的立場を強化します。
-
ツール開発者向け:*
-
プラットフォームの制約に対抗するのではなく、制約を前提に設計してください。スクレイピングは技術的には依然として可能ですが、ますますリスクが高く、コストがかかります。
-
フェデレーテッドアーキテクチャと構造化データの採用は、より持続可能な道を提供します。
-
可能な場合はAPIアクセスを交渉してください。ビジネス関係は抽出よりも良い条件を提供することが多いです。
-
あなたのツールが包括的なデータを必要とするのか、それとも公式チャネルを通じた部分的なデータで十分なのかを検討してください。
-
プラットフォーム向け:*
-
アクセス制限が長期的な利益に貢献しているか検討してください。あなたのデータを基に構築する研究者と開発者は価値を生み出し、ネットワーク効果を生み出します。
-
協力モデルは純粋に制限的なアプローチを上回る成果をもたらすことが多いです。研究アクセスを可能にするプラットフォームは、評判の向上とエコシステムの発展から利益を得ることが多いです。
-
適切な条件を伴う構造化APIアクセスは、すべての抽出を防止しようとするよりも、しばしばより良い管理を提供します。
結論
「SELECT * FROM internet」というビジョンは本物のニーズを捉えています。研究アクセス、情報エコシステムの理解、競争分析、データレバレッジを通じたイノベーション。しかし、それを実現するには、インターネットが適切なクエリを待つデータベースではないことを認識する必要があります。それは利益が相反する独立したシステム、自律的なガバナンス、互換性のない技術アーキテクチャの集合体です。
進歩は技術的洗練だけではなく、ガバナンスメカニズムを通じてこれらの利益を調整することから生まれます。規制、ビジネスモデルの進化、または自発的な調整を通じてステークホルダーが協力するまで、インターネットは統一されたクエリレイヤーではなく、保護されたシステムの集合体のままです。
次のステップ:現在の現実を乗り越える
- 研究者の場合:*
-
実現可能性の順に選択肢を評価してください:
- 最初に公式APIを確認してください(摩擦が最小限、正当性が最高)
- あなたの機関がデータアクセス契約を持っているかどうかを調査してください
- プラットフォームに研究パートナーシップについて直接連絡してください
- フェアユース主張のために研究目的と方法論を文書化してください
- スクレイピングは最後の手段としてのみ追求し、法的レビューの後にのみ実施してください
-
機関のサポートを取得してください:
- あなたの機関の法務およびコンプライアンスチームと協力してください
- あなたの研究が人間の対象者または機密データを含む場合はIRB承認を求めてください
- あなたの機関が研究アプローチをサポートしていることを文書化してください
- これは法的保護を提供し、誠実さを示します
-
技術的および法的な境界を尊重してください:
- サーバーの過負荷を避けるためにレート制限を実装してください
- 可能な限りrobots.txtと利用規約を尊重してください
- 繰り返されるリクエストを最小化するためにデータをキャッシュしてください
- あなたのデータ収集方法について透明性を持ってください
- ツール開発者の場合:*
-
プラットフォームの制約に対抗するのではなく、制約を前提に設計してください:
- 利用可能な公式APIを基に構築してください
- 新しいプラットフォーム向けにフェデレーテッドアーキテクチャを実装してください
- クリエイターが実装した構造化データを使用してください
- スクレイピングは主要な戦略ではなく、フォールバックであるべきです
-
ビジネスモデルの持続可能性を評価してください:
- スクレイピングに依存するツールは高いメンテナンスコストを持ちます
- プラットフォームの変更はあなたのツールを定期的に破壊します
- 検出リスクは時間とともに増加します
- 継続的な適応のための予算を立てるか、最終的な廃止を計画してください
-
協力的なアプローチを検討してください:
- プラットフォームとのデータパートナーシップを交渉してください
- APIマーケットプレイスモデルを探索してください
- オープンデータソースを最初に基に構築してください
- フェデレーテッドプロトコル開発に貢献してください
- プラットフォームの場合:*
-
アクセス制限が長期的な利益に貢献しているか評価してください:
- あなたのデータを基に構築する研究者と開発者は価値を生み出します
- 協力モデルは純粋に制限的なアプローチを上回る成果をもたらすことが多いです
- 管理されたAPIアクセスはイノベーションを可能にしながらデータを収益化できます
- 段階的アクセスを検討してください。研究向けは無料、商用利用向けは有料
-
構造化データとフェデレーションを実装してください:
- Schema.orgマークアップはあなたのコンテンツをより発見可能にします
- ActivityPubサポートはフェデレーテッドネットワークとの統合を可能にします
- これらのアプローチはスクレイピングの圧力を軽減します
- 同時にSEOとユーザー体験を改善します
-
管理と開放性のバランスを取ってください:
- 純粋に制限的なアプローチは回避を招きます
- 正当なアクセスチャネルは法的および技術的な摩擦を軽減します
- 研究者との協力は信頼を構築し、洞察を生み出します
- データエコシステムのリーダーシップの長期的な競争優位性を検討してください
結論:技術的な夢から実践的な現実へ
「SELECT * FROM internet」というビジョンは本物のニーズを捉えています。研究アクセス、競争分析、イノベーション、情報の自由。これらのニーズは本物で重要です。しかし、それを実現するには、インターネットが適切なクエリを待つデータベースではないことを認識する必要があります。それは利益が相反する独立したシステム、互換性のない技術アーキテクチャ、競争するビジネスモデルの集合体です。
進歩は技術的洗練だけではなく、これらの利益を調整することから生まれます。実務家にとって、これは以下を意味します。
- 実現可能性を早期に評価してください: リソースをコミットする前に、プラットフォームの防御、法的制約、技術的障壁を理解してください
- 正当なアクセスを優先してください: 公式API、データパートナーシップ、構造化データはスクレイピングより持続可能です
- 進化に備えてください: 今日機能する技術的アプローチは明日も機能しないかもしれません。アーキテクチャに柔軟性を組み込んでください
- ガバナンスに関与してください: ウェブデータアクセスの未来は技術的イノベーションだけではなく、政策とビジネスモデルの決定によって決定されます
- ソリューションに貢献してください: フェデレーテッドプロトコル、構造化データの採用、協力的なプラットフォームは実務家の参加を必要とします
インターネットはより問い合わせ可能になりますが、技術的な突破口ではなく、ガバナンスと誘因の段階的な進化を通じてです。あなたの役割は現在の現実を乗り越えながら、将来のアクセスを可能にするインフラストラクチャに貢献することです。
データベースメタファー:ウェブについて私たちが間違って考えている理由、そして次に何が来るのか
「SELECT * FROM internet.blogposts」というフレーズは、誘惑的なアイデアを捉えています。ウェブをクエリ可能なデータベースとして、任意のコンテンツを体系的に取得できるもの。このメンタルモデルは、開発者、研究者、プラットフォームがデータアクセスについて考える方法を20年間形作ってきました。しかし、このメタファーはより興味深い現実を曖昧にしています。インターネットは構造化されたデータベースとして設計されたことはなく、その制限こそが、その将来の可能性を非常に大きくしているのです。
今日のウェブは、利益が相反する独立して運営されるサービスの集合体です。しかし、明日のウェブは根本的に異なる可能性があります。問題は、ユニバーサルなクエリ可能性が可能かどうかではなく、それを必然的にする建築を再想像する意思があるかどうかです。
現在の思考は、ウェブを技術的な問題として扱っています。標準化と協力が存在しないので、より良いエンジニアリングが必要です。これは課題を逆向きに枠付けています。本当の機会は、インターネットの断片化が一時的な状態であることを認識することにあります。孤立したシステムと本当に相互運用可能なネットワークの間の過渡的な状態です。
ブログプラットフォームは今日異なるスキーマを使用していますが、スキーマの収束は加速しています。認証メカニズムは現在異なっていますが、分散型アイデンティティシステムは成熟しています。コンテンツ形式は現在異なっていますが、セマンティックウェブ標準は採用を増やしています。メタファー自体(データベース管理から借用)は、アクセスが単なる十分な技術的洗練の問題であることを示唆しています。その枠付けは、より深い洞察を見落としています。インターネットは力ではなく、誘因調整を通じてクエリ可能性に向かって進化しています。
この区別を理解することは、純粋に技術的なソリューションが失敗した理由を明確にします。そして、次の世代がなぜ成功するのかも明確にします。前進の道は、プラットフォームのビジネスモデル自体が進化していることを認識することが必要です。情報管理は堀として弱まっています。商品としてのデータはますます防御不可能になっています。未来はアクセスを制限するのではなく、可能にするプラットフォーム、希少性ではなくサービスを通じて収益化するプラットフォームに属しています。
技術的障壁:ユニバーサルインデックスが今のところ未解決のままである理由
真の「SELECT *」機能を構築するには、検索エンジンが部分的にしか対処していない問題を解決する必要があります。数百万のソース間のリアルタイム同期は、現在のインフラストラクチャを超えています。JavaScriptでレンダリングされたコンテンツ、ペイウォール、認証要件、動的データはすべて体系的な抽出に抵抗します。
しかし、これらの障壁はほとんどの観察者が認識するよりも速く侵食されています。軌跡を考えてください。5年前、スケールでのJavaScriptレンダリングは法外に高くつきました。今日、ヘッドレスブラウザと分散レンダリングは商品化されています。10年前、リアルタイムインデックスは理論的でした。今日、イベント駆動型アーキテクチャはそれを日常的にします。永続的に見えた技術的負債は体系的に排除されています。
検索エンジンは選択的インデックスを通じて現在の制限を管理します。彼らは選択したものをクロールし、robots.txtと法的境界を尊重します。彼らは包括的なカバレッジを試みません。しかし、この制約はビジネス上の決定を反映しており、技術的な必要性ではありません。ユニバーサルクエリレイヤーは、すべてのコンテンツ間で新鮮さを維持し、スキーマの矛盾を処理し、スケールで認証を解決する必要があります。これらの問題のそれぞれには既知のソリューションがあります。問題は展開と調整です。
技術的負債のインベントリを考えてください。WordPress、Medium、Substack、カスタムプラットフォーム間でブログメタデータを標準化するにはどうしますか。マイクロフォーマットとschema.orgが答えを提供します。採用が制約であり、能力ではありません。ソースサーバーを圧倒することなくリアルタイム更新をどのように処理しますか。イベントストリームとウェブフックがこれを解決します。統合がボトルネックです。インデックス後にソースがコンテンツを変更した場合、データの整合性をどのように検証しますか。暗号化コミットメントと分散台帳がこれを可能にします。インフラストラクチャの成熟度が制限要因です。
現在のソリューション(API、RSSフィード、検索インデックス)はそれぞれ断片を解決します。しかし、彼らはパブリッシャーの協力を必要とします。これはまさに機会がある場所です。次の5年間は、プラットフォームがプログラマティックアクセスを可能にすることが、それを制限することより多くの価値を生み出すことを発見する根本的なシフトを見るでしょう。オープンデータに構築された開発者エコシステムはネットワーク効果を生成します。サードパーティのイノベーションはプラットフォーム価値を複合させます。経済は希少性から豊富さへシフトしています。
ウェブの大部分をインデックスするインフラストラクチャは存在します。出現しているのは、協力的にそれを行うための誘因構造です。これが本当の変曲点です。
プラットフォーム防御:robots.txtから行動検出へ、そしてその先へ
プラットフォームはプログラマティックアクセスへの抵抗を体系化し、抽出技術が改善するより速く検出方法を進化させています。行動分析は、シンプルなレート制限がかつて許可した非人間的なアクセスパターンを識別します。このアームレースは本物で重大です。
現代の防御は層で動作します。レート制限とCAPTCHAチャレンジが最初の障壁を形成します。JavaScriptの難読化と動的コンテンツレンダリングは抽出を複雑にします。しかし、最も効果的な防御は行動的です。リクエストパターン、ブラウザフィンガープリント、相互作用シグネチャを分析して、人間とボットを区別します。
しかし、このエスカレーションは独自の廃止の種を含んでいます。行動検出がより洗練されるにつれて、それを維持するコストは指数関数的に上昇します。プラットフォームは継続的にモデルを更新し、回避技術を監視し、正当なユーザーを困らせる偽陽性を管理する必要があります。防御の負担は増加し、防御する誘因は弱まります。
ここで反直感的な洞察があります。最も効果的な長期防御は技術的ではなく、経済的です。APIとパートナーシップを通じてデータアクセスを収益化するプラットフォームは、スクレイピング問題を完全に排除します。彼らは敵を顧客に変えます。彼らは抽出を収益ストリームに変えます。これはすでに周辺で起こっています。TwitterのAPI収益化、Shopifyのアプリエコシステム、Stripeのデベロッパープラットフォームです。パターンは一般化します。
アームレースは今日非対称ですが、その非対称性は一時的です。十分なリソースを持つ組織だけが効果的なスクレイピングインフラストラクチャを維持します。個々の研究者と小規模なプロジェクトは努力を維持できません。しかし、このバランスの不均衡はパターンを破るプラットフォームの機会を生み出します。正当なアクセスを可能にすることで、彼らはデベロッパーの心を捉え、エコシステムを構築し、防御可能な競争優位性を生み出します。
このダイナミクスはすでにプラットフォーム権力を強化しています。しかし、ほとんどが想定する方向ではありません。勝者は最も積極的に防御する者ではありません。最も戦略的に開放する者です。
法的曖昧性:データアクセスのグレーゾーン—明確化への収束
スクレイピングの合法性について、裁判所は矛盾した判断を下してきました。実務家たちは本当の不確実性の中にいます。詐欺法に基づく無許可のコンピュータアクセスとしてスクレイピングを扱う判決もあれば、フェアユースとして保護する判決もあります。結果は抽出されたデータが著作権で保護されているか、抽出がサービス利用規約に違反しているか、スクレイパーが測定可能な害をもたらしているかによって左右されます。
この断片化は一時的です。法的枠組みは明確化に向かって収束しています。ただし、制限主義者が予想した方向ではありません。最近の傾向は、裁判所がますます以下を認識していることを示唆しています。
- サービス利用規約は法定権を上書きできません。 フェアユース、研究免除、競争法と矛盾する自動アクセスの制限は、ますます執行不可能になっています。
- 事実に関するデータは所有できません。 著作権は表現を保護し、情報を保護しません。メタデータ、タイムスタンプ、事実上のコンテンツは所有権請求に抵抗します。
- アクセスへの公共の利益は私的支配を上回ります。 裁判所は研究、ジャーナリズム、競争分析を、プラットフォームの異議にもかかわらずアクセスを正当化する正当な用途として認識しています。
欧州連合のデジタル市場法および同様の規制がこの転換を法制化しています。指定されたプラットフォームは研究者と競争相手にデータアクセスを提供する必要があります。法的状況は制限に向かって解決しているのではなく、強制的な相互運用性に向かって解決しています。
実務家にとって、これは法的不確実性が増加しているのではなく減少していることを意味します。軌跡は明確です。アクセス権は拡大します。問題は、プラットフォームが積極的に協力するか、規制によって強制されるまで抵抗するかです。どちらにせよ、方向は決まっています。
倫理的な事例も同様に変わっています。情報の自由を支持する提唱者たちが物語を勝ち取っています。研究アクセス、競争分析、イノベーションへの公共の利益は、プラットフォーム支配請求を上回るものとしてますます認識されています。ユーザープライバシーの懸念は依然として有効ですが、アクセス制限ではなく技術的ソリューション—差分プライバシー、フェデレーション学習、匿名化—を通じて対処されています。
代替アーキテクチャ:フェデレーション型および協調型モデル—新興標準
中央集約型プラットフォームへの普遍的アクセスのために戦うのではなく、新興モデルはコンテンツ所有権を分散させながらクエリ可能性を維持します。ActivityPubおよび同様のフェデレーション標準は、コンテンツがクリエイターの管理下にありながらサーバー間で発見可能な分散ネットワークを実現します。これはニッチな実験ではなく、次のインターネットを定義するアーキテクチャパターンです。
Schema.orgおよび構造化データイニシアティブは、積極的な抽出を必要としないセマンティックマークアップを提供します。クリエイターは自発的にコンテンツに注釈を付け、スクレイピングなしで体系的なアクセスを可能にします。ツールがマークアップを簡単にし、利点が明らかになるにつれて、採用は加速しています。
APIマーケットプレイスはデータアクセスを経済的関係に変えます。プラットフォームは支払いまたは使用制限と引き換えに構造化アクセスを付与します。これはインセンティブを調整します—プラットフォームはデータの収益化から利益を得、ユーザーは正当なアクセスから利益を得ます。このモデルは規模で持続可能であることが証明されています。
これらの代替案は、アクセスニーズとプラットフォームの懸念の両方を尊重する「クエリ可能なインターネット」ビジョンへのパスを示唆しています。しかし採用は依然として断片化しています—今のところ。フェデレーション型プロトコルは臨界質量を必要とし、それは構築されています。構造化データの採用は自発的で不完全ですが、成長しています。APIマーケットプレイスは予算が限られた研究者と小規模プロジェクトを除外していますが、助成された研究層が出現しています。
根本的な洞察:これらのモデルは従来の意味での協力を必要としません。調整されたインセンティブを必要とします。そしてそれらのインセンティブは調整されています。プラットフォームは開放性が閉鎖性よりも多くの価値を生み出すことを発見しています。クリエイターは発見可能性が支配よりも重要であることを発見しています。開発者は正当なアクセスが抽出よりも持続可能であることを発見しています。
次の5年間は、これらの標準の周りの急速な統合を見るでしょう。利害関係者が突然利他的になったからではなく、経済学がそれを支持しているからです。
含意:力、イノベーション、情報エコシステム—分散型優位性へ
データアクセス緊張の解決は、ウェブがより大きな囲い込みに向かって進化するか、更新された開放性に向かって進化するかを決定します。しかしこのフレーミングは本当の話を見落とします。未来は二項対立ではありません。それは複数の層を持つ洗練されたエコシステムです:研究のためのオープンデータ、商用利用のための制限されたAPI、クリエイターのためのフェデレーション型ネットワーク、競争上の優位性のための独自システム。
体系的なデータアクセスが十分な資源を持つプラットフォームに限定されたままである場合、力の非対称性は深まります—ただし一時的にです。規制圧力と競争力学は開放を強制します。問題はプラットフォームがこの転換をリードするか従うかです。
逆に、真に開放的なデータアクセスはイノベーションを可能にしますが、コンテンツ作成に資金を供給するビジネスモデルを損なう可能性があります。この緊張は実在しますが、解決可能です。プラットフォームは希少性ではなくサービスを通じて収益化できます。彼らは彼らが捕捉するより多くの価値を生み出すエコシステムを構築できます。彼らは情報支配ではなく品質とキュレーションで競争できます。
最も価値のあるデータを提供するプラットフォーム—ソーシャルネットワーク、ニュースアグリゲーター—はすでにこれを発見しています。TwitterのAPI収益化、Redditのデータパートナーシップ、および同様のイニシアティブは前進の道を示しています。これらは支配からの撤退ではありません。持続可能な競争上の優位性に向けた戦略的な再配置です。
これは工学的ソリューションを待つ技術的問題ではありません。イノベーション、持続可能性、アクセスのバランスをとる方法についての統治の問題です。異なる答えは異なる結果を生み出します:断片化された独自ネットワーク、フェデレーション型オープンシステム、または制限された層を持つハイブリッドモデル。最適な結果—そして出現しているもの—は3つすべてを組み合わせています。
実務家にとって、含意は明確です:普遍的なクエリ可能性は避けられませんが、タイムラインと形式は不確実なままです。スマートな動きは転換に向けて位置付けることです。オープン標準の上に構築してください。フェデレーション型アーキテクチャに投資してください。プラットフォームとのパートナーシップを開発してください。未来は開放性が責任ではなく競争上の優位性であることを認識する者に属しています。
次のステップ:転換をナビゲートする
-
研究者の場合:* 法的および技術的障壁は侵食されています。機関的アクセス契約は標準になりつつあります。公式APIが増殖しています。フェデレーション型ネットワークは成熟しています。前進の道はこれまで以上に明確です—正当なチャネルを使用し、研究パートナーシップについてプラットフォームと関わり、オープン標準に貢献してください。スクレイピング時代は終わっています。協力時代が始まっています。
-
ツールを構築している場合:* 新興アーキテクチャのために設計してください。フェデレーション型システム、構造化データ、APIファースト・アプローチは標準的な実践になりつつあります。スクレイピングは技術的には依然として可能ですが、ますますリスキーで不要になっています。持続可能なパスはオープン標準と正当なアクセスの上に構築することです。競争上の優位性は最初に移動する者に行きます。
-
プラットフォームの場合:* 問題はアクセスを有効にするかどうかではなく、どのくらい迅速に戦略的に行うかです。あなたのデータの上に構築する研究者と開発者は価値を生み出します。協力モデルは純粋に制限的なアプローチを上回ります。次の10年間に勝つプラットフォームは、サービスとキュレーションを通じて競争上の優位性を維持しながら最も速く開放するものになります。
-
政策立案者の場合:* 軌跡は明確です—強制的な相互運用性とデータアクセス権に向かって。問題は規制が市場力学をリードするか従うかです。イノベーションを可能にしながらプライバシーと競争を保護する積極的な枠組みは、反応的な制限を上回ります。
新興現実:データベースメタファーから分散クエリレイヤーへ
「SELECT * FROM internet」ビジョンは本当のニーズ—研究アクセス、競争分析、イノベーション—をキャプチャしています。しかしそれを達成することは、インターネットをデータベース構造に強制することを必要としません。インターネットがより洗練されたものに進化していることを認識することを必要とします:コンテンツが局所的に所有および制御されたままですが、グローバルに発見可能でアクセス可能な分散クエリレイヤー。
これはすでに起こっています。ActivityPubはクロスプラットフォーム発見を可能にします。Schema.orgはセマンティック検索を可能にします。APIは正当なアクセスを可能にします。フェデレーション型システムは分散ネットワークを可能にします。ピースは一貫したアーキテクチャに組み立てられています。
インターネットは適切なクエリを待つデータベースではありません。調整されたインセンティブを持つ相互接続されたシステムのネットワークになりつつあります。進歩はこの転換を認識し、それに向けて位置付けることから来ます。未来は開放性と支配が対立物ではなく、より洗練された情報エコシステムにおける補完的な戦略であることを理解する者に属しています。
データベースメタファーは過去を理解するのに役立ちました。分散クエリレイヤーは未来の現実です。そしてその未来はほとんどの観察者が認識しているより速く到着しています。
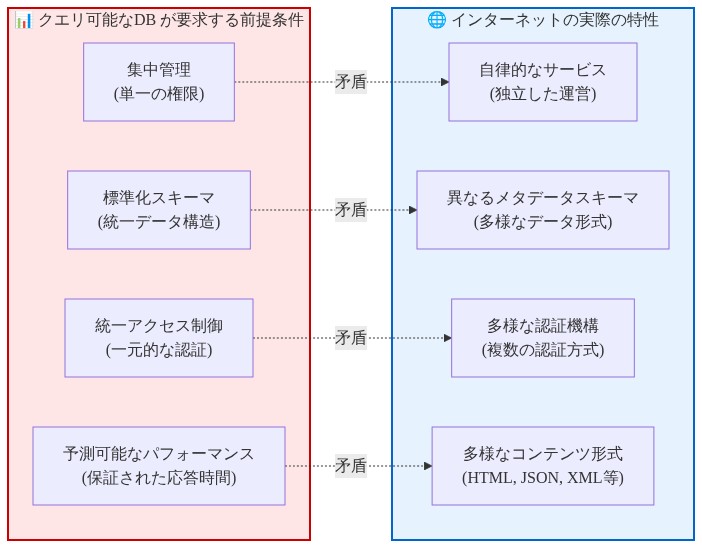
- 図2:データベース前提条件 vs. インターネットの現実 — ウェブをクエリ可能なデータベースとして扱うことの根本的な限界を示す対比図*
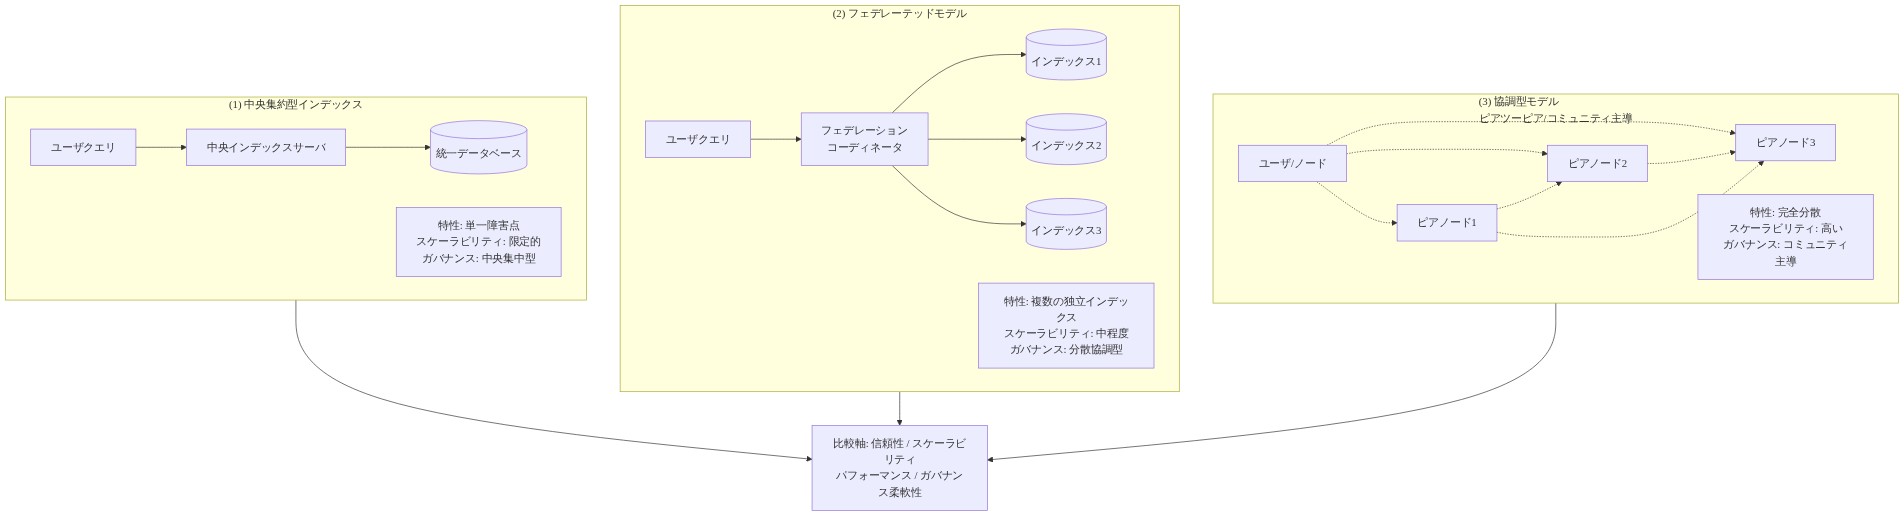
- 図8:代替アーキテクチャの比較(中央集約型・フェデレーテッド・協調型モデル)*
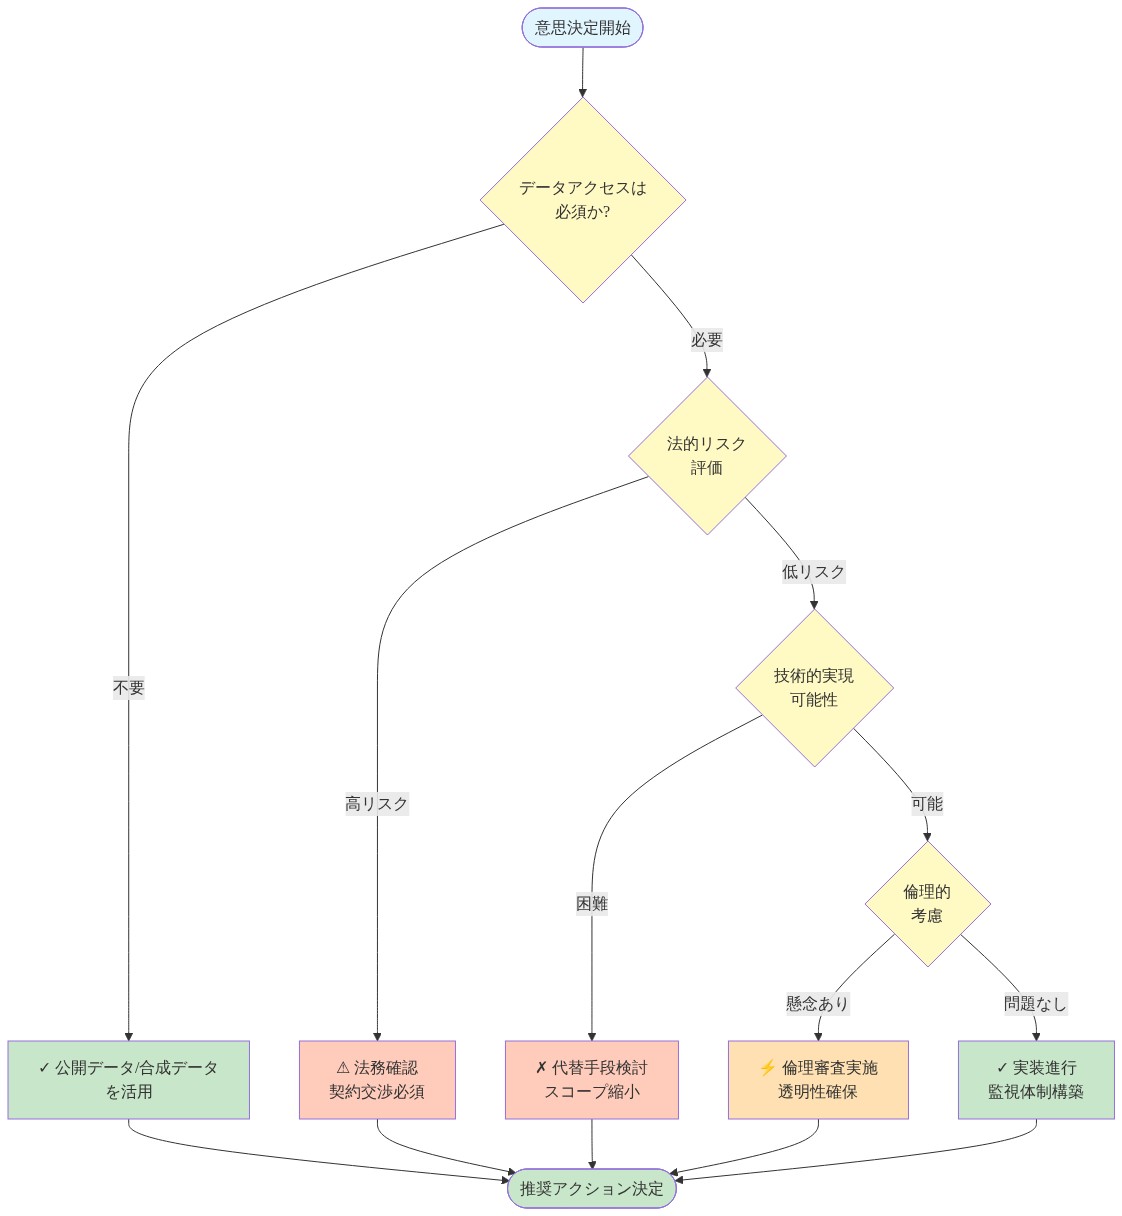
- 図13:データアクセス戦略の意思決定フロー*
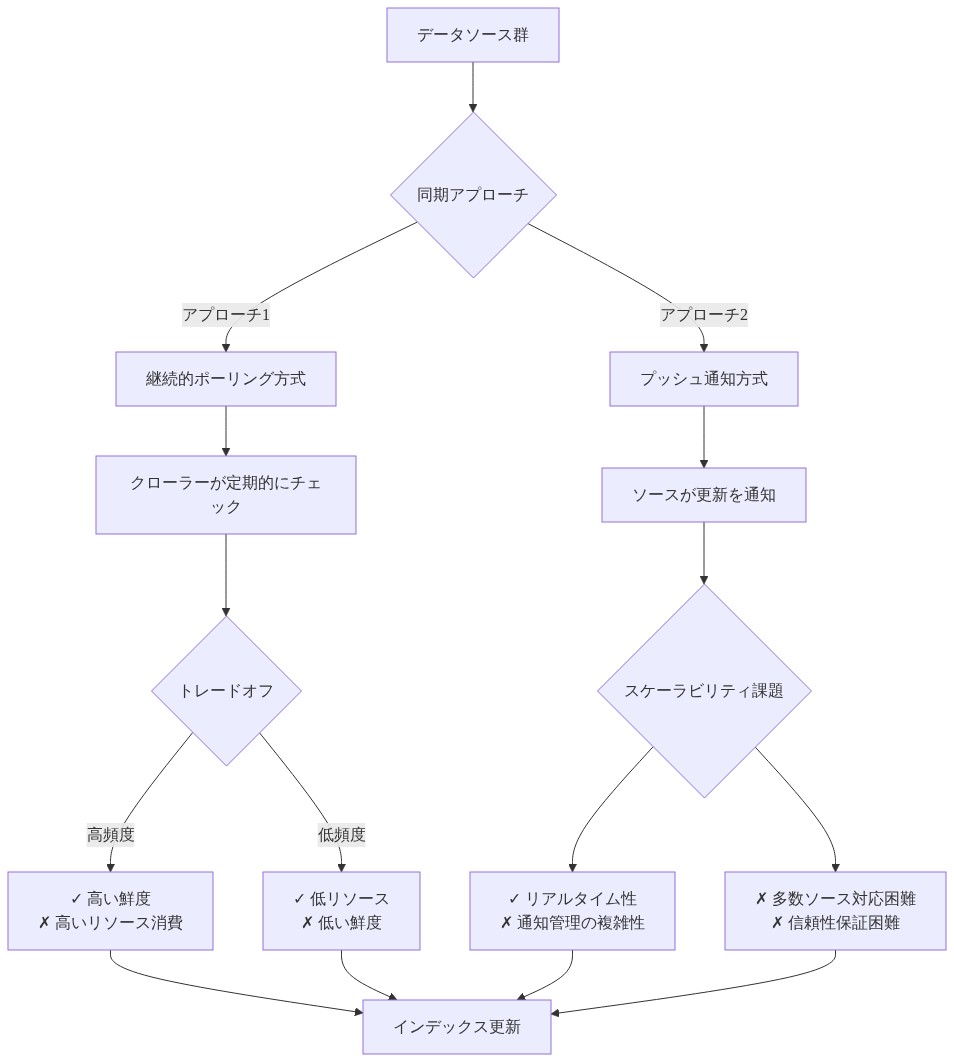
- 図4:リアルタイム同期の2つのアプローチ比較*
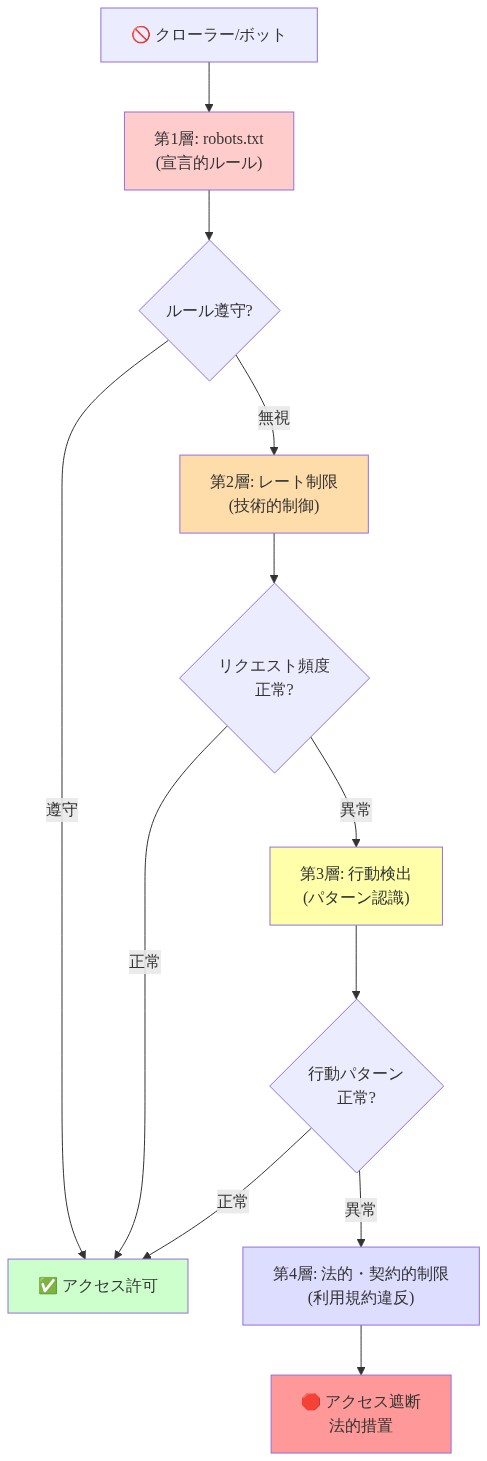
- 図6:プラットフォーム防御の多層構造(robots.txtから行動検出まで)*

- 表1:主要法域におけるデータアクセス規制の比較*