スペクトラル・ターゲット物理潜在構造化によるJEPAスタイルワールドモデル
潜在ワールドモデルが動的環境で失敗するのはなぜか
潜在ワールドモデルは、高次元観測空間での計画立案のための支配的な計算手法となっています。その中核的な前提は、生の感覚データではなく圧縮された潜在表現において学習と計画立案を行うことで、計算オーバーヘッドを削減しながら意思決定に必要な十分な忠実度を維持するというものです(LeCun et al., 2022; Ha & Schmidhuber, 2018)。知覚(エンコーディング)と動力学(予測)の関心の分離は、ロボティクスとシミュレーション領域全体で有効性が実証されています。
しかし実運用での展開は、表現崩壊とは異なる体系的な失敗モードを明らかにします。スペクトラル正則化(SIGReg)やその他のスペクトル制約を含む最新の正則化技術は、エンコーダが多様な観測を単一の点にマッピングするのを防ぐのに成功しています(Goroshin et al., 2015)が、二次的な失敗が生じます。それは物理表現の怠惰性です。これは潜在空間が低い再構成誤差を達成しながら、同時に高度に動的な環境での正確な多段階予測に必要な正確な空間的および時間的動力学を体系的に優先度を下げるか破棄する場合に発生します。
-
メカニズム的な区別:* 崩壊した表現はすべてのタスク全体で即座に失敗します。怠惰な表現は主要な目的(フレーム再構成または1ステップ予測)では成功しながら、タスク上重要な情報(フレーム間速度、接触力、変形状態、または状態不連続性)を静かに破棄します。モデルの損失関数は減少しますが、計画立案への有用性は低下します。
-
具体的な現れ方:* 可変速度のオブジェクト運動、衝突、弾性変形を伴うロボット操作タスクを考えてください。標準的な潜在ワールドモデルは、保留されたテストフレームで低い次フレーム予測誤差(MSE < 0.05)を達成します。しかし計画立案に使用される場合、10ステップ以上先を予測するか、潜在ロールアウトに基づいてアクション選択を条件付けする場合、モデルは急速な方向変化または接触イベントを伴う軌跡で壊滅的に失敗します。エンコーダは速度を低優先度信号として扱うことで情報を効率的に圧縮することを学習しました。平均位置は予測可能であるため再構成損失は低いままですが、正確な動力学は失われます。
この失敗モードは、計画立案が潜在軌跡の忠実度に依存する予測後行動アーキテクチャ(Hafner et al., 2023; Dreamer-v3)で特に深刻です。次フレーム誤差の5%改善は、その改善が速度情報の破棄から生じる場合、計画立案成功の50%低下に対応する可能性があります。
- 診断基準:* 展開前に、2つの異なるテストセットでモデルパフォーマンスを評価してください。(1)滑らかで予測可能な遷移(低加速度、接触なし)、および(2)エッジケース(急速な方向変化、衝突、状態不連続性)。両方で予測誤差は低いままですがエッジケースでアクション品質が低下する場合、表現怠惰性が不十分なモデル容量ではなく原因である可能性が高いです。
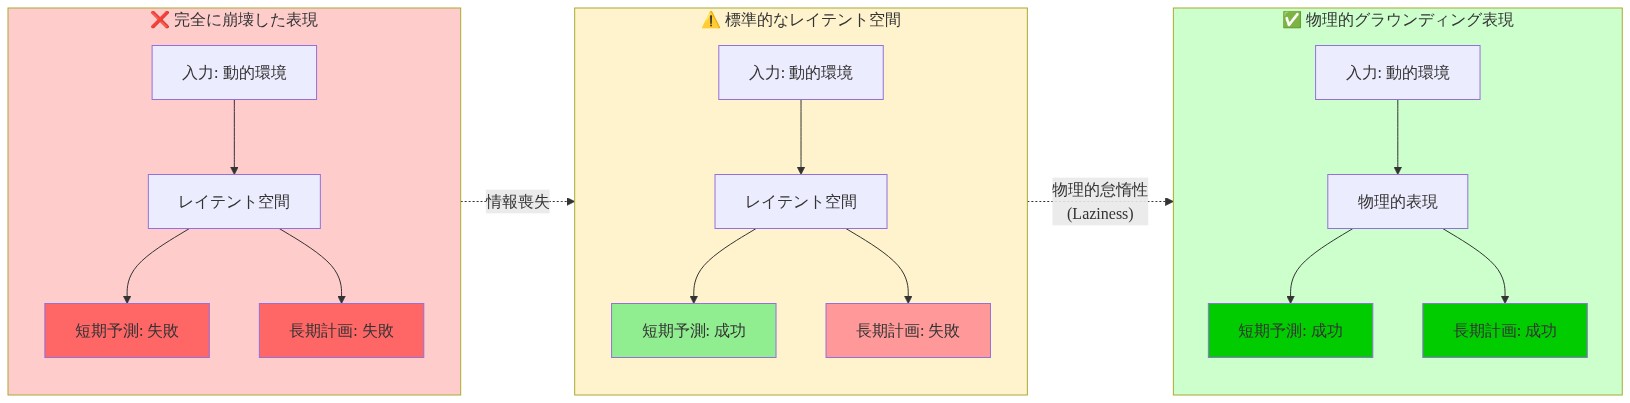
- 図2:表現崩壊 vs 物理的怠惰性 vs 物理的グラウンディングの比較*
スペクトラル・ターゲット構造化を異なるものにするのは何か
スペクトラル・ターゲット物理潜在構造化(STPLS)は、潜在次元がどの物理特性をエンコードするかを明示的に制約することで怠惰性に対処します。エンドツーエンド正則化に依存するのではなく、STPLSは潜在空間を意味論的に根拠のあるチャネルに分割します。位置、速度、回転、接触状態、および変形可能性です。
メカニズムは直接的です。補助ヘッドは潜在埋め込みから物理量を直接予測し、地上真実物理または微分可能シミュレータに対して教師あり学習されます。エンコーダは再構成誤差に対してだけでなく、予測に重要な物理特性をエンコードできなかったことに対してペナルティを受けます。
これはエンコーダ予測子ヤコビアンの特異値分布を制約するスペクトラル正則化とは根本的に異なります。STPLSは意味論を制約します。潜在空間を解釈可能で物理的に根拠のあるものにすることを強制します。2つのアプローチは相互に補完します。スペクトラル正則化は崩壊を防ぎ、STPLSは怠惰性を防ぎます。
-
具体的な例:* ボール投げタスクでは、STPLSはボール位置(xyz)、速度(vx、vy、vz)、および空気抵抗に潜在次元を専用にします。エンコーダはすべてのフレーム全体でこれらの次元を情報提供し続ける必要があります。標準的なモデルはこれを区別されない「ボール状態」に圧縮し、精度を失う可能性があります。STPLSは精度を交渉不可能にします。
-
実装チェック:* 学習された埋め込みを抽出し、地上真実物理量を予測するために線形プローブを適合させます。精度が95%未満に低下する場合、モデルは怠惰です。失敗している次元に補助教師あり学習を導入します。
物理的根拠付けはトレーニング動力学をどのように変えるか
補助物理教師あり学習の導入は、最適化ランドスケープを根本的に変えます。STPLSなしでは、エンコーダは単一の複合損失を最小化します。再構成または予測誤差です。STPLSでは、エンコーダは複数の目的を同時に満たす必要があります。情報を圧縮し、物理を保存し、正確な予測を可能にし、視覚的変動に対してロバストなままでいることです。
-
多目的緊張:* これは有益な制約を作成します。エンコーダは次元削減のために速度情報を破棄することはできません。速度予測ヘッドはその教師あり学習に失敗し、勾配はエンコーダに流れ戻ります。逆に、エンコーダは生のピクセル空間速度をエンコードすることはできません。照明、テクスチャ、カメラアングル全体で転移する抽象的で一般化可能な表現を学習する必要があります。エンコーダは中間地点を見つけることを強制されます。物理的に忠実なままである圧縮表現です。
-
トレーニング手順:* 前方パスは以下のように進行します。
- フレーム $x_t$ を潜在 $z_t = \text{Enc}(x_t)$ にエンコードします
- 次の潜在状態 $\hat{z}_{t+1} = \text{Pred}(z_t, a_t)$ を予測します($a_t$ はアクション)
- 潜在をピクセルにデコードします $\hat{x}{t+1} = \text{Dec}(\hat{z}{t+1})$
- 再構成損失を計算します $\mathcal{L}{\text{recon}} = |x{t+1} - \hat{x}_{t+1}|^2$
- 潜在から物理量を抽出します。各物理特性 $i$ に対して $\hat{p}_i = \text{Head}_i(z_t)$
- 物理損失を計算します $\mathcal{L}_{p_i} = \text{Loss}_i(\hat{p}_i, p_i^{\text{gt}})$。ここで $p_i^{\text{gt}}$ は地上真実です
- 結合損失 $\mathcal{L}_{\text{total}}$ をエンコーダ、予測子、デコーダを通じて逆伝播します
-
損失重み付け:* 経験的チューニングは物理教師あり学習が総損失の20~40%を構成すべきことを示唆しています。物理重みが高すぎる場合(>50%)、モデルは物理ラベルに過剰適合し、視覚分布シフト下で失敗する脆い表現を学習する可能性があります。物理重みが低すぎる場合(<15%)、エンコーダは怠惰性に戻ります。物理ヘッドは失敗しますが、それらの弱い勾配はエンコーダを再形成するのに不十分です。最適な範囲はデータセットサイズと物理ラベル品質に依存します。保留された動的テストセットでのクロスバリデーションが必要です。
-
具体的な例:* プッシングタスクでは、モデルは接触状態をエンコードする潜在次元が遮蔽全体で安定したままである必要があることを学習する必要があります。ロボットハンドがオブジェクトを遮蔽する場合、ピクセルベースの信号は消えますが、潜在接触状態は遮蔽後の運動の正確な予測を可能にするために持続する必要があります。接触予測ヘッドはこの制約を強制します。潜在が遮蔽中に崩壊する場合、接触予測は失敗し、勾配はエンコーダに流れ戻り、崩壊にペナルティを与えます。これは暗黙的な正則化効果を作成します。エンコーダは直接観測可能でない場合でも接触状態情報を維持することを学習します。
-
収束特性:* STPLSトレーニングは通常、補助損失のため標準潜在ワールドモデルより遅く収束します(10~20%の追加ウォールクロック時間)。しかし最終モデルは動的テストセットで低い予測誤差を示し、計画立案成功率が高く、追加トレーニングコストが改善された表現品質によって正当化されることを示唆しています。
信頼できる展開を可能にする運用パターンは何か
STPLSは信頼できる展開のために対処する必要がある新しい運用要件を導入します。まず、トレーニング中に地上真実物理または微分可能シミュレータが利用可能である必要があります。これはロボティクス(ジョイントエンコーダと力センサが状態を提供)、シミュレーションベースの学習、および制御された実験室設定で実行可能です。しかしこの要件は、追加インフラストラクチャ(例えば、ポーズ推定パイプライン、物理推論モデル)なしでビデオのみの設定への適用可能性を制限します。
第二に、潜在空間は分布シフト下で物理的に根拠のあるままである必要があります。モデルが訓練分布外の視覚的変動または動力学に遭遇する場合です。表現ドリフトはドメイン適応における既知の失敗モードです。STPLSはこのリスクを排除しませんが、物理ヘッド監視を通じて検出可能にします。
- 展開プロトコル:*
-
トレーニング段階: 複数の視覚条件、オブジェクトタイプ、および動力学レジームにわたる多様なデータセットでSTPLSをトレーニングします。保留されたテストセットで検証します。再構成誤差と物理ヘッド精度の両方を監視します。
-
展開準備: エンコーダをフリーズします。新しいタスクまたはドメインで予測子とデコーダのみを微調整します。これは表現ドリフトを防ぎながら、動力学と再構成のタスク固有の適応を可能にします。
-
継続的な監視: 推論中に潜在埋め込みと物理予測をログに記録します。 保留された検証データで物理ヘッド精度を定期的に再計算します。精度しきい値を設定します(例えば、接触予測で95%、速度で5%相対誤差)。
-
ドリフト検出と応答: 物理ヘッド精度がしきい値以下に低下する場合、モデルは潜在空間がもはや物理的に根拠のあるレジームに遭遇しています。新しいデータでの再トレーニングをトリガーするか、ピクセル空間計画にフォールバックします(計算コストが高いですが、より堅牢です)。
-
具体的な例:* ロボットはSTPLSを使用して物理シミュレータでプッシングを学習します。実世界に展開されると、視覚的外観は変わります(照明、テクスチャ、カメラキャリブレーション)が物理は類似したままです。エンコーダは新しいビジュアルに適応しながら物理ヘッドは正確なままです。100回の実世界インタラクション後、接触予測精度は98%から91%に低下します。7%の低下です。これは潜在空間がドリフトしていることを示唆しており、おそらくモデル化されていない実世界効果(摩擦変動、オブジェクト変形、センサノイズ)が原因です。100回のインタラクション中に収集された実世界データでの再トレーニングをトリガーします。
-
フォールバック機構:* 段階的な劣化を実装します。物理ヘッド精度が重大なしきい値以下に低下する場合(例えば、85%)、潜在空間計画を無効にし、ピクセル空間計画または明示的な物理シミュレーションを使用したモデル予測制御にリバートします。これは計算効率をロバストネスと交換します。
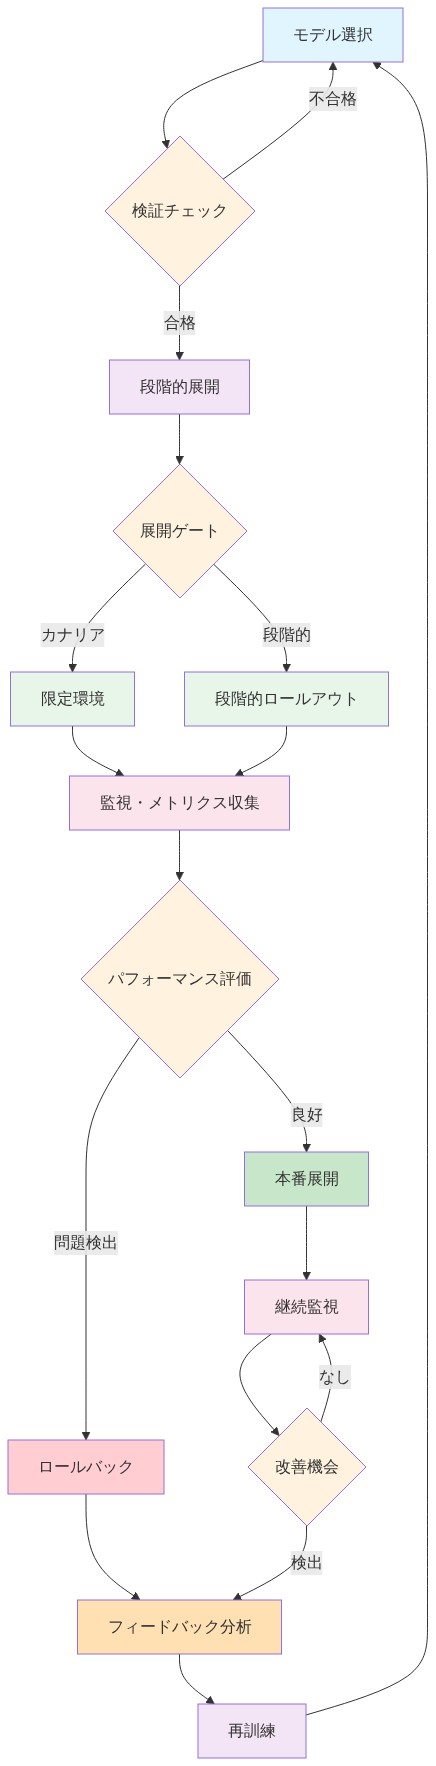
- 図9:信頼性の高い展開のための運用パターン*
予測誤差を超えた表現品質をどのように測定するか
標準的な評価メトリクス(次フレーム予測誤差、アクション成功率)は表現怠惰性を検出するのに不十分です。モデルはピクセル空間予測誤差が低いままでありながら、多段階計画立案に必要な動力学をエンコードできない場合があります。物理認識メトリクスを導入します。
-
速度予測誤差: 潜在埋め込みから地上真実速度への線形プローブを適合させます。MSEまたは相対誤差を測定します。しきい値:<5%相対誤差。
-
接触予測精度: 潜在埋め込みからバイナリ接触状態へのロジスティック回帰分類器を適合させます。F1スコアまたはバランスの取れた精度を測定します。しきい値:>95%。
-
潜在空間解釈可能性: 各物理量(位置、速度、回転、接触)に対して、線形プローブを適合させ精度を測定します。「物理忠実度スコア」として集約します。しきい値:すべての量全体で>90%精度。
-
計画立案ホライズン低下: ロールアウト長の関数として予測誤差を測定します。動的シーンと静的シーンでの誤差成長を比較します。動的シーンで誤差が2倍速く成長する場合、怠惰性を疑います。
-
速度条件付き誤差: オブジェクト速度による予測誤差を分解します。誤差対速度をプロットします。誤差が速度で超線形に増加する場合、モデルは高速動力学で怠惰です。
-
具体的な評価プロトコル:*
-
2つのデータセットでベンチマークします。1つは静的オブジェクト(低速度)、1つは急速な運動(高速度)を備えています。
-
標準モデル:静的で0.05 MSE、動的で0.12 MSE(2.4倍ギャップ)。
-
STPLSモデル:静的で0.05 MSE、動的で0.06 MSE(1.2倍ギャップ)。
-
より小さいギャップはSTPLSが動的情報をより良く保存することを明らかにします。
-
診断ワークフロー:*
- モデルをトレーニングします(標準またはSTLPS)。
- テストセットで潜在埋め込みを抽出します。
- 各潜在埋め込みに物理プローブ(線形モデル)を適合させます。
- プローブ精度を測定します。<90%の場合、モデルはその物理量で怠惰です。
- 怠惰な場合、物理教師あり学習重みを増加させるか、ハード制約を追加します(例えば、特定の潜在次元が特定の量をエンコードすることを強制)。
潜在空間を根拠付けるときに出現するリスクは何か
物理教師あり学習は積極的に軽減する必要がある新しい失敗モードを導入します。
-
リスク1:破損した地上真実。* 地上真実物理がノイズが多いまたは不正確な場合、モデルは破損した表現を学習します。例えば、センサノイズのため接触ラベルが誤ラベル付けされた場合、接触予測ヘッドはバイアスのある分類器を学習し、エンコーダは位置ずれした潜在空間を学習します。軽減:(1)地上真実物理パイプラインを独立した測定に対して検証します。(2)トレーニング中に物理ラベルにノイズを追加します(連続量で±5%、バイナリラベルでランダムフリップ)ロバストネスを改善するため。(3)複数の物理スーパーバイザーを使用して単一のノイズ信号への過剰適合を防ぎます。
-
リスク2:シミュレータバイアス。* 物理教師あり学習に微分可能シミュレータを使用する場合、モデルはシミュレータの仮定に合わせた表現を学習し、現実ではなく。例えば、シミュレータが剛体を仮定しますが実オブジェクトが変形する場合、潜在空間は現実と位置ずれします。モデルは間違った予測に自信を持つようになります。軽減:(1)シミュレータ予測を実世界データに対して検証します。(2)トレーニング中にシミュレータパラメータ(摩擦、反発係数、質量)でドメインランダム化を導入します。(3)シミュレータバイアスを修正するために定期的に実世界データで再トレーニングします。
-
リスク3:物理レジームへの過剰適合。* 接触状態をエンコードするようにトレーニングされたモデルは接触検出に過剰適合し、接触メカニクスが変わるときに失敗する可能性があります(例えば、異なる摩擦係数、表面特性)。軽減:(1)複数の物理スーパーバイザー(接触、速度、位置、回転)を使用して1つへの過剰適合を防ぎます。(2)トレーニングデータに多様な物理レジームを含めます(例えば、複数の摩擦係数、オブジェクト材料)。(3)保留された物理レジームで検証します。
-
リスク4:一般化の低下。* 物理根拠付けは分布外シナリオへの一般化を低下させる可能性があります。剛体プッシングでトレーニングされたモデルは変形可能なオブジェクトで失敗する可能性があります。軽減:(1)トレーニングに多様なオブジェクトタイプを含めます。(2)物理に依存しない補助ヘッド(例えば、「速度」ではなく「オブジェクト運動の大きさ」)を使用して転移を改善します。(3)保留されたオブジェクトカテゴリで検証します。
-
具体的な軽減プロトコル:*
-
地上真実物理パイプラインを監査します。センサデータを独立した測定に対して検証します。ドリフトとノイズをチェックします。
-
シミュレータを使用する場合:シミュレータ予測を実世界データの10%で検証します。誤差を測定します。>10%の場合、シミュレータを再トレーニングするか、ドメインランダム化を増加させます。
-
トレーニング中:物理ラベルに±5%ノイズを追加します。多様な物理レジームを含めます。3つ以上の物理スーパーバイザーを使用します。
-
検証中:保留された物理レジームでテストします(例えば、異なる摩擦)。物理ヘッド精度を測定します。<90%の場合、トレーニングで物理多様性を増加させます。
- 図13:物理的グラウンディング導入時のリスク要因関係図*
次に何をすべきか
STPLSは標準潜在ワールドモデルのドロップイン置換ではありません。物理教師あり学習と監視のためのインフラストラクチャが必要です。実装は段階的であるべきです。
-
フェーズ1:監査(1~2週間)*
-
テストセットで現在のモデルから潜在埋め込みを抽出します。
-
物理量(位置、速度、接触)を予測するために線形プローブを適合させます。
-
プローブ精度を測定します。<95%の場合、モデルは怠惰です。
-
低いプローブ精度を持つ物理量を特定します。これらは補助教師あり学習の候補です。
-
フェーズ2:実装(2~4週間)*
-
各物理量に対してエンコーダに軽量補助ヘッド(2~3層MLP)を追加します。
-
地上真実物理ラベルを収集または生成します(シミュレータ、センサ、またはポーズ推定から)。
-
結合教師あり学習でリトレーニングします。再構成損失+動力学損失+物理損失。
-
動的テストセットでのクロスバリデーションを通じて損失重みをチューニングします。
-
フェーズ3:検証(1~2週間)*
-
動的テストセット(急速な運動、衝突、状態不連続性)で評価します。
-
標準モデルと比較します。
Spectral-Target Physical Latent Structuring が異なる理由
Spectral-Target Physical Latent Structuring(STPLS)は、潜在空間の明示的な意味論的分割と、訓練時の補助的物理監督を組み合わせることで、表現の怠惰性に対処します。タスク関連情報を保持するために単にエンドツーエンド正則化に依存するのではなく、STPLSは特定の潜在次元が解釈可能な物理量をエンコードすることを強制します。
-
アーキテクチャメカニズム:* 訓練中、軽量な補助予測ヘッドが潜在表現に接続されます。これらのヘッドは、潜在埋め込みから直接、位置(xyz)、速度(vx、vy、vz)、回転(四元数またはオイラー角)、接触状態(二値または多クラス)、材料特性(変形性、摩擦)といった真値物理量を予測します。予測は微分可能シミュレータまたはセンサ由来の真値に対して監督されます。エンコーダはその後、再構成誤差を最小化し、かつ潜在次元が正確な物理予測に十分な情報量を保つことを確保するために共同最適化されます。
-
既存手法との関係性:* STPLSはスペクトル正則化(SIGReg)の代替ではなく補完的です。SIGRegはエンコーダ予測器ヤコビアンの特異値分布を制約し、ダイナミクスモデルの情報ボトルネックを防ぎます(Goroshin et al., 2015)。STPLSは潜在空間の意味的内容を制約し、情報が単に保持されるだけでなく、タスク関連次元で保持されることを確保します。この二つのメカニズムは直交する失敗モードに対処します。SIGRegは崩壊を防ぎ、STPLSは怠惰性を防ぎます。
-
具体的な実装例:* ボール投げタスクでは、STPLSはボール位置(3D)、速度(3D)、空気力学的状態(空気抵抗レジームの二値フラグ)に潜在次元を割り当てます。エンコーダは、これらの次元が静止、飛行中、衝撃後のすべてのフレームにわたって情報量を保つ必要があることを学習します。標準的なエンドツーエンドモデルは、この情報を単一の「ボール状態」ベクトルに圧縮し、衝撃タイミングやバウンス軌跡を予測するために必要な精度を失う可能性があります。STPLSは各物理量を明示的に監督することで、精度を非交渉にします。
-
損失関数の定式化:* 共同訓練目的関数は以下の通りです。
$$\mathcal{L}{\text{total}} = \mathcal{L}{\text{recon}} + \lambda_{\text{dyn}} \mathcal{L}{\text{dynamics}} + \sum{i} \lambda_{p_i} \mathcal{L}_{p_i}$$
ここで、$\mathcal{L}{\text{recon}}$は再構成誤差(ピクセル空間または潜在空間)、$\mathcal{L}{\text{dynamics}}$は潜在ダイナミクス予測誤差、$\mathcal{L}_{p_i}$は物理固有の損失(速度MSE、接触交差エントロピーなど)です。重み係数$\lambda$は各目的関数の相対的重要性を制御します。
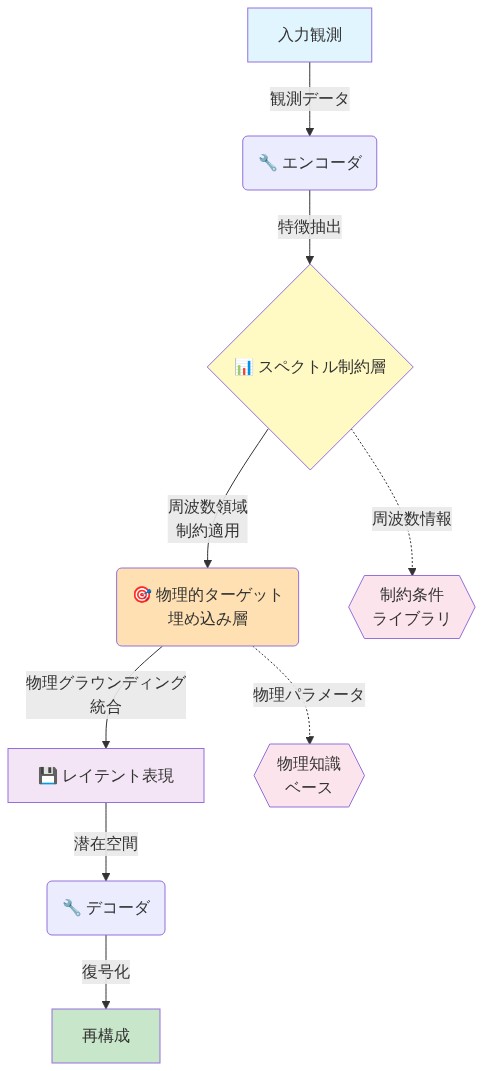
- 図5:スペクトル-ターゲット構造化アーキテクチャの詳細処理フロー*