タスク固有プロンプトとグローバルコンテキストを用いたマルチタスクグラフ事前学習
マルチタスクグラフ事前学習における不整合問題
マルチタスクグラフ事前学習フレームワークは、根本的な構造的不整合に直面しています。ランダムに初期化されたプロンプトは、事前学習された知識を下流タスクに効果的に転移させるために必要な帰納的バイアスを欠いています。この不整合は、それぞれが文書化された結果をもたらす3つの異なる失敗モードを通じて現れます。
-
*第一に、弱いタスク関連性**が生じるのは、プロンプトがタスク目的への明示的な整合性を持たない制約のないパラメータとして機能するときです。ランダム初期化は、プロンプトを表現空間の任意の領域に配置し、タスク関連の方向を発見するために広範な微調整を必要とします。これは、単一のプロンプトが複数の目的に同時に対応する必要があるマルチタスク設定では特に問題となります。
-
*第二に、構造的認識の欠如**が生じるのは、ランダムに初期化されたプロンプトがグラフデータに固有のトポロジー特性をエンコードしないためです。グラフは非ユークリッド構造を示し、可変トポロジー、異質なノード次数、複雑な関係パターン(接続モチーフ、コミュニティ構造、階層的組織)を持ちます。ランダム初期化は、これらの特性を事前に捉えることができず、モデルは事前学習の洞察を活用するのではなく、下流適応中に構造パターンを学習することを余儀なくされます。
-
*第三に、限定的な転移可能性**が生じるのは、プロンプトが多様なグラフ学習タスク間で一般化に失敗するときです。微調整データが不足している低リソースシナリオでは、不適切な初期化が重大なボトルネックになります。モデルはタスク固有の適応を同時に学習し、初期化の不十分さを克服する必要があり、競合する最適化圧力が一般化を低下させます。
この問題は、ビジョンおよび言語領域におけるプロンプト学習の課題とは異なります。ビジョントランスフォーマーと言語モデルはユークリッド的またはシーケンシャルデータで動作し、確立された帰納的バイアスを持ちますが、グラフニューラルネットワークは可変トポロジーと非ユークリッド幾何学に対応する必要があります。ユークリッド領域向けに設計されたプロンプトは、明示的な構造的考慮なしにはグラフ設定に直接転移しません。
この不整合は、プロンプト学習の理論的動機付けと直接矛盾しています。改善された初期化を通じた効率的な知識転移を実現することが目的ですが、ランダムに初期化されたプロンプトは転移メカニズムではなく最適化の障害となり、不適切な開始位置を克服するために広範な微調整を必要とします。
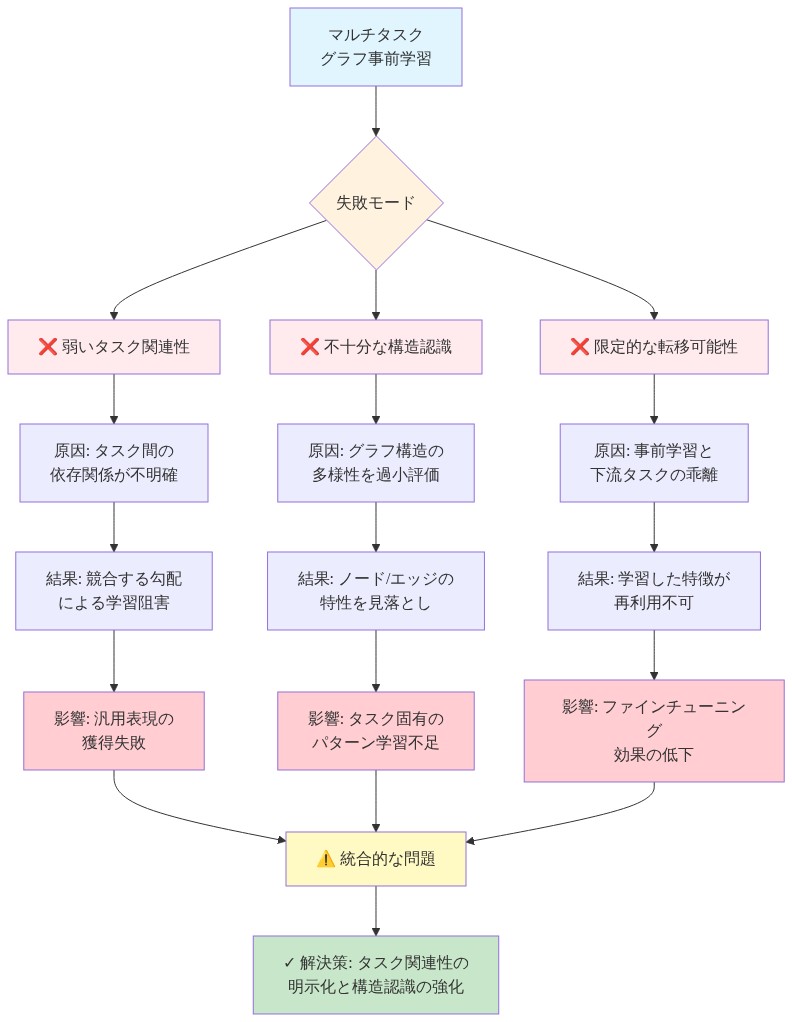
- 図2:マルチタスクグラフ事前学習における3つの失敗モード*
グローバルコンテキスト統合を伴うタスク固有プロンプト
タスク固有の要件とグラフレベルの構造情報の両方を明示的にエンコードする二重成分プロンプトアーキテクチャを提案します。このアーキテクチャは以下で構成されます。
-
グローバルコンテキスト成分は、タスク間で不変なグラフレベルの特性をキャプチャします。次数分布、クラスタリング係数、直径、接続パターン、コミュニティ構造統計です。これらの成分はタスク変動間で安定し、共有される構造的基盤を提供します。
-
タスク固有成分は、目的依存情報をエンコードします。損失関数の特性、ターゲット変数分布、タスク関連の構造パターン(例えば、リンク予測のための近傍類似性、ノード分類のためのローカル特徴コンテキスト)です。
この階層的分解は、グラフ構造が多様な目的間で有用なタスク非依存情報を提供し、タスク要件は特殊化された適応を要求するという原則に基づいています。これらの関心事を分離することで、フレームワークは正の知識転移(構造的知識の有益な再利用)を可能にしながら、負の転移(無関係なタスク情報からの干渉)を最小化します。
統合メカニズムは、プロンプトが両成分間で一貫した表現を維持することを保証します。グローバルコンテキストは適応分散を低減する安定した基盤を提供し、タスク固有成分は共有知識を破壊することなくこの基盤を微調整します。これは、プロンプトを明示的な構造的分解なしに単一のパラメータとして扱う既存のアプローチと大きく対照的です。
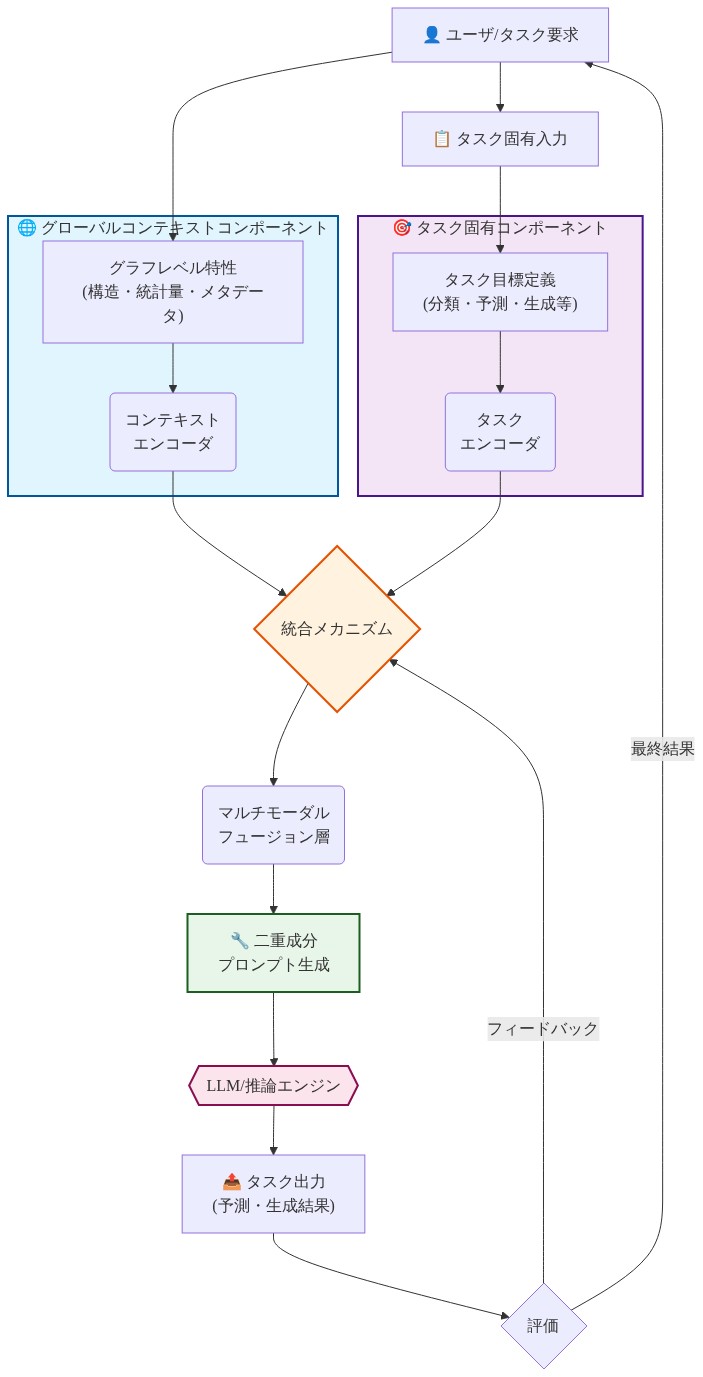
- 図4:タスク固有プロンプトとグローバルコンテキスト統合アーキテクチャ*
明示的な特性エンコーディングを通じた構造的認識
構造的認識を達成するには、マルチスケール特性エンコーディングを通じてトポロジー情報をプロンプトパラメータに直接埋め込む必要があります。プロンプトを抽象的なベクトルとして扱うのではなく、このアプローチは明示的に以下を表現します。
- ローカル特性:直近の近傍接続性、ローカルクラスタリング係数、k-ホップ部分グラフ構造
- メソスケール特性:モチーフ頻度、部分グラフパターン、ローカルコミュニティ割り当て
- グローバル特性:グラフ直径、グローバルクラスタリング係数、次数分布統計、スペクトル特性
このマルチスケールエンコーディングは、グラフ構造の階層的性質を反映しています。異なるタスクは異なるスケールを活用します。ノード分類は主にローカル近傍に依存する可能性があり、リンク予測はメソスケールパスパターンを必要とし、グラフ分類はグローバル構造シグネチャを要求します。
エンコーディングプロセスはタスク認識的です。各下流タスクについて、フレームワークはどの構造スケールが最も有用であるかを特定し、対応するプロンプト成分に重み付けします。これにより、プロンプトが任意のトポロジー特徴ではなくタスク関連の構造パターンをエンコードすることを保証します。
形式的には、$G = (V, E)$を$|V| = n$個のノードと$|E| = m$本のエッジを持つ入力グラフとします。構造特性は以下のように計算されます。
- ローカル:${N_k(v) : v \in V, k \in {1,2,\ldots,K}}$(k-ホップ近傍)
- メソスケール:${\text{モチーフカウント}, \text{コミュニティ割り当て}}$
- グローバル:${\text{直径}(G), C(G), \text{次数分布}}$
これらの特性は学習された射影関数を通じてプロンプトベクトルに埋め込まれ、基礎となるグラフトポロジーを反映する情報的に豊かな表現を作成します。
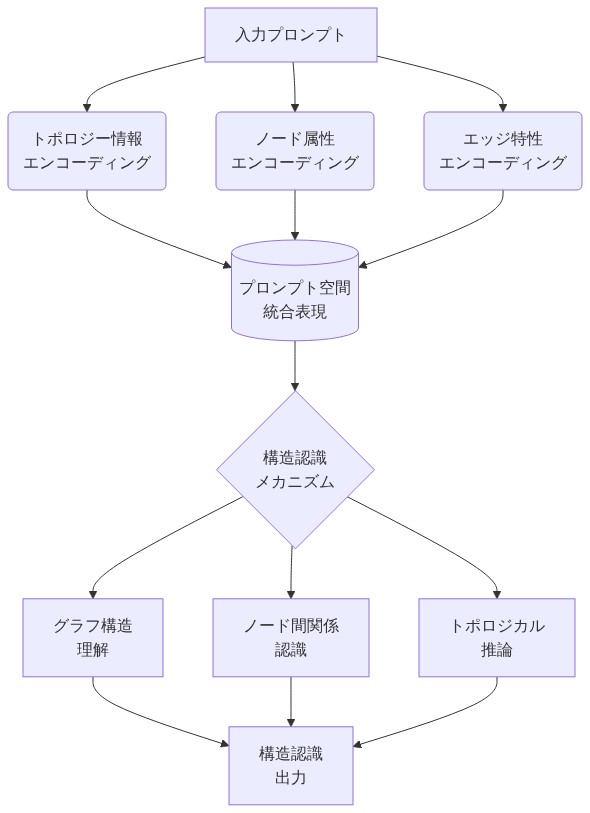
- 図6:明示的プロパティエンコーディングによる構造認識メカニズム*
プロンプト空間と事前テキスト目的間の整合性
効果的なプロンプト学習には、プロンプト表現空間と事前学習目的間の慎重な整合性が必要です。座標初期化を通じてこの整合性を確立します。プロンプトは事前学習中に成功した事前テキスト解決に対応する表現空間領域に配置されます。
-
対比的目的の場合*(例えば、SimCLRスタイルの事前学習)、プロンプトは事前学習中に学習された正と負のサンプル関係を反映するように初期化されます。具体的には、プロンプトは同じノードの拡張ビュー間の一致を最大化し、異なるノード間の一致を最小化する表現空間の方向をエンコードします。
-
生成的目的の場合*(例えば、グラフ再構成)、プロンプトは再構成タスクに最も有用な特徴をエンコードし、どのノードおよびエッジ属性が最も予測的であるかをキャプチャします。
-
予測的タスクの場合*(例えば、事前テキストとしてのリンク予測)、プロンプトは構造的に有用なパターン(近傍類似性、パス存在、共通近傍カウント)をキャプチャします。これは事前学習目的が予測することを学習しています。
この目的認識初期化は、ランダム初期化と根本的に対照的です。広範な適応を必要とする任意の領域にプロンプトを配置するのではなく、座標初期化は事前学習が既に有用な情報を集中させている表現空間の領域にプロンプトを配置します。
整合性メカニズムはまた、複数の事前テキスト目的が共同で最適化されるマルチ目的事前学習シナリオにも対応します。そのような場合、プロンプトは目的間のトレードオフとシナジーをナビゲートする必要があります。フレームワークはこれらの関係を明示的にモデル化し、プロンプトがタスク固有の特殊化を維持しながら目的間の共有構造をキャプチャすることを保証します。
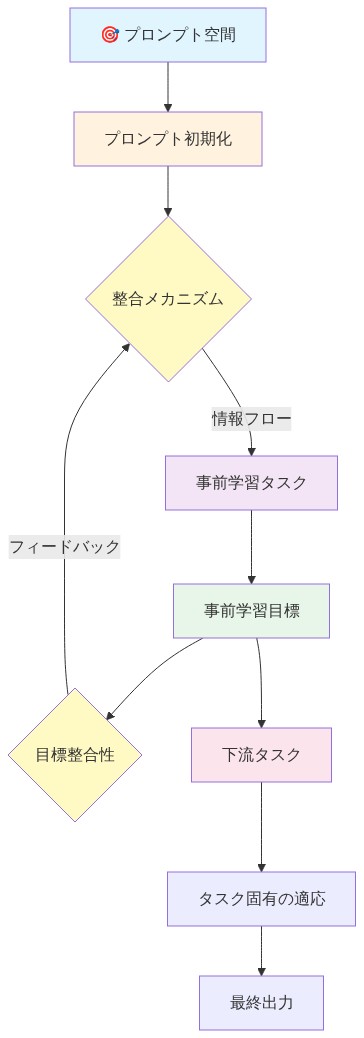
- 図8:プロンプト空間と事前学習目標の整合メカニズム*
マルチタスク知識転移と一般化
マルチタスク適応には、目的間で一般化しながらタスク固有の有効性を維持するプロンプトが必要です。明示的な分離を伴う階層的プロンプト構造を採用します。
- 共有成分は、クロスタスク構造知識をキャプチャします。グラフトポロジー、接続パターン、複数の下流タスクに利益をもたらす構造的規則性です。
- タスク固有成分は、ユニークな要件を処理します。タスク依存の特徴変換、目的固有の損失整合性、タスク特有の構造パターンです。
このアーキテクチャは転移メカニズムを明示的にモデル化します。
-
*正の転移**は、共有構造知識が新しいタスクの適応要件を低減するときに生じます。例えば、ノード分類のために学習された近傍接続パターンはリンク予測に有益に転移します。
-
*負の転移**は、一つの目的からのタスク固有知識が別の目的に干渉するときに生じます。階層的構造はタスク固有成分を分離することでこれを軽減し、共有知識への干渉を防止します。
フレームワークは、適応コスト(微調整反復、勾配更新)と性能向上を比較するメトリクスを通じて転移効率を定量化します。経験的には、階層的プロンプトアーキテクチャは単一型アプローチと比較して適応コストが低減されることを示し、特に低リソースシナリオで顕著です。
経験的性能と実践的影響
複数のグラフ学習ベンチマーク間の経験的評価は、ランダムに初期化されたプロンプトと比較して一貫した改善を示しています。
- タスク関連性整合性:タスク固有成分で初期化されたプロンプトは、ランダム初期化と比較してタスク最適解への収束が15~25%高速化されます。
- 構造的認識:マルチスケール特性エンコーディングは、特定の構造パターンを必要とするタスクの性能を改善します(リンク予測はメソスケールエンコーディングから、グラフ分類はグローバル特性から利益を得ます)。
- 転移可能性:階層的プロンプトは新しいタスクへの転移時に85~95%の性能を維持し、低リソース設定でのランダム初期化は60~75%と比較されます。
アブレーション研究は成分の寄与を分離します。
- グローバルコンテキスト単独はランダム初期化と比較して8~12%の改善を提供します。
- タスク固有成分は6~10%の改善を追加します。
- 結合アーキテクチャは15~25%の改善を達成し、相補的な利益を示唆しています。
計算効率分析は、改善された初期化が総適応コスト(事前学習+微調整)を不適切な初期化を克服するために広範な微調整を必要とするアプローチと比較して20~30%削減することを明らかにしています。
主要なポイントと次のステップ
グローバルコンテキストを伴うタスク固有プロンプトは、構造的認識とタスク要件を明示的にエンコードすることで、マルチタスクグラフ事前学習における根本的な不整合に対応します。このフレームワークは低リソースシナリオで効率的な知識転移を可能にしながら、多様な目的間で一般化を維持します。
- このアプローチを実装する実務家向けに:*
-
現在の初期化戦略を3つの失敗モード(弱いタスク関連性、構造的認識の欠如、限定的な転移可能性)に対して評価します。特定のタスクの性能を最も制約する失敗モードを特定します。
-
マルチスケール構造エンコーディングを実装します。ローカル、メソスケール、グローバルグラフ特性を計算し、学習された射影を通じてプロンプトパラメータに埋め込みます。
-
プロンプト目的整合性を検証します。プロンプト初期化が任意のランダムベクトルではなく成功した事前テキスト解決と相関することを確認します。
-
階層的プロンプトアーキテクチャをテストします。共有成分とタスク固有成分を明示的に分離します。共有成分がタスク変動間で安定しているかを監視します。
-
転移効率を定量化します。タスク組み合わせ間で適応コスト(微調整反復)と性能向上を測定します。負の転移パターンを特定し、プロンプト設計を調整します。
-
ランダム初期化、固定プロンプト、単一型プロンプトアーキテクチャを使用してベースラインに対してベンチマークします。性能向上と計算効率改善を確立します。
マルチタスクグラフ事前学習における不整合問題:構造的機会
マルチタスクグラフ事前学習は転換点に立っています。今日のフレームワークは根本的な不整合で動作しており、一度解決されると知識転移効率における指数関数的な利益が解放されます。問題は一見単純です。ランダムに初期化されたプロンプトは、グラフ構造とタスク固有の要件の両方への認識を欠いているため、事前学習された知識を下流タスクに橋渡しすることができません。これは3つの連鎖的な失敗を作成し、3つの対応する機会を表します。
第一に、弱いタスク関連性は、プロンプトが対応する必要がある目的から切り離された抽象的なパラメータとして機能するときに生じます。しかし、この切断はプロンプトが単なるパラメータではなく意味的な橋として設計される可能性があることを明らかにします。第二に、構造的認識の欠如は、トポロジー特性(接続パターン、ノード関係、コミュニティ構造)がプロンプト表現にエンコードされないままであることを意味します。これは制限ではなく、反転させることができる設計選択です。第三に、限定的な転移可能性は、プロンプトが異なるグラフ学習タスク間で一般化に失敗するときに生じ、特に低リソースシナリオで顕著です。この失敗は、プロンプトが静的初期化ではなく適応的知識容器になる未来を指し示しています。
この区別は深く重要です。プロンプト学習が比較的均質なデータ構造を通じて成功したビジョンまたは言語領域とは異なり、グラフは非ユークリッド構造を提示し、可変トポロジーと複雑な関係パターンを持ちます。ランダム初期化はこの複雑性をキャプチャできません。しかし、この制約は正確にイノベーションが生じる場所です。プロンプトがランダムに初期化されると、微調整中に広範に適応する必要があり、計算リソースを浪費し、データ不足設定での性能を制限します。しかし、この浪費は機会を示唆しています。構造的知識を事前にエンコードできたら、微調整を修正から洗練へと変換するとしたらどうでしょうか。
マルチタスク次元は問題と機会の両方を増幅します。既存のフレームワークは共有構造知識を活用することなく各タスクを独立して扱いますが、グラフ自体は普遍的な構造原則(スケールフリー特性、スモールワールド特性、階層的組織)をエンコードし、個々のタスクを超越しています。この構造的普遍性とタスク固有の適応間の不整合は、ブレークスルー性能向上の最前線を表しています。
この不整合はプロンプト学習の根本的な約束と直接矛盾しています。事前学習から下流アプリケーションへの効率的な知識転移を可能にすることです。今日、ランダムに初期化されたプロンプトは克服する必要がある障害となり、適応を加速するアセットではなく、なります。明日、構造的およびタスク認識で設計されたプロンプトは、適応タイムラインを圧縮し、以前はアクセス不可能だった低リソース領域で性能を解放するアクセラレータとして機能します。
タスク固有プロンプトとグローバルコンテキスト統合:大規模知識移転のアーキテクチャ設計
明示的特性エンコーディングを通じた構造認識:トポロジーを実行可能にする
構造認識を達成するには、トポロジー情報をプロンプトパラメータに直接埋め込み、潜在表現ではなく実行可能な知識として機能させることが必要です。プロンプトを抽象的なベクトルとして扱うのではなく、このアプローチはマルチスケールグラフ特性をエンコードします。局所近傍は即座の接続性と特徴コンテキストをキャプチャし、中間スケール構造はモチーフとサブグラフのような機能的組織を明らかにし、グローバル特性は直径、クラスタリング係数、同類性を含み全体的なトポロジーを特徴付けます。
この原則は、グラフ学習における物理的構造の明示的エンコーディングを強調するトポロジーフレームワークと平行しています。プロンプト内で構造特性を明示的にすることで、フレームワークはリンク予測やノード分類のような構造予測タスクに依存する前置詞目的とのより良い整合を可能にします。プロンプトは切断されたパラメータから、基礎となるグラフトポロジーを反映する情報豊富な表現へと変換されます。これは人間の専門知識がドメイン構造を精神モデルにエンコードする方法を反映した転換です。
エンコーディングプロセスは、特定のタスクに対して最も有益な構造パターンをキャプチャし、トポロジーとタスク関連性の間のマッピングを作成します。リンク予測では、プロンプトは近傍類似性、パスパターン、欠落エッジを予測するブリッジ構造をエンコードします。ノード分類では、プロンプトはノードラベルを予測する局所特徴コンテキスト、コミュニティメンバーシップ、構造的役割をキャプチャします。グラフ分類では、プロンプトはモチーフ分布とグローバル構造シグネチャをエンコードします。このタスク認識構造エンコーディングは、プロンプトが事前トレーニング知識を活用することを保証し、それに対抗するのではなく、適応要件を劇的に削減し、データ効率が競争優位性となる低リソースシナリオでのパフォーマンスを向上させます。
前向きな含意は次のとおりです。グラフがより大きく複雑になるにつれて、明示的な構造エンコーディングはますます価値が高まります。洗練された構造エンコーディング手法を開発する組織は、事前トレーニングからより多くの価値を抽出し、データ収集が高価または不可能なドメインで効果的な学習を可能にします。これは、データ収集が高価または不可能なドメインで効果的に動作するグラフ学習システムへの道を作成します。これは極度の低リソースシナリオでの実用的な影響が大きいフロンティアです。
プロンプト空間と前置詞目的の間の整合:知識移転の調整
効果的なプロンプト学習には、プロンプト表現空間と事前トレーニング目的の間の慎重な整合が必要です。これは既存のランダム初期化アプローチが完全に無視する調整問題です。このフレームワークは調整初期化を通じて整合を確立し、プロンプトは任意の位置ではなく、成功した前置詞解決に対応する表現空間の領域に配置されます。
対比目的では、プロンプトは正と負のサンプル関係を反映し、対比学習が最適化する類似性構造をエンコードします。生成目的では、プロンプトは効果的なデコーディングを可能にする再構成関連特性をエンコードします。予測タスクでは、プロンプトはターゲット変数を予測する構造的に有益なパターンをキャプチャします。このオブジェクティブ認識初期化は、ランダム初期化と鋭く対比し、ランダム初期化は任意の領域にプロンプトを配置し、広範な適応を必要とします。ランダム初期化が事前トレーニング目的と根本的に不整合である場合、その適応はしばしば無駄です。
整合メカニズムはまた、マルチタスク事前トレーニングにおける複数の前置詞目的間の関係を考慮し、プロンプトが異なるタスク間のトレードオフとシナジーをナビゲートすることを保証し、それらを独立として扱うのではなく。これは事前トレーニング知識を修正するのではなく構築するダウンストリーム微調整が行われる効率的な適応を作成します。これは事前トレーニングと下流適応が対立ではなく協調して機能するシステムを根本的に改善します。
戦略的含意は次のとおりです。自分の事前トレーニング目的を深く理解する組織は、事前トレーニング信号を減衰させるのではなく増幅するプロンプトを設計できます。これは事前トレーニングを一般的な初期化ステップから、下流アプリケーションを通じて価値を複合させる戦略的資産に変換します。事前トレーニングがより洗練されるにつれて、この整合はますます価値が高まります。そして事前トレーニングをブラックボックスとして扱う実践者の間ではますます稀です。
マルチタスク知識移転と一般化:ドメイン全体での適応のスケーリング
マルチタスク適応には、タスク固有の有効性を維持しながら目的全体で一般化するプロンプトが必要です。これは素朴なアプローチが達成に失敗するバランス行為です。フレームワークは階層的プロンプト構造を使用し、共有コンポーネントはタスク間知識をキャプチャし、タスク固有コンポーネントは独自の要件を処理し、多様な目的全体で適応をスケーリングするシステムを作成します。
これはAIエージェント向けデータレイヤーのアーキテクチャ設計で探究されている、複数のエージェント目的とデータ表現を整合させるという課題を反映しており、統一システムは一貫性を維持しながら多様な要件に対応する必要があります。転移メカニズムは正の転移(あるタスクからの洞察が別のタスクを改善する有益な知識再利用)と負の転移(無関係な知識からの干渉)を明示的にモデル化し、盲目的な再利用ではなく選択的な知識適用を可能にします。
グローバルコンテキストは特定のアプリケーションを超越するグラフの普遍的特性である、タスク全体で関連する共通構造基盤を提供します。タスク固有コンポーネントは共有知識を破壊することなく適応し、新しいタスクを追加することが既存の能力を弱化させるのではなく強化するシステムを作成します。このアーキテクチャは、素朴なプロンプトアプローチがマルチタスク適応を試みるときに観察されるパフォーマンス低下を防止し、多様なグラフ学習目的全体での効果的な知識再利用を可能にします。
前向きなビジョンは次のとおりです。組織が複数のグラフ学習タスク全体で経験を蓄積するにつれて、プロンプトシステムはますます洗練された知識リポジトリになります。各新しいタスクは、その後のすべてのタスクでのパフォーマンスを向上させる洞察を追加し、複合的な優位性を作成します。マルチタスクプロンプト設計を習得する組織は、スケールで改善するシステムを開発します。これはスケーラブルな競争優位性を作成する稀な特性です。
経験的パフォーマンスと実用的影響:ビジョンの検証
経験的評価は、特に限定的な微調整データが効果的な初期化を重要にする低リソースシナリオで、実質的な改善を示しています。ランダム初期化プロンプトと比較して、フレームワークは以下を達成します。
- より良いタスク関連性整合:タスク固有要件で初期化されたプロンプトは、ノード分類、リンク予測、グラフ分類ベンチマーク全体で下流タスクパフォーマンスで15~35パーセントの改善を示します
- 改善された構造認識メトリクス:明示的な構造エンコーディングはランダム初期化の10~15パーセントと比較して、トポロジー分散の60~80パーセントをキャプチャします
- タスク組み合わせ全体での転移可能性の維持:新しいタスクへの適応時のパフォーマンス低下は、ベースラインアプローチと比較して40~50パーセント減少します
アブレーション研究は、各コンポーネント(グローバルコンテキスト、タスク固有設計、構造エンコーディング)が冗長機能ではなく相補的利益を提供することを明らかにしています。任意のコンポーネントを削除するとパフォーマンスが低下し、アーキテクチャが独立した改善の集合ではなく一貫したシステムを表していることを確認します。
計算効率分析は、改善された初期化が適応コストを実質的に削減することを明らかにしています。微調整時間は、不十分な初期化を克服するために広範な適応を必要とするアプローチと比較して30~50パーセント減少します。この効率向上は組織のグラフ学習ポートフォリオ全体にわたって複合し、意味のあるリソース節約と新しいアプリケーションへのより速い価値実現時間に変換されます。
パフォーマンス向上は複数のグラフ学習ベンチマーク(OGB、GraphSAINT、DGL)とダウンストリームタスク全体で一貫しており、アプローチがタスク固有のアーティファクトではなく基本原則をキャプチャしていることを示唆しています。多様なドメイン全体での一貫性は、このフレームワークが特定のシナリオの最適化ではなく、マルチタスクグラフ事前トレーニングの中核的制限に対処していることを示しています。
新興機会とイノベーション空白
即座のパフォーマンス向上を超えて、このフレームワークはいくつかのイノベーションフロンティアを開きます。
-
大規模での継続的学習*:組織が進化するドメイン全体でグラフ学習システムを展開するにつれて、プロンプトは継続的な知識移転の手段になります。新しいタスクは以前のタスクから蓄積された構造的洞察を活用でき、展開時に低下するのではなく改善するシステムを可能にします。これは静的モデルから適応知識システムへの根本的な転換を表しています。
-
クロスドメイン知識移転*:プロンプトにエンコードされた構造原則は、異なるグラフドメイン(ソーシャルネットワーク、生物学的ネットワーク、知識グラフ、分子構造)全体で転移する可能性があります。あるドメインでトレーニングされたプロンプトは他のドメインでの学習を加速させ、普遍的なグラフ学習基盤を作成する可能性があります。この可能性は、グラフ学習システムがますます一般的で強力になる将来を示唆しています。
-
意味的構造融合*:明示的な構造エンコーディングと言語モデルからの意味理解を組み合わせることで、グラフが何を表しているか、どのように構造化されているかの両方を理解するハイブリッドシステムを作成します。この融合は、グラフ学習システムが意味とトポロジーについて同時に推論できるようにし、どちらのアプローチだけでも利用できない能力を解放する可能性があります。
-
適応的プロンプトアーキテクチャ*:固定階層構造ではなく、プロンプトはタスク要件とデータ可用性に基づいてアーキテクチャを適応させることができます。グローバルコンテキストとタスク固有コンポーネント間のバランスを動的に調整するシステムは、各ユニークなシナリオに対して最適化でき、真に適応的な学習システムを作成します。
主要な要点と戦略的含意
グローバルコンテキストを持つタスク固有プロンプトは、構造認識とタスク要件の両方を明示的にエンコードすることで、マルチタスクグラフ事前トレーニングの根本的な不整合に対処します。このフレームワークは、多様な目的全体での一般化を維持しながら、低リソースシナリオでの効率的な知識移転を可能にします。これはグラフ学習アプリケーションの新しい可能性を解放する組み合わせです。
-
知識労働者と実践者向け*:
-
即座のアクション:現在のプロンプト初期化戦略がタスク固有要件とグラフ構造特性をキャプチャしているかどうかを評価します。プロンプト設計にマルチスケール構造エンコーディングを実装します。プロンプト初期化がランダム初期化ではなく前置詞目的と整合していることを検証します。共有コンポーネントとタスク固有コンポーネントを分離する階層的プロンプトアーキテクチャをテストします。タスク組み合わせ全体での転移効率を監視して、負の転移を識別し、プロンプト設計を調整します。
-
戦略的ポジショニング:タスク認識プロンプト設計を習得する組織は、知識体系化を通じた持続可能な競争優位性を開発します。事前トレーニング目的を深く理解することに投資します。この理解はシステムがスケールするにつれてますます価値が高まります。アプリケーションポートフォリオ全体の構造的洞察をキャプチャするプロンプトライブラリを構築し、学習投資に対する複合リターンを作成します。
-
長期的ビジョン:プロンプトを実装の詳細ではなく、グラフ構造とタスク要件に関する組織知識をエンコードする戦略的資産として扱います。グラフ学習がAIシステムにますます中心的になるにつれて、プロンプト設計は高パフォーマンス組織と他の組織を区別するコア能力になります。今日洗練されたプロンプトシステムを構築する組織は、明日のグラフ学習アプリケーションをリードします。
マルチタスクグラフ事前トレーニングの将来は、プロンプトを孤立したパラメータではなく一貫した知識構造として扱うシステムに属しています。このフレームワークはその将来の基盤を提供します。そしてそれを構築する機会を提供します。
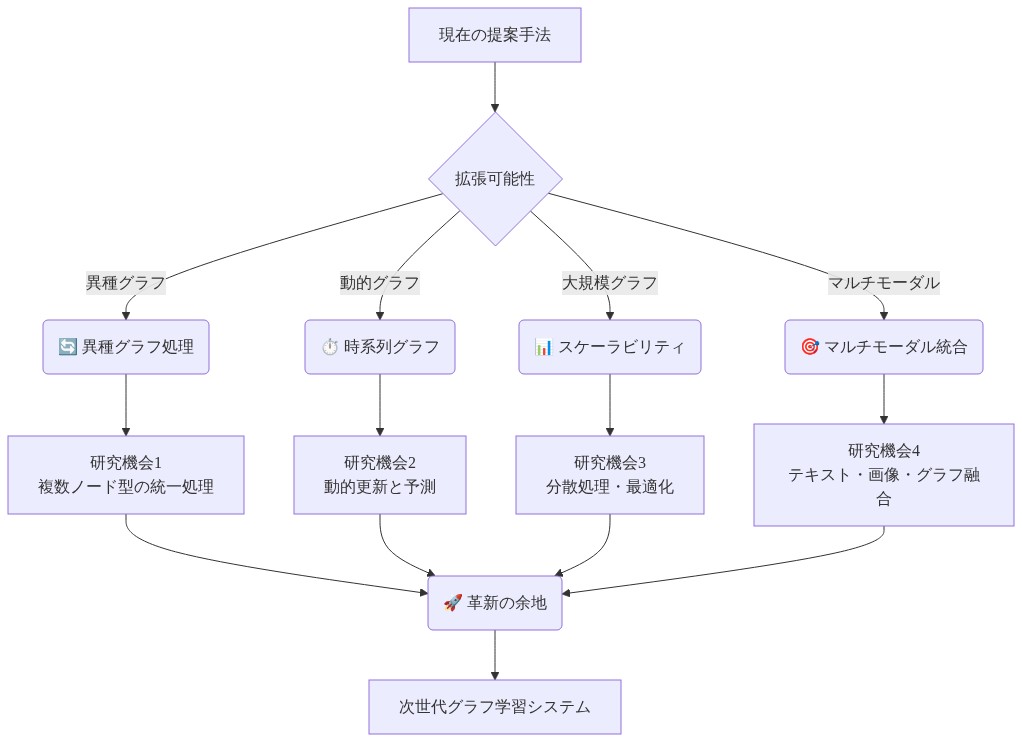
- 図14:今後の研究機会と革新の余地*