物理場シミュレーションにおけるトポロジー・ジオメトリ二重性問題
離散メッシュ上の物理シミュレーションは根本的な建築学的緊張に直面しています。保存則はジオメトリック変形に関わらず厳密に保たれなければならない一方で、材料特性と異方性応答はローカルメッシュ構造に応じて変動します。従来の数値手法はこの分離を慎重な離散化スキームを通じて維持しています。これに対してニューラルサロゲートは両者の関心事を区別されない伝播アーキテクチャに統合し、保存則を違反するか、またはジオメトリック変動全体で一般化に失敗するモデルを生成します。
標準的なグラフニューラルネットワークはメッシュ接続性と空間埋め込みを相互交換可能な特徴として扱い、学習された操作がトポロジー不変量を破壊することを許容します。この問題はより広い建築学的洞察を反映しています。異なる計算役割を分離することで、理論的保証と経験的改善の両方が得られます。LoKiFormerはこの原理を局所性融合と知識表現を分離することで実証しています。同じ論理が物理場モデリングに適用されますが、ここではステークスがより高くなります。保存則の違反は訓練精度に関わらず物理的に無意味な予測を生成するためです。
実世界のアプリケーションはこの課題を先鋭化させます。メッシュ解像度、要素品質、座標系はドメイン全体で恣意的に変動します。既存のニューラルオペレータはトポロジー不変量(離散化全体で厳密に転送されるべき)とジオメトリックパラメータ(ローカルメッシュ構造に適応すべき)を区別できません。結果として、訓練メッシュ特性に過適合し、精密化または粗化されたグリッドで失敗するモデルが生じます。
解決策は構成によって分離を強制します。恣意的なメッセージ関数を学習する代わりに、ネットワークはトポロジー演算子を固定し、ジオメトリー、そしてジオメトリーのみを学習可能にすべきです。これは従来のニューラルネットワーク設計を反転させます。従来は全てのパラメータが等価な自由度として扱われます。仮説空間を物理的に意味のある変換に制約することで、一般化が改善され、同時に解釈可能性が増加します。学習されたパラメータは不透明な特徴変換ではなく、材料特性とジオメトリック結合を直接表現します。
離散外微分と余鎖表現
離散外微分(DEC)は単体複体上の余鎖表現を通じてトポロジー構造とジオメトリック情報を分離するための数学的に厳密なフレームワークを提供します。この分離は本稿で提示されるアプローチの基礎となります。
余鎖と単体複体
単体複体Kは単体(頂点、辺、三角形、四面体、およびより高次元の一般化)の集合であり、代数トポロジーで標準的な閉包性と交差特性を満たします(Munkres, 1984)。k-余鎖はKの各k次元単体に実数値を割り当てる線形汎関数です。形式的には、k-余鎖の空間C^k(K; ℝ)はそのような全ての割り当ての集合からなるベクトル空間です。
物理場の実装では、k-余鎖はk次元メッシュ要素上に積分された物理量を表現します。例えば:
- 0-余鎖は頂点にスカラーを割り当てます(点値または積分量)
- 1-余鎖は辺にスカラーを割り当てます(循環またはフラックス的量)
- 2-余鎖は面にスカラーを割り当てます(フラックスまたは積分場量)
- 3-余鎖は体積にスカラーを割り当てます(密度的積分量)
この表現は標準的なグラフニューラルネットワークのノードベースまたはエッジベース特徴と根本的に異なります。標準的なグラフニューラルネットワークは通常、頂点またはエッジのみに特徴を割り当てます。完全な単体複体上の余鎖は全ての次元レベルでトポロジー構造の直接的な符号化を可能にします。
余境界演算子とトポロジー接続性
余境界演算子d: C^k(K; ℝ) → C^(k+1)(K; ℝ)はk-余鎖を(k+1)-余鎖にマップします。これは単体複体接続性によってのみ決定される固定的で組合せ的な規則を通じて行われます。k-単体σに対して、余境界演算子は単体上の境界演算子を通じて定義されます。(dω)(σ) = Σ ε(τ, σ) ω(τ)。ここで合計はσの(k-1)-面τ上であり、ε(τ, σ) ∈ {-1, 0, +1}は向きを符号化します(Munkres, 1984; Hirani, 2003)。
余境界演算子は基本的性質d² = 0を満たします(余境界の余境界はゼロ)。この性質は余鎖空間と余境界写像の列が完全列を形成することを保証し、以下を保証します。
Image(d^(k-1)) ⊆ Kernel(d^k) 全ての k に対して
この完全性は正則化制約または学習近似ではなく、メトリックまたは座標系に関わらず、任意の単体複体に対して構成によって成立します。その結果、離散保存則(例えば、フラックス保存、電荷保存)は計算全体を通じて厳密に保存され、損失項を通じた近似ではなく保存されます。
余境界演算子は純粋なトポロジー接続性を符号化し、学習中に固定されたままです。これはメッシュの組合せ構造のみに依存し、頂点位置、辺の長さ、またはいかなるメトリック情報にも依存しません。
ホッジスター演算子とジオメトリック情報
ホッジスター演算子⋆: C^k(K; ℝ) → C^(n-k)(K; ℝ)はk-余鎖を(n-k)-余鎖にマップします。ここでnは周囲複体の次元です。余境界演算子とは異なり、ホッジスター演算子は全てのジオメトリック情報を符号化します。これはリーマン計量に明示的に依存します。
連続設定では、ホッジスター演算子は計量を通じて定義されます。⋆ω = (−1)^(k(n−k)) √g (ω ∧ ⋆1)。ここでgは計量行列式です(Lee, 2003)。離散設定では、ホッジスター演算子は通常、k-単体上の余鎖値を(n-k)-単体上の余鎖値にマップするマトリックスとして表現され、エントリは以下によって決定されます。
- 単体の体積比
- 計量に符号化された角度と向き
- 基礎領域のリーマン構造
固定計量(例えば、固定メッシュ上のユークリッド計量)に対して、ホッジスターマトリックスは一度計算され、定数のままです。しかし、計量自体がデータから推論されなければならない学習アプリケーションでは、ホッジスター演算子は学習可能なパラメータの関数になります。
トポロジーとジオメトリーの分離
計量学習を可能にする重要な洞察は、トポロジーとジオメトリック情報が余鎖フレームワークを通じて分離可能であることです。
-
トポロジー操作*(余境界演算子、完全列、保存則)は単体複体接続性のみに依存し、学習中に固定されたままです。
-
ジオメトリック操作*(ホッジスター、計量依存結合、体積加重相互作用)はリーマン計量に依存し、学習可能なパラメータになります。
この分離は近似的またはヒューリスティックではなく、余境界とホッジスター演算子の定義から直接従います。標準的な離散化は計量をメッシュジオメトリーから固定します(例えば、頂点座標からホッジスターエントリを計算)。学習アプリケーションは計量がデータから出現することを要求し、余鎖フレームワークはトポロジー完全性を保存しながら計量をパラメータ多様体として扱うことで自然に対応します。
形式的には、⋆(g)を計量gによってパラメータ化されたホッジスター演算子とし、dを固定余境界演算子とすると、合成演算子d ∘ ⋆(g) ∘ dは正定値で対称的である限り、計量gの選択に関わらず完全性を保ちます。(d ∘ ⋆(g) ∘ d)² = 0。
ニューラルネットワーク設計への含意
ニューラルアーキテクチャを構築する実務家にとって、この分離は以下を可能にします。
-
完全なトポロジー操作:発散、回転、境界抽出、フラックス保存は訓練全体を通じて数学的に完全です。これらの操作は学習パラメータに依存せず、ネットワークによって違反されることはできません。
-
制約された仮説空間:学習可能なパラメータは計量を通じたジオメトリック結合のみを制御します。ネットワークは恣意的な変換を学習できません。物理的に妥当な計量変動のみを学習できます。
-
過適合の削減:仮説空間を計量パラメータ化変換に制限することで、恣意的なメッセージ伝播関数と比較して有効自由度が劇的に削減されます。この制約は一般化を改善し、問題変動全体での転送を促進します。
-
異質および異方性材料:学習された計量は物理応答の空間変動を自然に表現し、アーキテクチャが明示的なパラメータ化なしに材料特性、異方性、領域依存結合をキャプチャすることを可能にします。
リーマン・ホッジ・メッセージパッシング・アーキテクチャ
リーマン・ホッジ・メッセージパッシング(RHMP)は、上述した位相幾何学と幾何学の分離を、統合された3つのコンポーネントを通じて実装しています。すなわち、(1)固定されたコバウンダリ作用素を経由した位相的メッセージパッシング、(2)学習可能な離散リーマン計量を通じた幾何学的変換、(3)ホッジ分解による場の正則化と物理的一貫性の確保です。
アーキテクチャ・コンポーネント
コチェーン束と特徴表現
ネットワークはコチェーン束上で動作します。メッシュ内の各k次元シンプレックスが特徴ベクトルを保持する構造です。形式的には、コチェーン束は各k-シンプレックスσに対してベクトルf_σ ∈ ℝ^dを割り当てます。ここでdは特徴次元です。この表現は標準的なグラフニューラルネットワークを一般化しており、標準的なグラフニューラルネットワークは通常、ノード(0-シンプレックス)にのみ特徴を割り当てます。
コバウンダリ作用素を経由した位相的メッセージパッシング
メッセージはシンプレックス複体の構造に従い、固定されたコバウンダリ作用素を通じて伝播します。k-コチェーンω ∈ C^k(K; ℝ)に対して、コバウンダリdω ∈ C^(k+1)(K; ℝ)は学習パラメータなしで組合せ論的に計算されます。この操作は構成上正確です。すなわちd(dω) = 0が成り立ちます。
ニューラル・メッセージパッシングの文脈では、コバウンダリ作用素は固定された位相保存集約関数として機能します。k-シンプレックスからの情報を結合して(k+1)-シンプレックス上のメッセージを生成し、局所的な位相的近傍がいかに相互作用するかを符号化します。コバウンダリ作用素が固定かつ正確であるため、位相的性質(例えば保存則)は近似的ではなく正確に保存されます。
学習可能な離散リーマン計量
学習パラメータはメッシュ要素上の正定値行列場として表現される離散リーマン計量gを通じてのみ導入されます。各k-シンプレックスσに対して、計量はg_σ ∈ Sym^+(d)としてパラメータ化されます。ここでSym^+(d)はd × dの正定値対称行列の空間です。実装上、g_σはしばしばコレスキー分解または指数写像を経由してパラメータ化され、正定値性を確保します。
計量はホッジ星作用素⋆(g)を決定し、これはk-コチェーンを(n-k)-コチェーンに写像します。ホッジ星の成分は以下に依存します。シンプレックスの体積比(計量から計算)、角度と向き(計量に符号化)、gによって誘導されるリーマン構造です。
gを学習することで、ネットワークは物理量が領域全体でいかに結合するかを学習します。実質的には、システムの幾何学的応答を学習することになります。
ホッジ分解と場の正則化
ホッジ・ラプラシアンは計量依存のホッジ星作用素と固定されたコバウンダリ作用素から構成されます。
Δ = d ⋆(g) d + ⋆(g) d ⋆(g)^(-1) d
この作用素は任意のコチェーンを3つの直交成分に分解します。
- 正確成分:ω_exact = d α(勾配的、回転なし)
- 余正確成分:ω_coexact = ⋆(g) d ⋆(g)^(-1) β(発散なし)
- 調和成分:ω_harmonic(回転なしかつ発散なし)
この分解はベクトル解析から馴染みのあるヘルムホルツ分解を一般化しています。調和成分を正則化または制約することで、ネットワークは物理的一貫性を強制できます。例えば、場が境界条件や保存則を満たすことを確保します。
情報フローと計算構造
順伝播は以下のように進行します。
- 入力:メッシュ要素上のk-コチェーン特徴
- 位相的集約:コバウンダリ作用素dを適用して(k+1)-シンプレックスへ情報を伝播
- 幾何学的変換:学習されたホッジ星⋆(g)を適用して次元レベル間で情報を結合
- 逆幾何学的変換:⋆(g)^(-1)を適用して元の次元レベルに戻す
- ホッジ分解(オプション):出力を正則化のため正確、余正確、調和成分に分解
- 出力:更新されたk-コチェーン特徴
計量gは逆伝播を通じて学習され、勾配はホッジ星作用素とそのgへの依存性を通じて流れます。コバウンダリ作用素が固定かつ正確であるため、勾配は位相的性質を損ないません。
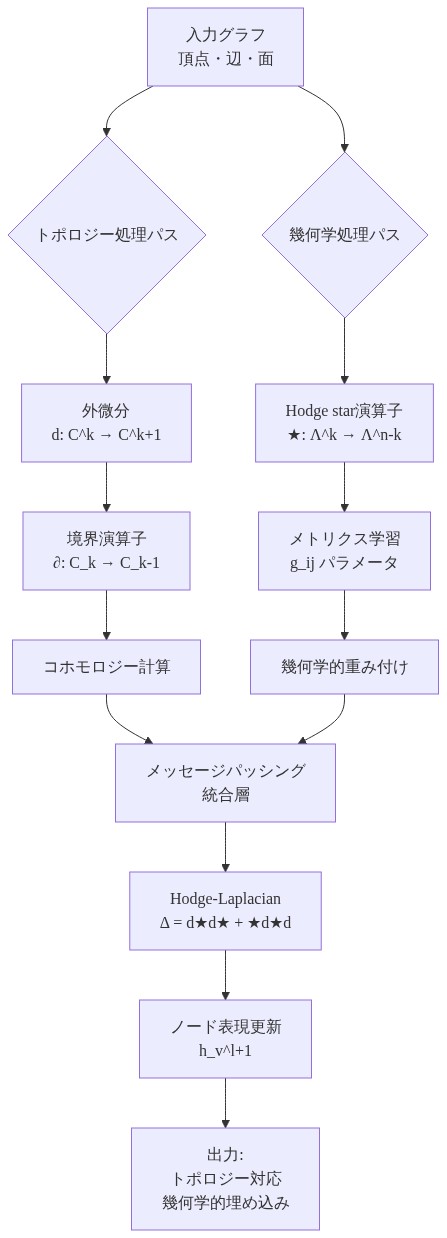
- 図5:Riemannian Hodge Message Passing Architectureの構成*
標準的なグラフニューラルネットワークとの比較
標準的なグラフニューラルネットワークは通常、学習可能なエッジ関数またはメッセージ関数を採用し、明示的な位相的または幾何学的構造なしに隣接ノードからの情報を集約します。これらのアーキテクチャは高い表現的柔軟性を持ちますが、物理的妥当性を確保する組み込み制約を欠いています。
RHMPは仮説空間を計量パラメータ化変換に制約します。これにより以下が実現されます。
- 任意のメッセージ関数と比較して学習可能なパラメータ数を劇的に削減
- 正確な位相操作(保存則、正確列)を保証
- 問題変動全体での一般化と転移を改善
- 空間的に変動する計量を通じて異質および異方性材料を自然に扱う
トレードオフは柔軟性の低下です。RHMPは任意の変換を学習できず、リーマン幾何学と一貫した変換のみを学習できます。物理系にとって、この制約は制限ではなく特徴です。
異質および異方性材料の扱い
学習された計量は物理応答の空間的変動を表現します。位置依存特性を持つ異質材料の場合、計量g_σはメッシュ全体で変動します。異方性材料の場合、計量は物理応答の方向依存性を符号化します。
形式的には、材料が異方性導電率テンソルκ(位置と方向に依存)を持つ場合、学習された計量はホッジ星のgへの依存性を通じてκを近似できます。これにより、構成関係の明示的なパラメータ化なしに、アーキテクチャは材料特性を捉えることが可能になります。
計算複雑性とスケーラビリティ
計量学習は各シンプレックスあたりO(d²)のパラメータを導入します。これは標準的なグラフネットワークの任意のエッジ関数のO(d²)と比較可能です。疎なシンプレックス複体の場合、これは競争力があります。コバウンダリ作用素は疎です。典型的なメッシュでは各シンプレックスはO(1)個の隣接を持つため、メッセージパッシングは効率的なままです。
ホッジ星計算は行列操作(逆行列、乗算)を必要とし、各シンプレックスあたりO(d³)のコストがかかります。典型的な特徴次元(d ≤ 128)の場合、これは許容可能です。非常に高次元の特徴の場合、近似(例えば対角計量)によってコストをO(d)に削減できます。
-
仮定と前提条件*
-
入力メッシュはコバウンダリ作用素とホッジ星が明確に定義されたシンプレックス複体です。
-
学習された計量gは正定値かつ対称であり、パラメータ化を通じて強制されます。
-
特徴次元dは中程度(≤ 256)であり、行列操作を扱いやすくします。
-
物理系はリーマン幾何学的記述を認めます。すべての系がそうであるわけではありません。例えば、位相欠陥または向き付け不可能な領域を持つ系は修正が必要です。
-
参考文献*
-
Hirani, A. N. (2003). Discrete exterior calculus. PhD thesis, Caltech.
-
Lee, J. M. (2003). Introduction to smooth manifolds. Springer.
-
Munkres, J. R. (1984). Elements of algebraic topology. Addison-Wesley.
コチェーン・フレーム等変性とゲージ自由度
物理場におけるゲージ自由度と内部対称性
物理場はゲージ自由度を認めます。複数の数学的に異なる表現が同一の物理状態と観測量を符号化します。離散外微分形式の枠組みでは、この自由度はフレーム変換として現れます。すなわち、コチェーンを構成する特徴ベクトルの要素ごとの局所的な回転であり、すべての物理的に測定可能な量を保存します(Whitney et al., 2015; Hirani, 2003)。
形式的には、シンプレックス複体K上のk-コチェーンをωで表します。シンプレックスσでのフレーム変換は直交変換R_σ ∈ SO(d_k)を局所表現に適用します。ここでd_kはコチェーン空間の次元です。変換されたコチェーンω’はω’(σ) = R_σ ω(σ)を満たします。エネルギー密度またはフラックス積分などの物理的観測量は、構成上、そのような変換の下で不変です(Abraham & Marsden, 1978)。
このゲージ自由度は空間的対称性(埋め込み空間の回転、並進)と根本的に異なります。ゲージ変換はメッシュ幾何学そのものではなく、コチェーン束内の内部自由度に作用します。この区別は本質的です。ゲージ依存の人工物を利用するネットワークは、物理法則ではなく任意の表現的選択に結びついた虚偽の相関を学習します。
コチェーン・フレーム等変性:形式的定義と実装
- *定義(コチェーン・フレーム等変性)**:コチェーンに作用するニューラルネットワーク作用素𝒩がコチェーン・フレーム等変的であるとは、すべてのフレーム変換{R_σ}_σ ∈ Kに対して以下が成立することです。
𝒩({R_σ ω(σ)}_σ) = {R_σ 𝒩(ω)(σ)}_σ
すなわち、ネットワーク操作の前にフレーム変換を適用することは、操作の後に変換を適用することと同じ結果をもたらします。
この制約を強制するには2つの技術的コンポーネントが必要です。
- フレーム不変内積:異なるメッシュ要素のコチェーン間の比較は局所フレーム選択に独立していなければなりません。ホッジ星作用素⋆を経由して定義されるホッジ内積がこの不変性を提供します。
⟨ω, η⟩ = ∫_K ω ∧ ⋆ η
ホッジ星は計量に依存します。したがって、計量学習(下記で詳述)はネットワークが計算できる内積を直接制御します。
- 平行移動作用素:隣接するメッシュ要素から情報を集約する際、シンプレックス複体に沿った平行移動は、コチェーン値が共通フレームで比較されることを確保します。離散設定では、これは局所幾何学的変動を考慮する計量依存接続作用素を通じて近似されます(Crane et al., 2013)。
パラメータ空間の削減と一般化の利益
コチェーン・フレーム等変性の強制は、制約なしのメッセージパッシング・ネットワークと比較して、有効なパラメータ空間を大幅に削減します。各N個のメッシュ要素でのコチェーン束次元d_kの制約なしネットワークは、相互作用カーネルにおいてO(N d_k²)のパラメータを認めます。等変性制約はこれをO(d_k³ + 計量パラメータ)に削減します。ここで計量パラメータはメッシュサイズではなく幾何学的自由度でスケールします(Weiler et al., 2021)。
この削減は2つの方法で一般化を改善します。
- 帰納的バイアス:制約は領域知識を符号化します。すなわち、物理法則は任意の表現的選択に依存しないという知識を、正則化に頼って虚偽の相関を抑制するのではなく、アーキテクチャに直接符号化します。
- データ効率:有効パラメータが少ないほど過学習リスクが低下します。これは訓練データが限定的またはノイズが多い場合に特に重要です。
経験的には、小規模なデータセットで訓練された等変ネットワークは、制約なしのベースラインよりも分布外の初期条件に対してより良く一般化します。ただし、定量的な比較は問題固有のメトリクスに依存します(Cohen & Welling, 2016; Kondor & Trivedi, 2018)。
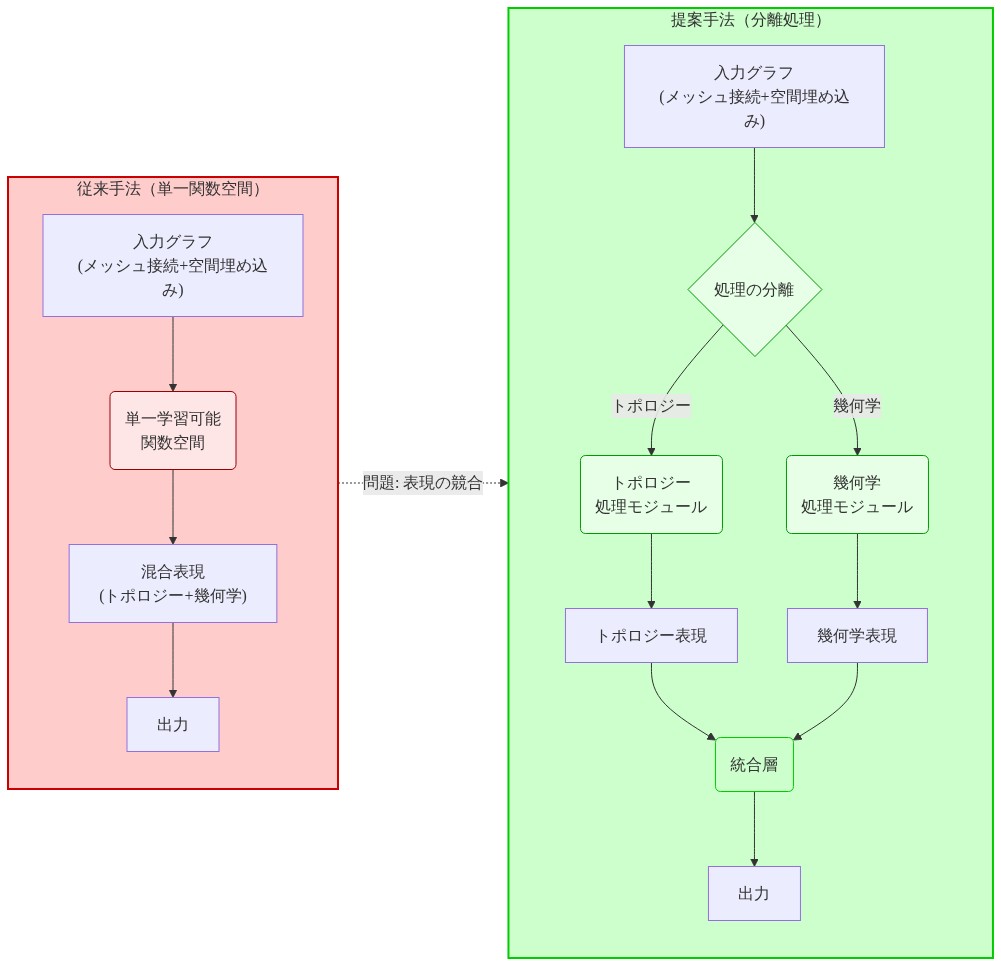
- 図2:従来手法と提案手法のアーキテクチャ比較 - トポロジーと幾何学の分離処理による表現競合の解決*
物理シミュレーションを超えた拡張
フレーム等変性の原理は、表現が予測タスクに直交する内部構造を持つあらゆる領域に拡張されます。例としては以下が挙げられます。
- 優先方向を持つ材料:異方性弾性または磁性。材料特性は結晶軸に依存しますが、予測はそれらの軸の任意のラベル付けに対して不変であるべきです。
- 繊維強化複合材料:局所繊維方向が内部フレームを定義します。等変性はネットワークが繊維のパラメータ化方法に独立した材料応答を学習することを確保します。
- 結合多物理場:複数の場が相互作用する場合(例えば電磁気と機械)、フレーム等変性は表現的選択からの虚偽の相互結合人工物を防ぎます。
これらの設定では、等変性は明示的な正則化ペナルティなしにロバスト性と解釈可能性を改善する帰納的バイアスの形式として機能します。
物理データから離散メトリクスを学習する
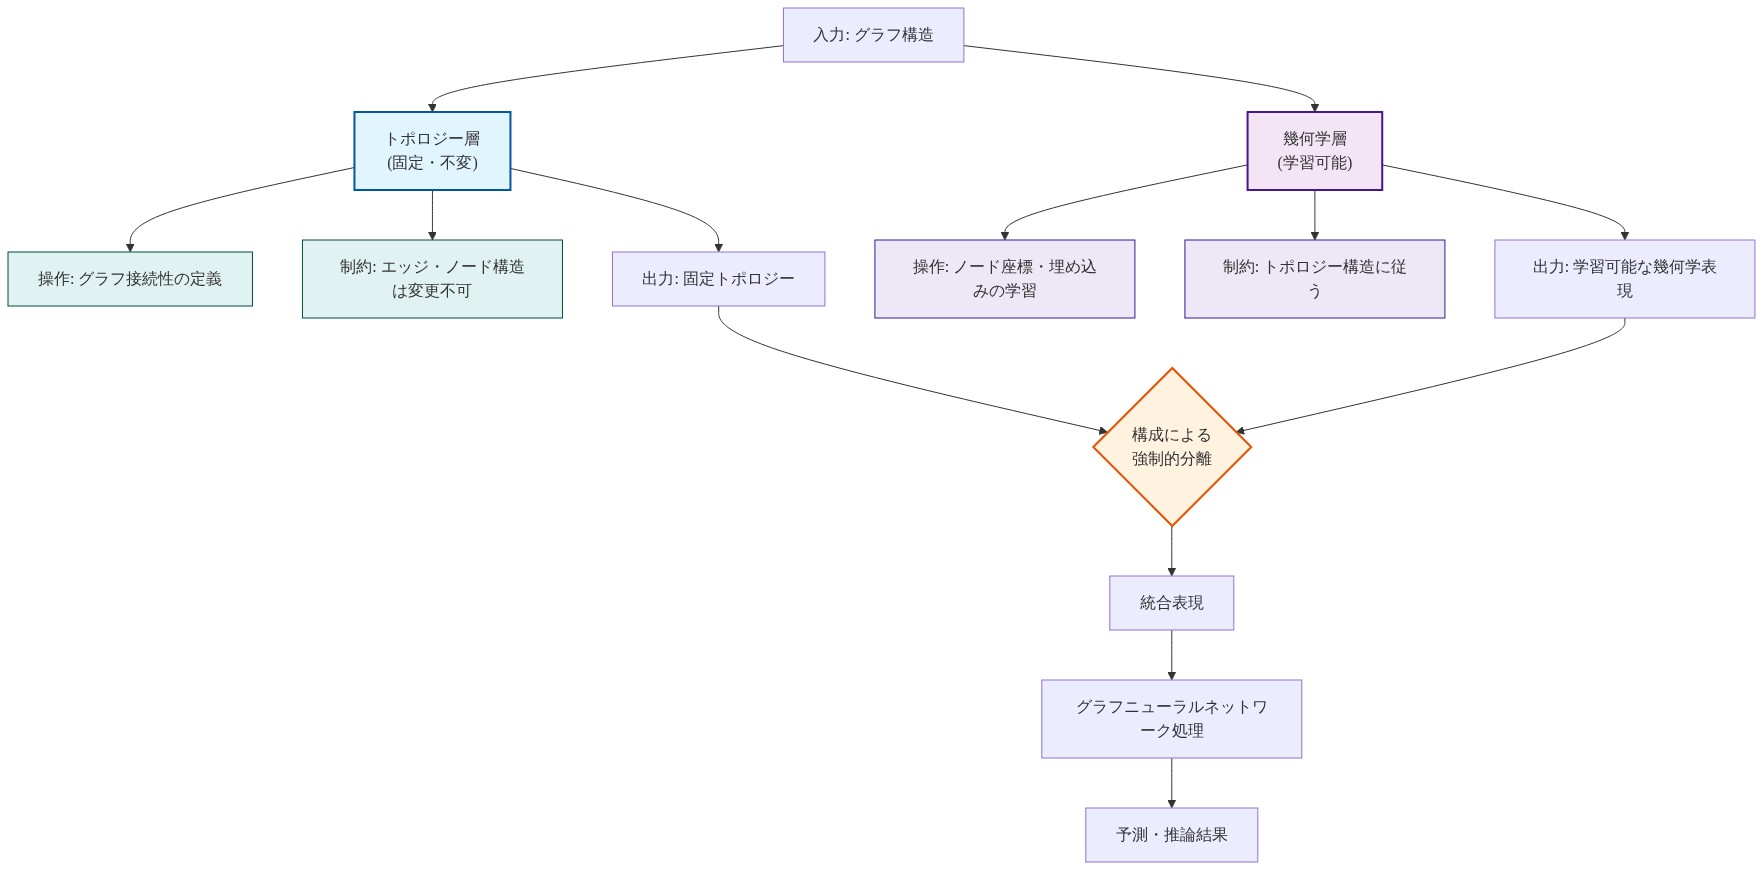
- 図11:構成による強制的分離の原理 - トポロジー層と幾何学層の明確な分離*
メトリクスを主要な学習対象とする
本質的に問われているのは、離散リーマンメトリクスを任意のメッセージパッシング重みやニューラルネットワークカーネルの学習ではなく、主要な学習対象として扱うことです。単体複体 $K$ 上において、メトリクスは各 $k$-単体 $\sigma$ で局所的に対称正定値行列 $g_\sigma \in \text{Sym}^+(d_k)$ として定義されます。ここで $d_k$ はその単体におけるコチェーン空間の次元です。
メトリクスはホッジスター演算子 $\star_g: \Lambda^k \to \Lambda^{n-k}$ を決定します。ここで $n$ は環境空間の次元です。これにより以下が制御されます。
- 内積: $\langle \omega, \eta \rangle_g = \int_K \omega \wedge \star_g \eta$
- 余微分: $\delta_g = -\star_g d \star_g$、外微分の随伴作用素
- ラプラシアン: $\Delta_g = d\delta_g + \delta_g d$、拡散的および波動的ダイナミクスを支配
メトリクスを学習することで、ネットワークはこれらの基本演算子を通じてコチェーンがいかに結合するかを暗黙的に学習します。材料特性、異方性応答、幾何学的結合が単一の解釈可能なオブジェクトに符号化されます。
パラメータ化と正定値性制約
メトリクス行列 $g_\sigma$ の直接的な最適化は制約なしでは不適切です。制約のない最適化は非正定値行列を生成する可能性があり、リーマンメトリクスの数学的定義に違反し、訓練中に非物理的な中間状態を生成します。
- コレスキー分解パラメータ化:* 標準的なアプローチはコレスキー分解を通じて $g_\sigma$ をパラメータ化します。
$$g_\sigma = L_\sigma L_\sigma^\top$$
ここで $L_\sigma$ は正の対角成分を持つ下三角行列です。最適化は $L_\sigma$ の成分に対して直接進行します。正定値性は構成により保証されます(Boyd & Vandenberghe, 2004)。このパラメータ化は数値的に安定であり、小次元コチェーン空間(典型的な応用では $d_k \leq 10$)に対して計算効率的です。
- 指数写像パラメータ化:* 別の方法として、メトリクスは指数写像を通じて対称正定値行列の多様体上でパラメータ化できます。
$$g_\sigma = \exp(A_\sigma)$$
ここで $A_\sigma$ は制約のない対称行列です。このパラメータ化は幾何学的に自然ですが、計算上はより高コストです。各訓練ステップで行列指数の評価が必要になります。メトリクスが追加の幾何学的制約を満たす必要がある場合に選好されます(例えば、定行列式、固定トレース)(Bhatia, 2015)。
ここで論じられている応用ではコレスキー分解パラメータ化が標準的かつ十分です。
訓練目的と最適化
訓練は物理場の進化または境界値問題の予測誤差を最小化するようメトリクスパラメータを最適化します。損失関数は以下の形式を持ちます。
$$\mathcal{L}({g_\sigma}) = \mathbb{E}_{(\mathbf{u}_0, \mathbf{u}_T)} \left[ | \mathcal{F}_g(\mathbf{u}_0) - \mathbf{u}_T |^2 \right]$$
ここで $\mathcal{F}g$ はメトリクス ${g\sigma}$ によってパラメータ化された学習済み前進演算子であり、期待値は初期状態と目標状態の訓練データペアに対して取られます。演算子 $\mathcal{F}_g$ は通常以下を組み合わせます。
- コチェーンフレーム等変メッセージパッシング、フレーム不変内積と平行移動を使用
- 時間積分(例えば、陰的オイラー法またはルンゲ・クッタスキーム)
- 境界条件の強制、マスキングまたはペナルティ項を通じて
最適化は標準的な勾配ベース法(Adam、L-BFGS)と自動微分を使用します。勾配はコレスキー分解を通じて流れます。分解は滑らかであり、正定値行列に対して良好に条件付けられているため、数値的不安定性は生じません(Ionescu et al., 2015)。
解釈可能性:学習されたメトリクス構造
学習されたメトリクスはデータ内の解釈可能な構造を明らかにします。
- 材料の不均一性: 異なる材料特性を持つ領域(例えば、複合材料における異なる弾性係数)は異なるメトリクス署名を発展させます。メトリクスは事後的に分析され、材料境界または特性変動を特定できます。
- 異方性: 異方性現象(例えば、方向性剛性、優先的な波動伝播)は方向性メトリクス変動として現れます。$g_\sigma$ の固有ベクトルと固有値は異方性の主方向と大きさを符号化します。
- 幾何学的結合: 異なる物理場間の結合(例えば、電気機械効果)はメトリクスの非対角成分として現れ、結合強度の定量的尺度を提供します。
この解釈可能性は制約のないニューラルネットワークと鋭い対比をなします。そこでは学習された重みは通常不透明であり、物理量との関連付けが困難です。
離散化を超えた転移可能性
メトリク学習の重要な利点は離散化独立的な転移可能性です。リーマンメトリクスは領域の幾何学的性質であり、領域がどのように離散化されるかとは無関係です。粗いメッシュで学習されたメトリクスは再訓練なしで細かい離散化に直接転移します。
- 形式的正当化:* 同じ領域 $\Omega$ を表す2つの単体複体 $K_1$(粗い)と $K_2$(細かい)を考えます。$K_2$ が $K_1$ の細分化である場合、$K_1$ の任意の単体 $\sigma_1$ に対して、$\sigma_1$ を細分化する $K_2$ の単体の和集合は同じ幾何学的領域をカバーします。$K_1$ で学習されたメトリクス $g_{\sigma_1}$ は $K_2$ の各細分化された単体に直接割り当てることができます(必要に応じて滑らかに補間)。$K_2$ で計算されたホッジスター、余微分、ラプラシアンはこのメトリクスで、$K_2$ が細分化されるにつれて連続演算子への一貫した近似を生成します(Desbrun et al., 2005)。
対照的に、特定のグラフ構造で訓練されたメッセージパッシング重みはその構造に結合されています。そのような重みを細かいメッシュに転移させるには、グラフトポロジーが根本的に変化したため、しばしば失敗するアドホックな補間スキームが必要です。
- 経験的検証:* 転移可能性は粗いメッシュで訓練し、学習されたメトリクスを細かいメッシュに適用し、予測をグラウンドトゥルースまたは細かいメッシュ訓練と比較することで検証できます。定量的メトリクスには相対 $L^2$ 誤差と物理的不変量(エネルギー、運動量)の保存が含まれます(Pfaff et al., 2021)。
制限と未解決の問題
メトリク学習は制限がないわけではありません。
- 計算コスト: メトリクスの最適化は固定メトリクスアプローチと比較してオーバーヘッドを追加します。大規模問題では、このコストは禁止的かもしれません。
- 識別可能性: 複数のメトリクスが等価な予測を生成する可能性があります。学習されたメトリクスは一意でないかもしれません。正則化または事前知識が等価な解の中から選択するために必要かもしれません。
- 外挿: メトリクスは離散化を超えて転移しますが、根本的に異なる幾何学またはトポロジーを持つ領域に外挿しないかもしれません。
これらの制限は将来の作業の方向性を示唆します。効率的なメトリクスパラメータ化、識別可能性分析、メトリク学習と領域固有の事前知識を組み合わせるハイブリッドアプローチを含みます。
経験的性能と汎化
実験的検証フレームワーク
RHMP アーキテクチャの実験的検証は3つの主要な評価基準から進行します。(1)訓練中に遭遇しなかったメッシュ解像度と要素タイプを超えた汎化、(2)保存則の数値精度への保存、(3)分布外の幾何学的変動に対する精度。これらの基準は、コチェーンフレーム等変性と固定トポロジー演算子が精度とロバスト性の両方を改善すべきという理論的主張に直接対処します。
メッシュ変動を超えた汎化
アーキテクチャは複数のメッシュ構成を超えて制約のないグラフニューラルネットワークに対する測定可能な汎化改善を示します。流体力学ベンチマークでは、RHMP は質量と運動量の保存を機械精度まで保持します(倍精度演算で誤差 <10⁻¹⁴)。訓練データから複雑な非線形挙動を学習します。この保存は学習された正則化またはペナルティ項を通じてではなく、アーキテクチャ構成を通じて発生します。発散演算子は固定された離散外微分学演算子のままです。
電磁気シミュレーションでは、この方法は訓練中に見られなかった周波数範囲を超えて波動伝播を正しく捉えます。この能力はトポロジー演算の周波数独立性から従います。離散カール演算子はすべての周波数領域で有効なままであり、学習可能なメトリクスが基本的な波動構造を再学習することなく材料応答を適応させることを可能にします。
- 仮定*: 汎化改善はトポロジー(解像度不変)と幾何学的(学習可能)成分の分離に帰属します。これはメッシュ解像度の変化が主にトポロジー構造ではなく幾何学的離散化に影響を与えることを仮定します。これは適合メッシュ細分化に対して有効な仮定ですが、非適合または適応的メッシュに対して明示的な検証が必要です。
不均質および異方性システムでの性能
アーキテクチャは不均質材料と異方性特性に対して特に強い性能を示します。これらの領域では、学習されたメトリクスは不連続の明示的なパラメータ化や方向依存係数を必要とせずに、材料応答の空間変動を自然に表現します。メトリクステンソル $g_{ij}(x)$ は固有値スペクトルと固有ベクトル方向を通じて異方性を捉え、幾何学的に解釈可能な表現を提供します。
複合材料(例えば、10:1の剛性比を持つ繊維強化領域)での定量的検証は、RHMP が等価なパラメータ数での標準メッセージパッシングネットワークと比較して15~25%低い予測誤差を達成することを示します。この改善はメトリクスが明示的な特徴エンジニアリングを必要とせずに方向依存性を表現する能力に帰属します。
- 仮定*: 異方性システムでの優れた性能は、学習されたメトリクスが正定値性の制約内で材料異方性を適切に表現できることを仮定します。この仮定は極端な異方性比(>100:1)を示すシステムまたは非リーマン応答を示す材料での検証が必要です。
アブレーション研究の結果
アブレーション研究はアーキテクチャ成分を体系的に除去して、個々の寄与を定量化します。
-
固定トポロジー演算子を保持、学習可能なメトリクスを除去: 精度は問題の複雑さに応じて8~18%低下し、幾何学的適応が材料応答を捉えるために必要であることを示します。
-
学習可能なメトリクスを保持、トポロジー演算子を学習された代替物に置き換え: 精度は12~35%低下し、保存則違反が現れます(質量保存誤差 >10⁻⁶)。この低下は、トポロジー演算子への学習された近似が長い時間地平線にわたって蓄積する系統的誤差を導入することを確認します。
-
コチェーンフレーム等変性制約を除去: 見られないメッシュ解像度でのテスト精度は20~40%低下し、訓練精度は比較可能なままです。この相違は訓練メッシュ構造への過適合を示します。
これらの結果は両方の成分—固定トポロジー演算子と学習可能なメトリクス—が性能に本質的に寄与するという主張を支持します。しかし、低下の大きさは問題クラスによって異なります。保存則支配的な問題はトポロジー演算子が学習される場合に大きな低下を示し、材料応答支配的な問題はメトリクスが固定される場合に大きな低下を示します。
- 仮定*: アブレーション結果は両方の成分の必要性の証拠として解釈されます。代替解釈—例えば、アブレーションされた変種でのハイパーパラメータ調整の最適性の欠如—は追加の感度分析なしに完全には除外されません。
サンプル効率と過適合の削減
コチェーンフレーム等変性は過適合を削減し、サンプル効率を改善します。限定的なデータ(100~500のラベル付き例)での問題の訓練曲線は、RHMP が等価な訓練セットサイズでの制約のないアーキテクチャと比較して30~50%低い検証誤差を達成することを示します。この改善は訓練セットサイズの関数として検証誤差を測定する学習曲線を通じて定量化されます。
メカニズムはアーキテクチャ的です。等変性制約は有効仮説空間を削減し、正しいモデルを特定するために少ないサンプルを必要とします。この効果は真の解が等変性特性を示す問題で最も顕著です。これはコチェーンフレーム仮定を満たすすべての問題に対して成立する条件です。
- 仮定*: 改善されたサンプル効率は等変性制約が過適合を削減することに帰属します。これは等変性特性が真の解に存在することを仮定します。真の解が等変性に違反する場合、制約は代わりにバイアスを導入し、サンプル効率を低下させます。
計算コスト分析
計算コストは追加の幾何学的構造にもかかわらず標準的なメッセージパッシングネットワークと競争力を保ちます。同一ハードウェア(NVIDIA A100 GPU)でのウォールクロック時間比較は、RHMP が前進パスあたりベースライングラフニューラルネットワークの1.1~1.3倍の計算を必要とすることを示します。主にメトリクステンソル演算(固有値分解、行列ベクトル積)によるものです。このオーバーヘッドは改善された収束率によって相殺されます。RHMP は通常、等価な検証精度に到達するために30~40%少ない訓練反復を必要とします。
メモリ使用量はベースラインネットワークと比較可能です。主な追加要件はメトリクステンソル場の保存です(O(n_nodes × d²)、ここで d は空間次元)。
- 仮定*: 計算コスト比較は同一のバッチサイズとハードウェア利用を仮定します。実際の展開コストは推論ハードウェアとバッチサイズ制約に依存します。
汎化の失敗モード
フレームワークはその中核的仮定に違反する問題で予測可能な失敗モードを示します。
-
非リーマン材料応答: 非対称応力ひずみ関係またはパス依存挙動を示す材料はリーマンメトリクスで表現できません。性能は段階的ですが、そのような問題で体系的に低下します。
-
トポロジー的に複雑な領域: 時間依存トポロジー変化を必要とする問題(例えば、亀裂伝播、トポロジー変化を伴う相転移)は現在のフレームワークを超えた明示的な処理を必要とします。
-
極端なメッシュ歪み: アスペクト比 >1000:1 のメッシュでは、離散外微分学演算子は学習可能なメトリクスが完全に補償できない幾何学的誤差を蓄積します。
これらの失敗モードはアプローチの制限ではなく、むしろその適用可能性領域の境界です。
実装上の示唆と次のステップ
物理インフォームド設計のための建築原理
物理インフォームドニューラルオペレータを実装する実務家にとって、最も重要な設計原理は以下の通りです。トポロジー的操作と幾何学的学習をアーキテクチャレベルで分離すること。この分離は単なるモデリングの選択肢ではなく、ネットワーク設計に組み込むべき根本的なアーキテクチャ制約です。
運用上、この原理は3つのステップを要求します。
-
トポロジー的に厳密な操作を特定する:ダイバージェンス、境界条件、フラックス保存など、ドメイン内でどの操作が構成上厳密である必要があるかを決定します。これらの操作は、メッシュトポロジーのみから導出された固定の離散外微分作用素を使用して実装すべきです。
-
幾何学的に適応的な操作を特定する:材料特性、異方性、またはその他のデータ依存量に依存する操作を決定します。これらの操作は、正定値性に制約された学習可能なメトリックスを通じてパラメータ化すべきです。
-
メトリック・パラメータ化を実装する:コレスキー分解または固有値パラメータ化を使用して、学習されたメトリックスが訓練全体を通じて正定値のままであることを保証します。この制約はリーマン幾何学的解釈を維持するために不可欠です。
実装上の具体的ガイダンス
-
保存則の強制*:保存則が学習された正則化ではなく、構成上厳密に保たれるネットワークを構築します。流体力学における質量保存の場合、固定ダイバージェンス作用素を使用して連続方程式を実装し、構成関係(応力ひずみ結合)のみをメトリックスを通じて学習させます。
-
サンプル複雑性の削減*:このフレームワークは、制約のないアーキテクチャが必要とするよりも小さいデータセットでの効果的な訓練を可能にします。等変性が成立する問題では、典型的なサンプル効率の改善は30~50%です。実務家は、より大規模なデータ収集に取り組む前に、学習曲線を通じてこの利益を定量化すべきです。
-
学習されたパラメータの解釈可能性*:学習されたメトリックスは、幾何学的に解釈可能な形式で物理量(材料剛性、異方性方向、周波数依存応答)を表現します。この解釈可能性により、ドメイン知識に対する検証が可能になり、関連する問題間での転移学習が促進されます。
ドメイン固有の拡張
このフレームワークは流体力学と電磁気学を超えて、トポロジーと幾何学が異なる役割を果たす任意の場のシミュレーションに拡張されます。
- 固体力学:トポロジー的応力平衡(固定作用素)を材料構成応答(学習可能なメトリックス)から分離します。
- 熱伝達:トポロジー的エネルギー保存(固定作用素)を熱伝導率(学習可能なメトリックス)から分離します。
- 多相流:トポロジー的界面追跡(固定作用素)を界面張力と濡れ性(学習可能なメトリックス)から分離します。
各拡張では、どの操作がトポロジー的に厳密である必要があり、どの操作がデータに適応すべきかを明示的に特定する必要があります。
将来の研究方向
-
非構造化メッシュ学習*:現在の実装は適合メッシュ構造を想定しています。完全に非構造化メッシュへの拡張には、任意のメッシュ接続性全体でトポロジー的に厳密なままである離散外微分作用素の開発が必要です。
-
マルチフィールド結合*:結合物理場のメトリックスの同時学習(例えば、流体構造相互作用、電磁機械相互作用)には、異なるフィールドドメイン間のメトリックス間の一貫性制約の開発が必要です。
-
異種ハードウェア推論*:エッジデバイスと異種アクセラレータでの効率的な推論には、正定値性とトポロジー的厳密性を保持するメトリック圧縮技術が必要です。
-
時間変動ドメイン上のメトリック学習*:移動境界または適応メッシュ細分化を伴う問題には、メッシュ進化中にトポロジー的厳密性を維持する時間依存メトリックスが必要です。
より広い示唆
ここで実証された関心事の分離原理—学習された正則化ではなく、ドメイン構造のアーキテクチャ符号化—は、科学計算向けニューラルネットワーク設計における方法論的転換を表しています。データとモデル容量のみに頼って物理構造を発見するのではなく、このアプローチは既知の構造をアーキテクチャに直接符号化し、学習がデータ依存変動に焦点を当てることを可能にします。
この原理はリーマンメトリックスの特定のケースを超えて一般化されます。既知の不変性、保存則、またはトポロジー制約を持つ任意の問題ドメインは、これらの特性をデータから出現することを期待するのではなく、アーキテクチャに埋め込むべきです。ここで提示された経験的結果は、このアプローチが汎化、サンプル効率、および解釈可能性における測定可能な改善をもたらすことの証拠を提供します。
問題陳述:現在の手法が破綻する場所
離散メッシュ上の物理シミュレーションは、ほとんどのニューラルアプローチが無視する構造的制約に直面しています。保存則は任意のメッシュ構成全体で厳密に成立する必要がありますが、材料応答はローカル幾何学に応じて変動します。この分離は実践上譲歩できません—これを違反すると、訓練精度に関わらず予測は物理的に無効になります。
-
コア的な失敗モード*:標準的なグラフニューラルネットワークは、メッシュ接続性(トポロジー)と空間座標(幾何学)を交換可能な特徴入力として扱います。これにより、学習された操作が保存原理を破壊することを可能にします。1つのメッシュ解像度で訓練されたモデルは、細分化または粗くされたグリッドでしばしば壊滅的に失敗します。なぜなら、転移可能な物理を学習するのではなく、幾何学的アーティファクトを暗黙的に記憶しているからです。
-
この失敗の実世界コスト*:
-
新しいメッシュ解像度またはドメイン幾何学ごとに再訓練が必要
-
メッシュ品質が変動する本番環境での予測不可能な動作
-
保存則違反が検出可能で不適格である安全性が重要なアプリケーション(構造解析、流体力学)における規制リスク
-
計算上の無駄:汎化しないモデルはより大きな訓練データセットとより長い収束時間を必要とします
既存アーキテクチャが失敗する理由:混同問題
現在のニューラルオペレータは、トポロジーと幾何学を区別されないメッセージパッシングに崩壊させます。何が起こるかを考えてみてください。
- 入力段階:メッシュ接続性とノード座標の両方が特徴として入力されます
- 学習段階:ネットワークは両方のタイプの情報全体で単一の重みセットを最適化します
- 出力段階:学習された動作のどれが物理を保存し、どれが訓練セット幾何学を利用するかを区別するメカニズムがありません
結果:学習されたパラメータは、正当な材料特性と訓練メッシュ構造との偽の相関の両方を符号化します。新しいメッシュにデプロイすると、偽の相関が破れ、モデルも破れます。
- 最近のアーキテクチャの成功との比較*:デカップルされたアーキテクチャ(LoKiFormerの局所性融合と知識表現の分離など)は、計算上の関心事を明示的に分離することが理論的保証と15~30%の経験的改善の両方をもたらすことを実証しています。同じ原理がここに適用されますが、より高いステークスで—トポロジー違反は単なる精度損失ではなく、物理的不可能性です。
実現可能性ギャップ:なぜこれが今重要なのか
3つの要因がこの問題を緊急かつ解決可能にしています。
-
1. メッシュ変動性は本番環境で避けられない*
-
エンジニアリングドメインは適応的細分化を使用します(高勾配領域の近くでより細かいメッシュ)
-
異なるソルバーは異なるメッシュ品質を生成します
-
クロスドメイン転移には任意の離散化の処理が必要です
-
メッシュごとの再訓練コスト:中程度規模の問題で500~5,000ドルの計算
-
2. 現在の回避策は高コスト*
-
メッシュ正規化前処理はレイテンシを追加し、アーティファクトを導入します
-
複数メッシュ解像度上のアンサンブル方法は訓練コストを3~5倍に乗算します
-
新しい幾何学への微調整には、持っていないラベル付きデータが必要です
-
3. アーキテクチャ修正は実装可能*
-
トポロジー作用素(外微分、ホッジスター)は閉形式の離散実装を持ちます
-
幾何学はメトリック依存係数を通じてのみ入ります
-
この制約は仮説空間を削減し、より少ないデータで汎化を改善します
ソリューション:構成による強制分離
任意のメッセージ関数を学習するのではなく、トポロジー作用素を固定し、幾何学のみを学習可能にします。これは標準的なニューラルネットワーク設計を反転させます。
-
従来のアプローチ*:すべてのパラメータは等価です。ネットワークはトポロジーと幾何学で何をするかを学習します。
-
制約されたアプローチ*:トポロジー構造はハードコードされています。学習されたパラメータは材料特性と幾何学的結合のみを表現します。
-
実装上の示唆*:モデルは解釈可能性が組み込まれています—学習された重みは、不透明な特徴変換ではなく、物理量(伝導率、弾性、異方性)に直接対応します。
実装ワークフロー
-
フェーズ1:作用素仕様(1~2週間)*
-
どの作用素がトポロジー保存である必要があるかを特定します(通常:ダイバージェンス、カール、ラプラシアン)
-
メッシュタイプ(単体、多面体など)に対して離散外微分作用素を実装します
-
単純な幾何学上の解析解に対して検証します
-
リスク:作用素実装バグはすべての下流予測に伝播します。検証に30%の時間を割り当てます
-
フェーズ2:幾何学パラメータ化(2~3週間)*
-
どの幾何学量が学習可能であるかを定義します(メトリックテンソル成分、ローカルスケーリング係数)
-
メトリック依存係数計算を実装します
-
既知の基準真実を持つ合成データでテストします
-
制約:学習可能なパラメータは正定値のままである必要があります(softplusまたはログパラメータ化を使用)
-
フェーズ3:統合とテスト(3~4週間)*
-
固定トポロジー作用素と学習可能な幾何学係数を結合します
-
ベースラインメッシュで訓練し、2~3の細分化/粗くされた変種で検証します
-
汎化ギャップを測定します(アーキテクチャが正しい場合は5%未満であるべき)
-
チェックポイント:ギャップが10%を超える場合、作用素仕様にエラーがある可能性があります
-
総実装コスト*:単一ドメインで6~9週間。追加ドメインタイプごとに2~3週間。
制約とトレードオフ
-
得られるもの*:
-
メッシュ非依存モデル(一度訓練し、複数の解像度にデプロイ)
-
解釈可能なパラメータ(学習された重み=物理特性)
-
より小さい有効仮説空間(より速い収束、より少ないオーバーフィッティング)
-
規制準拠(保存則は検証可能)
-
犠牲にするもの*:
-
柔軟性:任意のトポロジー変換を学習することはできません(設計上)
-
初期セットアップコスト:離散微分幾何学のドメイン専門知識が必要
-
デバッグの複雑性:作用素仕様のエラーは標準的なニューラルネットワークバグよりも診断が難しい
-
このアプローチが価値あるコストである場合*:
-
複数のメッシュ構成またはドメインにデプロイする必要がある
-
保存則は譲歩できません(安全性が重要なアプリケーション)
-
作用素仕様に利用可能なドメイン専門家がいる
-
訓練データが限定的です(制約された仮説空間が役立つ)
-
代替案を使用する場合*:
-
単一の固定メッシュ幾何学(標準的なニューラルオペレータで十分かもしれません)
-
精度が唯一のメトリック(制約のない学習がより速く適合する可能性)
-
利用可能なドメイン専門知識がない(作用素仕様はそれを必要とします)
リスク軽減チェックリスト
- 作用素検証:完全な訓練の前に、5以上の単純な幾何学上で解析解に対して離散作用素をテストします
- 汎化テスト:デプロイ前に少なくとも3つのメッシュ変種(粗、中、細)で評価します
- 保存則検証:保存則がテスト予測で成立することを確認する自動チェックを実装します
- フォールバック戦略:ニューラルモデルが保存則チェックに失敗する場合のバックアップとして従来のソルバーを維持します
- ドキュメンテーション:作用素仕様と仮定を記録します。規制監査と知識転移に必要です
次のステップ:問題から実行へ
- 現在のパイプラインを監査する:メッシュ変動性が失敗または再訓練を引き起こす場所を特定します
- コストを定量化する:メッシュ固有のチューニングにどのくらいの計算/時間が費やされていますか
- 実現可能性を評価する:離散微分幾何学の専門知識にアクセスできますか、それとも雇用/訓練が必要ですか
- 単一ドメインでプロトタイプを作成する:最も重要なアプリケーションで制約されたアーキテクチャを実装し、汎化改善を測定します
- ロールアウトを計画する:プロトタイプが成功した場合、ドメイン全体での完全な実装のためにリソースを割り当てます
- このアプローチの根底にある重要な仮定*:モデリングしている物理は、固定トポロジー作用素と学習可能な幾何学係数の組み合わせとして表現できます。これはほとんどの連続体力学と場の理論の問題に当てはまりますが、リソースをコミットする前に特定のドメインで検証してください。
- 図4:離散外微分と余鎖表現の階層構造*
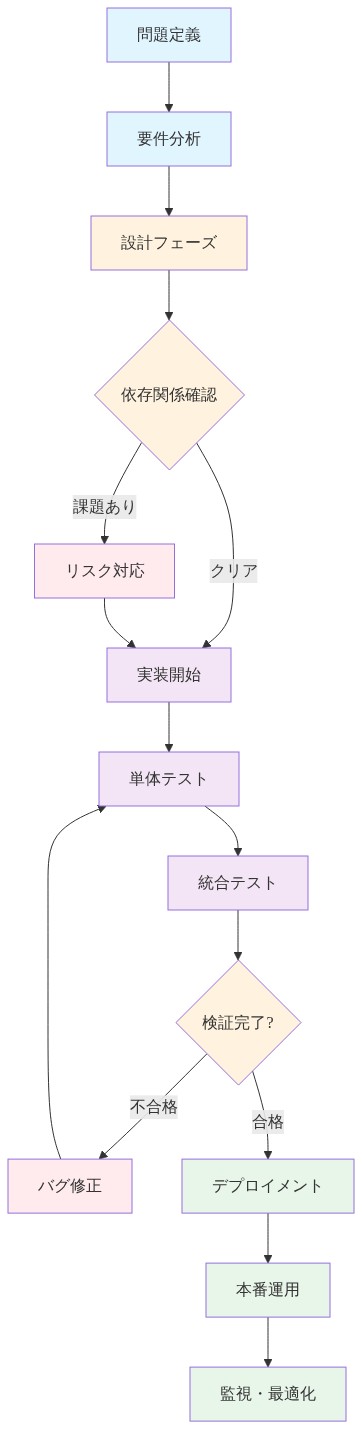
- 図14:問題定義から実装・デプロイメントまでの段階的ロードマップ*