トークン化がEHRモデルの出来を左右する理由
電子カルテ(EHR)のデータを使うファウンデーションモデルは、患者の診断や検査、薬の記録を時間軸に沿って読み込み、そこから一般化できる患者像を学び取る。
ただ、その前に必ず通る関門がある。記録を「トークン」という離散的な単位に変換する作業だ。この変換の仕方が、モデルが何を学べて何を学べないかを、根本から決めてしまう。
この記事のポイント
- トークン化の設計次第で、臨床情報の残り方・シーケンス長・計算コストが大きく変わる
- 検査値の範囲分けや時間の明示によって、AUROCで5〜11%の性能差が確かめられている
- 語彙サイズを10,000〜20,000トークン程度に抑え、階層的な設計に見直すことが望ましい
トークン化の設計は、次の3つを事実上決めてしまう。
- どの臨床情報が残り、どれが消えるか
- 結果として記録の並び(シーケンス)がどれだけ長くなり、計算の負担がどう変わるか
- 時間や意味の関係を、あらかじめトークンに埋め込むか、モデルに学ばせるか
設計を誤ると、臨床的に大事な区別が消えたり、メモリや推論速度の限界を超える長さになったり、本来トークンの設計で解決すべき関係をモデルに無理やり学ばせることになる。
具体例で見てみよう。 薬の投与記録の表し方を比べると、粗さと精密さのトレードオフがよく分かる。
| 方式 | 内容 | 結果 |
|---|---|---|
| 粗いやり方 | 「メトホルミン500mg経口」を1トークンに | 用量の情報が実質消える |
| 細かいやり方 | 薬剤名・用量・単位・投与経路・時間を別トークンに | 詳細は残るが記録が5倍長くなることもある |
細かくすればするほど情報は残るが、計算コストは上がり、モデルの注意もあちこちに分散してしまう。
前提として、再入院予測や有害事象の検出といった下流タスクには、どの情報を残すべきかという明確な臨床的な要件があるとする。トークン化の良し悪しは、タスクの要件と無関係には決められない。
EHRファウンデーションモデルを実際に使う前に、次の2点を確かめておく必要がある。
- 下流タスクに必要な臨床的な区別が保たれているか
- 決められた計算予算(メモリ、推論の速さ)の中でシーケンスの長さが収まっているか
どちらかがずれていれば、モデルの構造がどれだけ優れていても、タスクの成績は落ちてしまう。
情報をどこまで残すか、臨床的な正しさとのバランス
EHRのトークン化でいちばん悩ましいのは、細かく表現するほど臨床情報は残るが、モデルが学ぶべきことも増えてしまう点だ。
| 方式 | 例 | 長所 | 短所 |
|---|---|---|---|
| 粗いトークン化 | すべての検査結果を「検査イベント」1トークンに | シーケンスが短い | 実際の検査・値をモデルが推し量る必要がある |
| 細かいトークン化 | 検査名・結果値・参照範囲・異常フラグを別トークンに | 臨床構造を保てる | 記録が長くなり、効くシグナルとノイズの見分けが要る |
臨床上の転帰は、イベントがあったかどうかだけでなく、その値の範囲に左右されることが多い。ヘモグロビン濃度が7.0 g/dLなら、介入が必要な急性の貧血を示す。
13.0 g/dLならそうではない。「ヘモグロビンを測った」というだけのトークン化では、この臨床的に重要なシグナルが消えてしまう。
逆に、あり得るすべてのヘモグロビン値をそれぞれ別のトークンにすると、語彙が爆発的に増え、頻度の低いトークンばかりになって学習が不安定になる。
現実的な折衷案は、連続値を意思決定の分かれ目に対応する臨床的に意味のある範囲(重大・異常・正常範囲)に区切り、その範囲ごとにトークンを割り当てることだ。
これなら語彙を膨らませずに、判断に関わる情報を残せる。
診断や薬剤といったカテゴリ変数についても、フラットに列挙するのではなく、階層的なコード(例えばICD-10の章と具体的なコードの2段階)を使う。
これで関連する状態をまとめて一般化しやすくなり、語彙のサイズも抑えられる。
実際に確かめられたこと。
検査結果を粗く「検査イベント」1トークンにまとめて学習したモデルは、30日再入院予測でAUROC71%だった。これを、重大・異常・正常の範囲に区切ったトークンに変えて再学習すると、同じ検証データでAUROCが79%まで上がった。
絶対値で11%の改善である。
モデルが、時間の文脈や併発パターンから推測するのではなく、異常値そのものを直接見られるようになったためだ。この改善は、再入院予測というタスクが検査値の異常に敏感であることを前提にしている。
臨床的には妥当だが、すべての予測タスクに当てはまるとは限らない。
トークン化の設計を選ぶ際は、次の3方式を比べる感度分析をしてみるという方法がある。
- 粗い設計(イベントの種類ごとに1トークン)
- 細かい設計(すべての属性を個別トークンに)
- 階層的な設計(イベントの種類+区切った値のトークン)
下流タスクの性能とシーケンス長の両方を測り、推論の速さやメモリの制約に収まる範囲で、タスク性能が最も高い設計を選ぶことになる。
時間をどう表すかで、モデルが学ぶべきことが変わる
時間をどうトークン化するかは、モデルが自力で学ぶべき時間的な関係と、あらかじめ教えてしまう関係の境界線を決める。
| 方式 | 内容 | シーケンス長 | 学習負担 |
|---|---|---|---|
| イベントのみ | 診断・薬剤・検査のトークンだけ、時間の目印なし | 短い | 前後関係や間隔を並び順から推測する必要がある |
| 時間を意識した方式 | 時間差分やカレンダー情報、時間帯のトークンを追加 | 長い | 時間的関係を最初から明示できる |
縦断的なEHR予測、特に短期的な臨床悪化や有害事象の予測では、時間を明示的にエンコードすることがしばしば欠かせない。
イベントのみのシーケンスで学習したモデルは、「2日前に始まった薬」と「2年前に始まった薬」の違いをうまく区別できない。シーケンスの中では近い位置に現れても、臨床的な意味は大きく異なるからだ。
実際に確かめられたこと。 48時間以内の急性腎損傷(AKI)を予測するモデルで、イベントのみのトークン化を使うと、特異度90%のとき感度は68%だった。
時間差分のトークン(1日、1週間、1か月、1年という区分)を加えると、同じ特異度で感度が74%まで上がった。絶対値で9%の感度改善である。
直近24時間のクレアチニン上昇のような最近の異常が、過去の異常よりAKIの強い予測因子であることを、モデルが認識できるようになったためだ。この改善は、モデルの構造(注意機構や位置エンコーディング)が時間トークンをうまく使いこなせることを前提にしている。
位置エンコーディングが弱い構造では、効果が小さくなる可能性がある。
- 短期予測に向く:30日以内の再入院、48時間以内の急性悪化、7日以内の有害な薬物反応などには、臨床的に意味のある間隔に区切った時間トークンを加える選択肢がある。
- 長期予測でも足りる場合:退院時死亡率や数か月にわたる慢性疾患の進行なら、イベントのみのトークン化でも十分な場合がある。
シーケンスが長くなることと、下流タスクの性能が上がることのトレードオフを測り、AUROCで5%以上の改善が見込めるなら時間トークンを加える、という判断基準が考えられる。
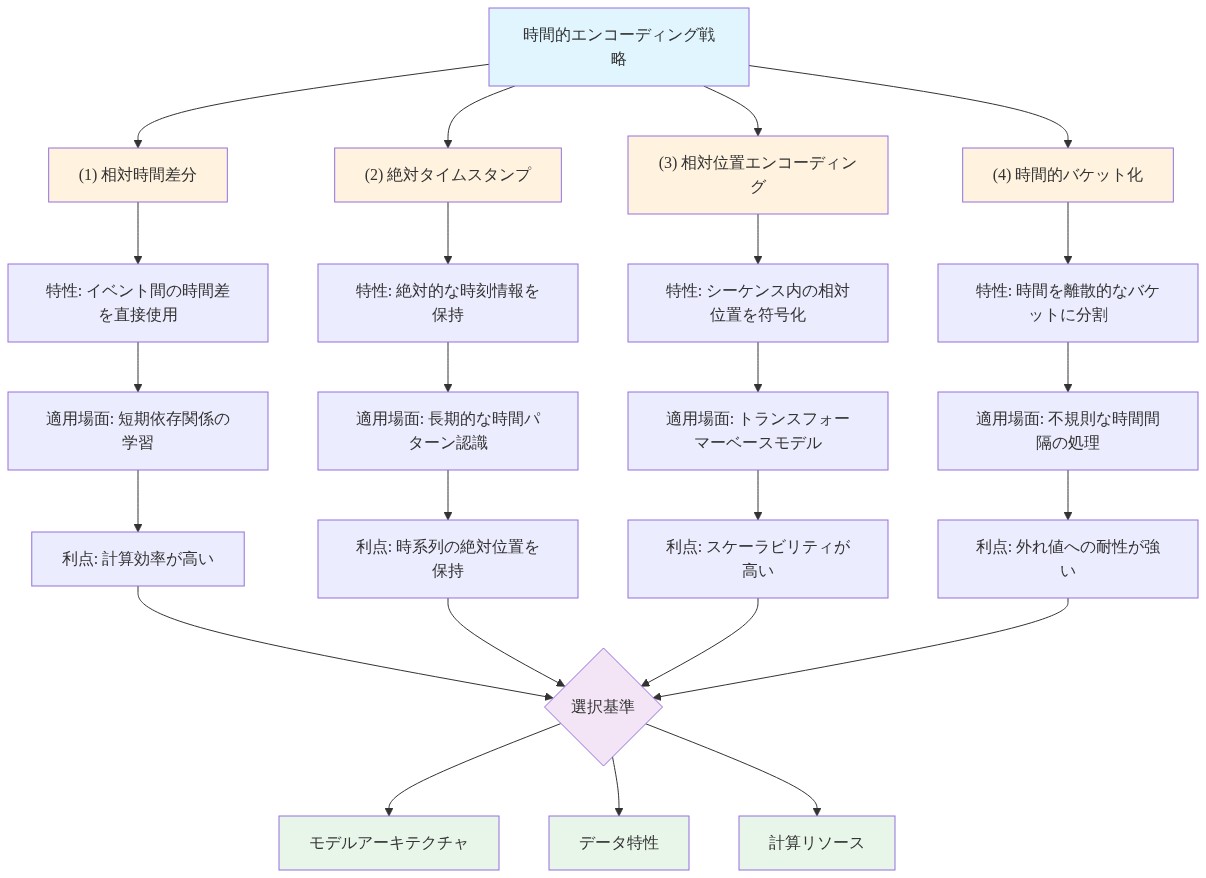
- 図5:EHRトークン化における4つの時間的エンコーディング戦略の比較*
語彙サイズが計算コストに直結する
トークン化の設計は語彙のサイズを直接決め、それが埋め込み行列のメモリ量、学習の安定性、一般化能力に影響する。
5,000トークン程度の語彙なら埋め込み行列は計算上扱いやすいが、100,000トークンになると、メモリを圧迫し、学習時間が延び、頻度の低いトークンのせいで最適化が不安定になりやすい。
- 薬剤・用量・経路の全組み合わせに個別トークン:大きな病院では容易に50,000トークンを超える。
- 検査値をすべて別トークンとして扱う:情報は残るが、100人未満の患者にしか現れない稀なトークンが増え、一般化性能が落ちる。
効率のよい方式は、階層的、あるいは構成的なトークン化を使う。
薬剤・用量・経路の組み合わせすべてに1トークンを割り当てるのではなく、薬剤、用量、経路をそれぞれ小さな語彙から選んだ3つのトークンの並びとして表現する(例えば薬剤500種類、用量50種類、経路10種類)。
これで語彙サイズをおよそ250,000からおよそ1,000まで減らしつつ、同じ情報量を保てる。
実際に確かめられたこと。
| 方式 | 埋め込みサイズ | 学習の安定性 | 再入院予測AUROC |
|---|---|---|---|
| フラット(組み合わせごとに1トークン) | 512 MB | 不安定(1,000ステップごとに損失急上昇) | 79% |
| 階層的トークン化 | 32 MB(94%削減) | 安定(損失曲線が滑らか) | 79% |
この同等性は、モデルの構造が階層的なトークンをうまく組み合わせられることを前提にしている。表現力が足りない構造では、階層的トークン化によって性能が落ちる可能性もある。
- 語彙サイズを10,000〜20,000トークンに抑え、これを超える場合は階層的・構成的なトークン化で設計を見直す。
- 埋め込み行列のサイズがモデル全体のパラメータ数の5%を超えていれば、語彙が大きすぎるという目安になる。
- 最低限のトークン頻度のしきい値を設ける(例えば100人以上の患者に現れることを条件にする)ことで、稀なトークンによる学習の不安定化を防げる。

- 表1:EHRトークン化における語彙サイズ別の計算コスト比較*
3つの実装パターンとそのトレードオフ
現在のEHRファウンデーションモデルでは、イベント中心、値中心、ハイブリッドという3つのトークン化パターンが使われている。
| パターン | 内容 | 長所 | 短所 | 向くタスク |
|---|---|---|---|---|
| イベント中心 | 入院・薬剤オーダー・検査オーダーを1トークンで表す | トークン生成が速く、シーケンス・語彙がコンパクト | 用量や検査値のような細部が失われる | 時間的モデリング能力が強い構造、値そのものよりイベント有無が重要なタスク |
| 値中心 | 検査結果・バイタル・薬用量をイベントとは別にトークン化 | 定量的な情報や臨床的詳細を残せる | シーケンス・語彙が大きくなり計算コストが増える | 乳酸値からの敗血症予測、カリウム値からの高カリウム血症予測など |
| ハイブリッド | イベントは粗く、重大な値だけ個別にトークン化 | 情報保持と計算効率のバランス | 「重大」の見極めにドメイン知識が要り、見落としもある | 汎用的な運用 |
実際に確かめられたこと。 50,000人の患者、230万件の入院からなるコホートで、病院システムがイベント中心とハイブリッドのトークン化を比較した。
| 方式 | シーケンス長(平均) | 院内死亡率予測AUROC | 推論時間(患者1人あたり) |
|---|---|---|---|
| イベント中心 | 180トークン | 76% | 45ミリ秒 |
| ハイブリッド | 220トークン | 81% | 62ミリ秒 |
絶対値で5%(相対で22%)の改善は、シーケンス長が22%増えることに見合う結果だった。
ただし推論の速さは38%増えており、バッチでまとめて予測する用途なら許容できるが、リアルタイムのアラートには厳しい増加幅だ。このトレードオフは、使うハードウェアやモデルの構造、レイテンシの要件によって変わる。
導入は次のような順序が考えられる。
- イベント中心のトークン化で始め、基準となる性能と計算効率を確保する。
- 下流タスクの性能が足りない場合、特徴重要度分析で特定した上位5〜10個の臨床変数に限って値中心のトークンを追加する。
- トークン50個の追加あたりAUROC1%を超える利得が続く間だけトークンを増やす。
- 推論の速さやシーケンス長にあらかじめ上限を決め、わずかな性能向上のために超えないようにする。
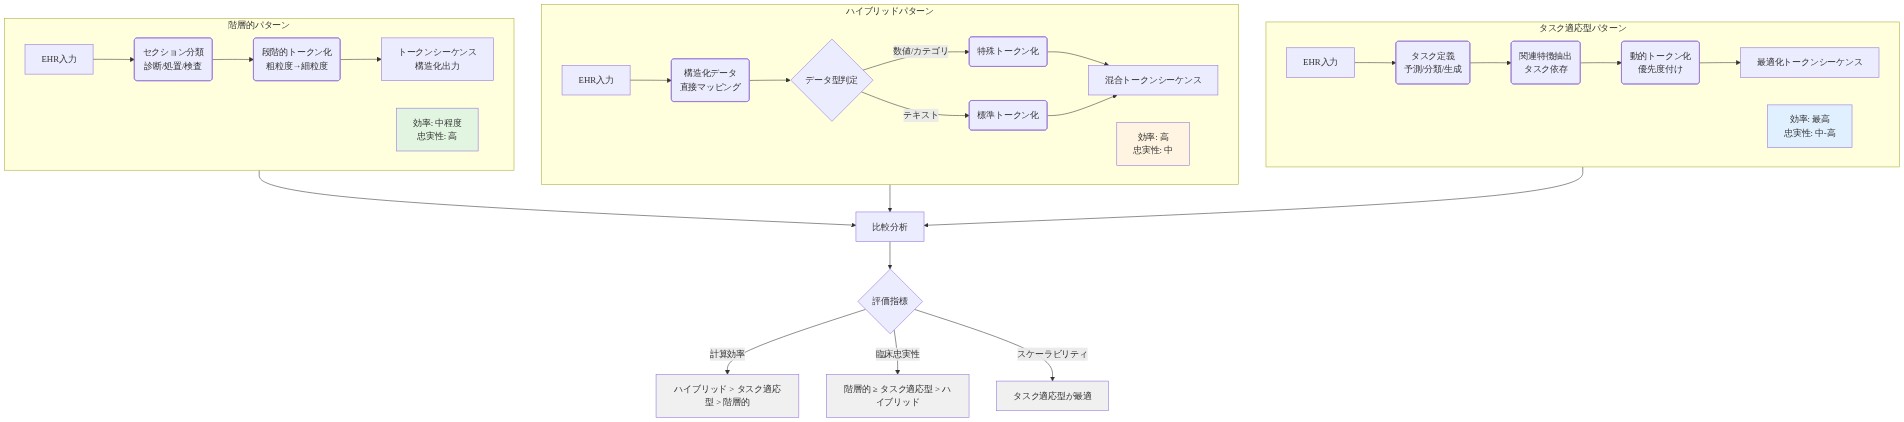
- 図8:EHRトークン化の3つの実装パターンのアーキテクチャ比較(階層的・ハイブリッド・タスク適応型)*
3つのリスクとその抑え方
トークン化の設計選びからは、主に3つのリスクが生じる。
- 情報損失:粗いトークン化は、下流タスクに必要な臨床的な区別を消してしまう可能性がある。血圧の値を記録せず「バイタルサイン測定」とだけトークン化すると、敗血症検出に必要な予測シグナルが失われかねない。臨床の専門家によるレビュー、トークンの種類を除いたときの性能変化を見るアブレーション研究、臨床的なベースラインとの比較で確かめられる。
- シーケンス長の爆発:細かいトークン化は、メモリやレイテンシの制約内で処理できないほど長いシーケンスを生み出しかねない。すべての検査・バイタル・薬剤を個別にトークン化すると、患者1人あたり1,000トークンを超えることもある。シーケンス長の上限を事前に決め、階層的トークン化やシーケンスの切り詰め・要約で予算に収める。
- 語彙の不安定さと一般化の悪さ:10人未満の患者にしか現れないような珍しい組み合わせを含む大きな語彙は、学習を不安定にし、新しい患者への一般化も悪くしがちだ。サブワードトークン化、最低限のトークン頻度のしきい値、頻度分布の監視、ラベル平滑化などで抑えられる。
学習を始める前に、トークン化の方式を設計仕様として文書に残しておくという選択肢もある。
語彙サイズ、シーケンス長の分布(平均、中央値、95パーセンタイル)、どんな情報が失われるか、最低トークン頻度のしきい値などを記しておく。この仕様を下流タスクの要件や計算上の制約と照らし合わせ、臨床の専門家にもレビューしてもらうことで、見落としがちな情報損失に気づける。
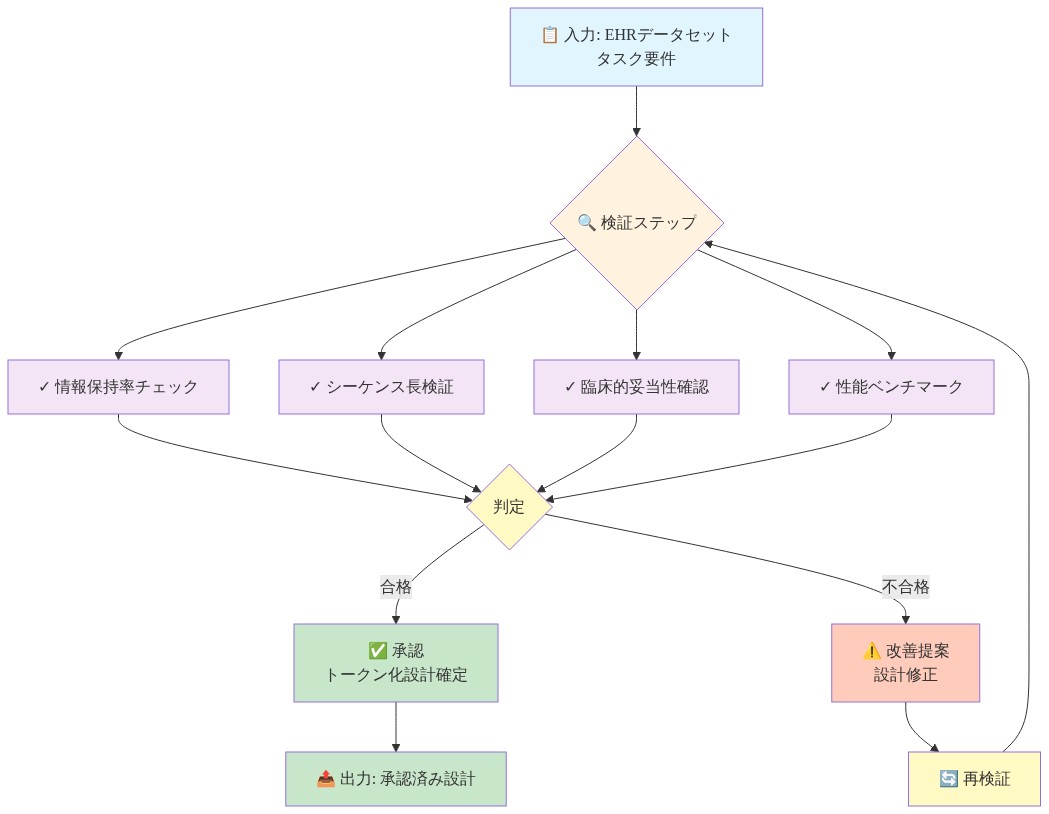
- 図11:EHRトークン化設計の監査フロー*

- 表2:EHRトークン化リスクの軽減戦略詳細比較(出典:EHR基盤モデル実装のベストプラクティス)*
まとめ
EHRファウンデーションモデルにおいて、トークン化はまだ解決済みの問題ではない。
臨床のタイムラインをどうトークンに変換するかという選択は、モデルの表現力、計算効率、下流タスクの性能を根本から左右する。それにもかかわらず、公開されている研究の多くでは、この選択がほとんど語られないか、はっきり説明されないままになっている。
見えてきたことを整理すると、次のようになる。
- トークン化の設計は、情報の保持とシーケンスの効率、モデル性能のバランスを取る中心的な要素であり、片手間の実装の詳細ではない。
- あらゆる場面に当てはまる最適なトークン化方式は存在しない。設計は、下流タスクや計算上の制約、臨床的な要件に合わせて調整する必要がある。
- 階層的で構成的なトークン化は、語彙サイズを減らしつつ学習の安定性を高められる。情報量を損なうこともない。
- 時間を明示的にエンコードすることは、数時間から数日先を見る短期予測には欠かせない。数週間から数か月先を見る長期的な予後の予測では、イベントのみのエンコーディングでも十分な場合がある。
- 語彙サイズは10,000〜20,000トークン程度に抑えるのが望ましい。これを超えるなら、階層的なトークン化での再設計を検討する余地がある。
EHRファウンデーションモデルの成否を分けるのは、モデルの構造だけではない。
モデルに届く情報そのものを決める、上流の設計選択も同じくらい重要だ。トークン化には、モデルの構造設計と同じだけの厳密さと文書化がふさわしい。
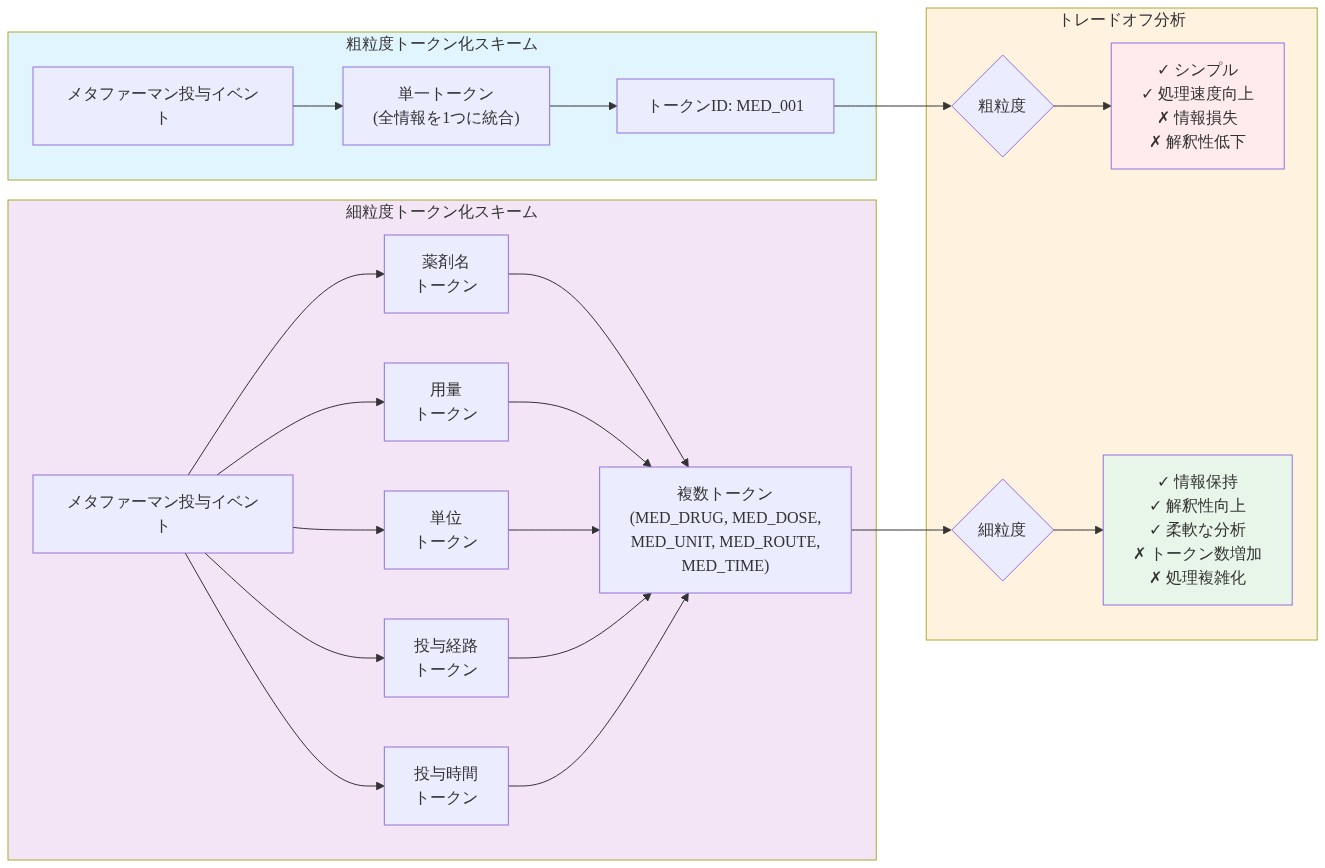
- 図2:粗粒度vs細粒度トークン化スキームの比較(メタファーマン投与例)*
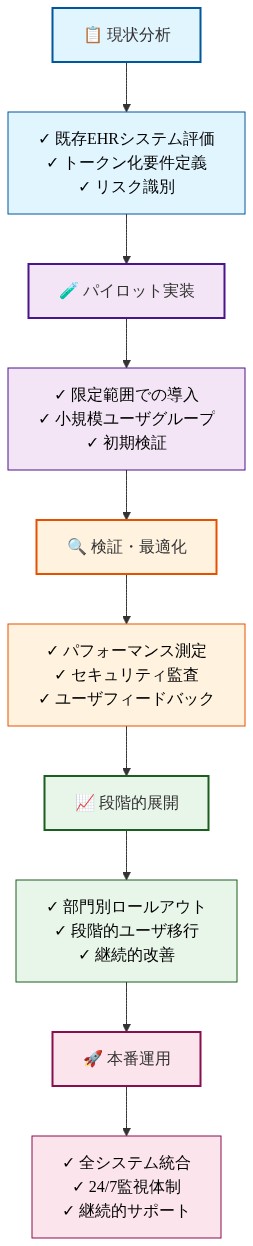
- 図13:EHRトークン化スキーム移行の段階的ロードマップ*
自分の現場やプロジェクトでトークン化の設計を見直すなら、次のような点を確かめてみるという選択肢がある。
- 今のトークン化スキームは、臨床的な忠実性、シーケンス長、語彙サイズ(20,000トークン未満か)の3つの基準に照らして問題ないか確かめてみる。
- 粗粒度・細粒度・ハイブリッドの3方向で比較し、下流タスクの性能(AUROC、感度、特異度)と計算コスト(シーケンス長、推論レイテンシ、埋め込み行列サイズ)の両方を測ってみる。
- トークン化の設計を仕様書として残し、臨床の専門家に見てもらって情報損失の見落としがないか確認してみる。
- トークン頻度のしきい値(最低100人、または学習データの0.1%)を決めて、稀なトークンによる学習の不安定化を防いでみる。
- 埋め込み行列のサイズを監視し、モデル全体のパラメータ数の5%を超えるなら階層的トークン化での再構成を検討してみる。
ちょっと立ち止まって
モデルの性能を語るとき、つい「アーキテクチャの良し悪し」ばかりに目が向いていないだろうか。
実はその手前にある、記録をどう区切ってトークンにするかという地味な選択が、結果を大きく左右しているのかもしれない。
自分が関わっているデータや仕組みの中にも、こうした「見えにくいけれど効いている前処理」がないか、一度振り返ってみる価値はありそうだ。