FlowBudgetは、フローマッチングモデルの推論に必要なステップ数を、学習済みのフローそのものから見積もる手法だ。
多くのチームは、この数を前の論文からそのまま写している。その数が、生成するすべてのサンプルのコストに掛け算で効いているとしたらどうだろう。
フローマッチングモデルは、常微分方程式(ODE)または確率微分方程式(SDE)を積分してサンプルを作る。
積分の1ステップごとに、ネットワークを1回呼び出す。推論のコストは、この呼び出し回数(NFE)に比例して増える。
この数はとても重要だ。それなのに、原理から導かれることはまずない。
ほとんどのチームは、以前の論文のステップ数をそのまま使う。候補の数ごとに、数千枚のサンプルを作って採点するチームもある。
この記事では、別のやり方を紹介する。学習済みのフローそのものから、必要な予算を見積もる方法だ。
仮の名前はFlowBudgetという。追加の学習はいらない。生成画像の品質スコアにも頼らない。
この記事のポイント
- ステップ数は、ほかのあらゆる推論コストに掛け算で効く。適当に決めると、すべてのサンプルで計算資源がむだになる。
- FIDとNFEの掛け合わせによるスイープは、時間がかかり、ばらつきも大きい。品質が頭打ちになる場所は分かっても、理由は分からず、結果は別の場面に移しにくい。
- FlowBudgetは、学習済みの速度場の幾何的な性質から予算を読み取る。見るのは、曲がり具合、誤差のたまり方、収束の速さだ。
ステップ数は見えない掛け算だ
効率化の取り組みの多くは、ネットワークを1回呼び出すコストを狙う。量子化は、重みと活性化を小さくする。
カーネルやサービング側の工夫は、呼び出しのまわりの余計な負荷を減らす。どちらも、1回の評価を軽くする。
ステップ数は、別の軸で効く。1回あたりのコストを、サンプルごとに何回払うかを決めるのがステップ数だ。 二次的な問題に見えるが、効き目は一次的に大きい。
簡単な例で規模を見てみよう。あるモデルが50ステップで動いているが、30ステップでも同等の出力が得られるとする。ネットワークの呼び出しは40%減る。
遅延のほとんどが1ステップあたりのコストで決まるなら、推論時間もほぼ同じ割合で縮む。何百万回も生成すれば、計算量と電力の節約は大きな額になる。
難しいのは、その小さいほうの数を見つけることだ。必要な予算は、手法ごとに決まる固定の値ではない。次のどれかが変わるたびに、動く可能性がある。
- モデルのチェックポイント(ファインチューニングのたびに変わる)
- 学習データセットや対象の領域
- ODEやSDEのソルバー
- 推論時のガイダンスの強さ
- アーキテクチャやモデルのサイズ
どの変更でも、古い数は使えなくなりうる。実際には、チェックポイントのたびに予算選びをやり直すことになる。
それでも、たいていは後回しにされる。きちんとした方法で向き合うべき工学上の問題として、扱われていないのだ。
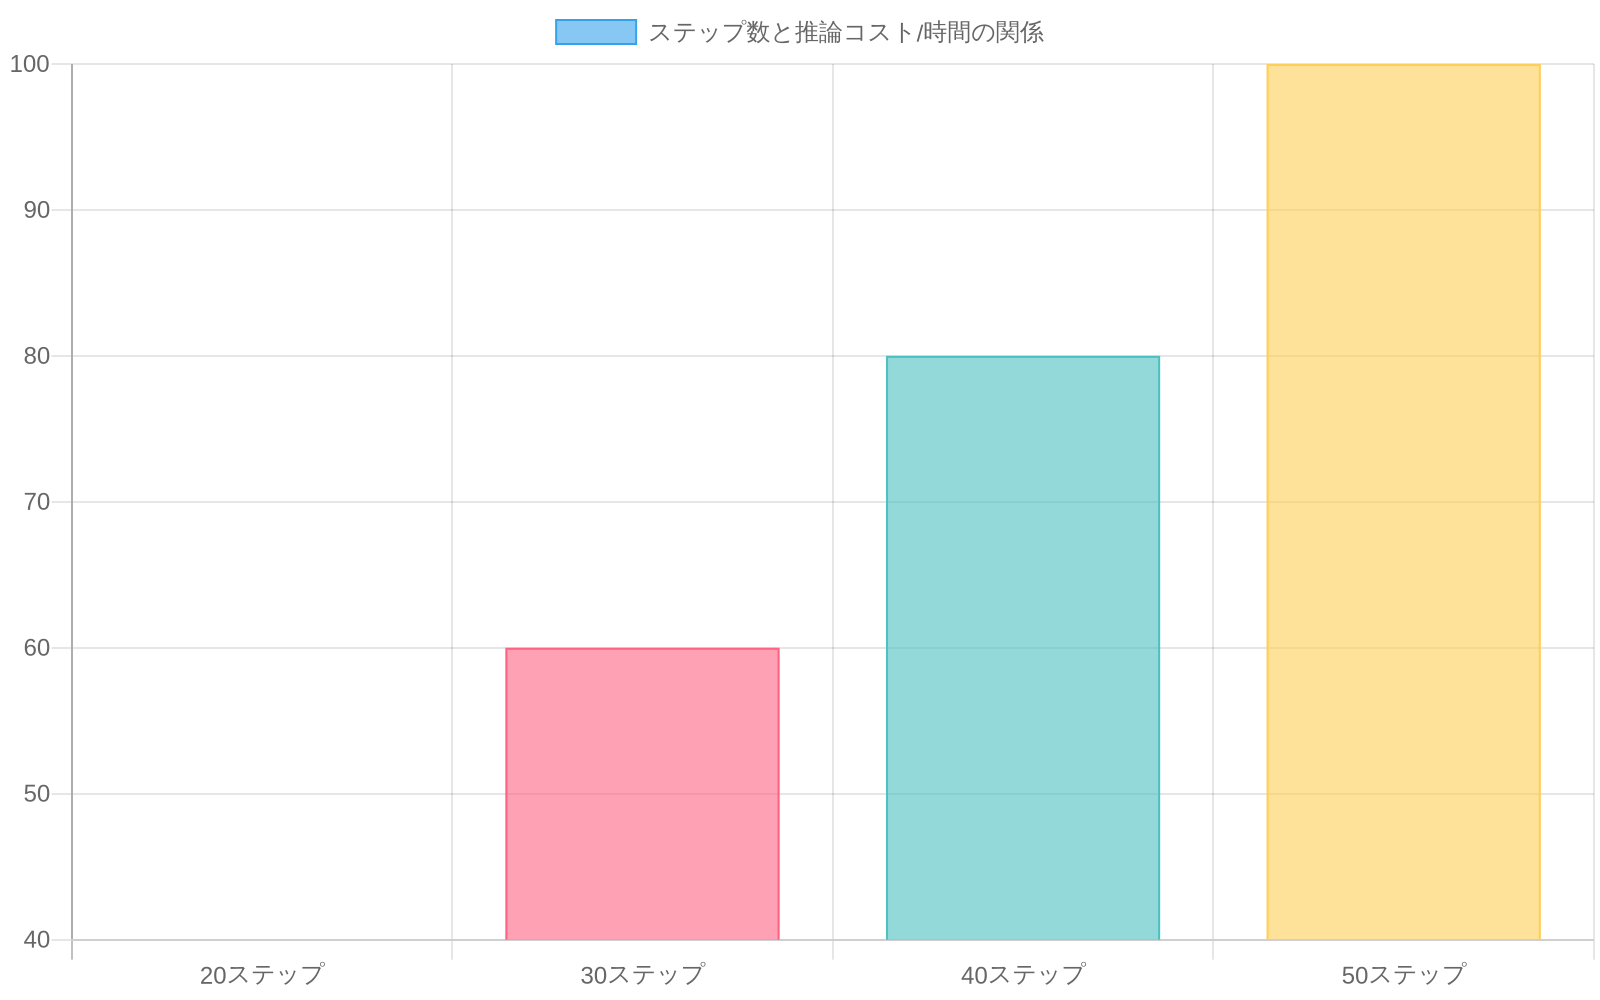
図2:ステップ数と推論コスト/時間の関係(50ステップから30ステップへの削減例で40%のコスト削減を実現)
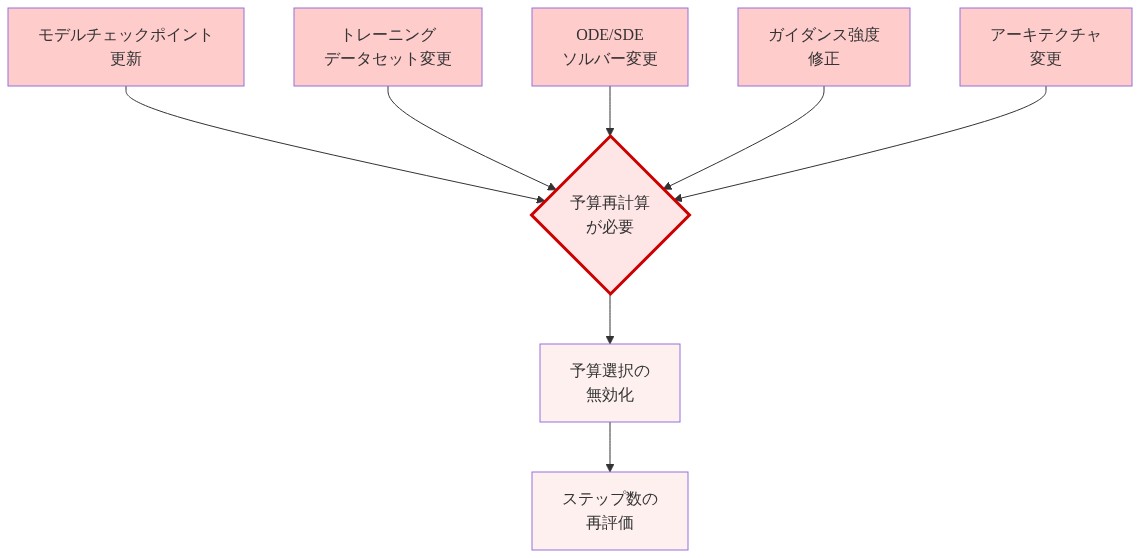
図3:予算選択を無効化する要因と再計算の必要性
FIDスイープは土台として弱い
標準的な方法は、実際に測るスイープだ。
まず、候補となる予算をいくつか選ぶ。それぞれの予算で大量のサンプルを生成し、参照データとのFIDを計算する。曲線が平らになる最小の予算を選ぶ。
この節のポイント
- FIDスイープは遅く、モデルや設定が変わるたびにやり直しになる
- 品質が頭打ちになる場所は分かるが、理由は分からない
- スイープで得た予算は、新しい領域やモデルの派生版に移しにくい
まず、遅さが問題になる。曲線の1点ごとに、数千枚のサンプル、特徴抽出、採点が必要だ。
スイープを一通り回すと、GPUを何時間も使うこともある。設定が変わればやり直しだ。
もっと根深い欠点は、スイープで分かることと分からないことにある。品質が頭打ちになる場所はどこかが分かる。しかし、なぜそこなのかは分からない。
| 弱点 | 実際に起きること |
|---|---|
| FIDはばらつく | サンプル数でスコアが動くため、予算どうしの小さな差は本物とは限らない。 |
| FIDは特徴抽出器に左右される | 中立な品質の物差しではなく、1つのネットワークから見た画像の近さを測っている。 |
| FIDはデータセットに縛られる | ある参照データで決めた予算が、新しい領域でも通用するとは限らない。 |
| 結果はソルバーに左右される | あるソルバーで50ステップに見える収束が、別のソルバーの30ステップでは離散化誤差を隠していることがある。 |
| 結果はガイダンスやアーキテクチャに左右される | ガイダンスの強さやモデルの設計が変わると、頭打ちの位置が動く。 |
| 見た目の品質と数値的な品質が食い違う | サンプルは問題なく見えても、打ち切り誤差を抱えていることがある。後続の作業では、その誤差が効いてくる。 |
最後の行は強調しておきたい。画像が目視の確認を通り、FIDで高く評価されても、数値としては不正確なことがある。
画像を並べて眺めるだけなら、その誤差は問題にならないかもしれない。編集や反転など、軌道の正しさに頼る処理に出力を渡すなら、問題になりうる。
根本の問題は、スイープが測るのが出力であって、モデルではないことだ。数は得られるが、説明は得られない。
説明がなければ、その予算が別の場面でも通用するかは予測できない。条件が変わったときの直し方も分からない。大規模に運用するほど、この見通しの悪さは高くつく。
予算をフローそのものから読み取る
FlowBudgetは、問いを逆にする。「どの予算なら良い画像ができるか」とは問わない。「学習済みのフローは、何ステップ必要だと示しているか」と問う。
土台にあるのは、数値計算の直感だ。なめらかで扱いやすい速度場は、積分しやすい。ソルバーは大きなステップを踏んでも、本当の軌道を追える。
硬い場や、強く曲がった場では、ステップを小さくせざるをえない。大きなステップでは行きすぎたり、誤差がたまったりするからだ。こうした性質を測れるなら、必要な予算の手がかりになるはずだ。
この手法は、学習済みの場を通る軌道について、3つの性質を調べる。
- 曲がり具合。 ほぼまっすぐな道なら、少ないステップで足りる。急に曲がる道は、多くのステップが要る。
- 離散化誤差のたまり方。 ソルバーの診断を使い、あるステップ幅で局所的な打ち切り誤差がどれだけ速くたまるかを見る。
- 収束の速さ。 解像度を変えて積分を比べ、ステップを増やしても終点が変わらなくなる所を探す。
これらの信号を組み合わせて、推奨するNFEを1つ出す。
この手法は、追加の学習がいらない。大量のサンプル生成も、FIDの計算も必要ない。安上がりな操作で、フローを探るだけだ。
- 少数の出発点について、軌道を積分する。
- その軌道に沿って、ソルバー自身の診断から誤差の推定値を集める。
- 軌道に沿った速度場のなめらかさを分析する。
- 測った曲がり具合、誤差の増え方、収束を、推奨ステップ数に変換する。
積分するのは少数の出発点だけなので、フルのスイープよりずっと安くすむ。入力はデータセット上のスコアではなく、モデルの性質だ。だから結果は、運用するチェックポイントにより直接結びつく。
この手法は、1つの前提に立っている。見た目の品質は、数値的な収束と連動するという前提だ。
ソルバーの軌道が収束していれば、画像も良いはずだ。収束していなければ、品質は落ちるはずだ。
標準的なソルバーと控えめなガイダンスなら、サンプリングの道筋が学習済みの場にぴったり沿うので、この前提はもっともらしい。極端なガイダンスや蒸留モデルでは、確かさが下がる。
理由は、評価の節で述べる。前提が成り立つ場面では、推定は信頼できるはずだ。成り立たない場面では、実際に確かめる必要がある。
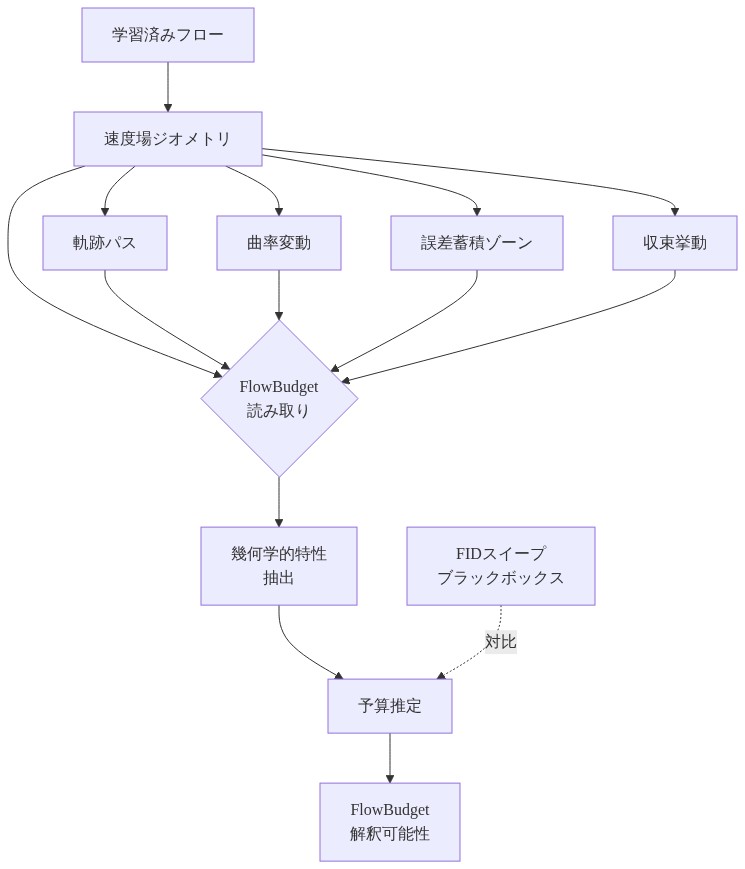
図6:学習済みフロー内の速度場ジオメトリとFlowBudgetの読み取り方法(FlowBudget methodology)
予算の見積もりをどう評価するか
見積もりの手法が信頼されるのは、置き換える対象のスイープと結果が合うときだけだ。推奨された予算が間違っていれば、速くても意味がない。
この節のポイント
- 順位の一致、予算のずれ、設定をまたいだ頑健さの3つが、大事な物差しだ。
- 多めに見積もると計算がむだになり、少なめに見積もると出力の質が落ちる。どちらを選ぶかは、用途しだいだ。
- ガイダンスが強いとき、モデルが蒸留されているとき、サンプラーがノイズを入れるときは、幾何に基づく推定が実際の出力品質とずれうる。
評価では、次の3つの問いを確かめたい。
- 順位の一致。 実測の品質曲線と同じ順に、設定を並べられるか。スイープでモデルAがモデルBより多くのステップを要するなら、見積もりもそう示すべきだ。
- 予算のずれ。 見積もったNFEは、基準のFIDに届く最小の予算からどれだけ離れているか。ずれが小さければ、スイープの代わりになる。
- 頑健さ。 一致は、ソルバー、データセット、モデルサイズをまたいでも保たれるか。手法を開発した条件だけで成り立つのではないか。
2種類の誤りは、コストの性質が違う。
| 誤り | 結果 | 気づく人 |
|---|---|---|
| 予算を多く見積もる | すべてのサンプルで計算がむだになる | インフラの請求に出る |
| 予算を少なく見積もる | 出力の質が落ちる、または不正確になる | 品質に出る。後続の工程でようやく分かることもある |
保守的な見積もりなら、後者の誤りは避けられる。ただ、どの見積もりにも余裕を上乗せすると、この手法を使う意味である効率の向上が削られる。
ちょうどよい水準は、悪いサンプルが用途でどれだけ痛いかで決まる。創作ツールなら、ときどき出る甘さは許せる。軌道の正確さに頼るパイプラインでは許せない。
検証では、手法が崩れそうな場面を狙う必要もある。幾何に基づく推定が実際の出力品質とずれうるのは、次の3つの場面だ。
- 強いガイダンス。 ガイダンスの尺度が高いと、サンプルはガイダンスなしのフローから遠ざかる。測った幾何が、サンプラーが実際にたどる道を表さなくなるかもしれない。
- 蒸留モデル。 蒸留は、多くのステップを少ないステップに押し込む。できあがったネットワークは、見積もりが想定するなめらかな場とは違う振る舞いをするかもしれない。
- 確率的なサンプラー。 注入されるノイズで、誤差のたまり方が変わる。決定論的な収束の分析では、予算を見誤るかもしれない。
こうした場面では、推奨NFEが1つだけでは足りないかもしれない。
品質とコストのフロンティアを示すほうが、ユーザーの役に立つのではないか。この点は未解決だ。多くのチームは、遅延の段階を複数持っている。
素早いプレビュー、標準モード、高品質モードだ。NFEごとの期待品質を曲線で示せば、3つの判断をすべて支えられる。数が1つだけでは、1つの判断しか支えられない。
効率化の積み重ねの中での位置づけ
推論の効率化は、いくつもの層で同時に進む。層ごとに、減らす要素が違う。
| 層 | 減らすもの | 例 |
|---|---|---|
| 精度 | 1回のネットワーク評価のコスト | 量子化。代数的整数方式や、1.58ビットのBitNetモデルのような極端な低ビット化も含む |
| インフラ | 評価のまわりの余計な負荷 | コードハーネス、サービング、オーケストレーション |
| サンプリング予算 | サンプルあたりの評価回数 | FlowBudgetのような、原理に基づくNFEの選び方 |
これらの効果は、重なるのではなく掛け算になる。量子化で1ステップが2倍速くなり、予算の見直しでステップ数が半分になったとしよう。サンプリング時間は元の約4分の1になる。
約75%の削減だ。実際の数字は、量子化による1ステップあたりの本当の高速化と、ネットワーク呼び出し以外に使う時間の長さで変わる。それでも、構造は掛け算だ。
精度、ソルバー、ステップ数は、いずれ一緒に最適化するべきだ。 別々に扱うと、減らせるはずのコストが残ってしまう。
量子化したモデルは、元の全精度のモデルと速度場が少し違うかもしれない。そうなら、理想の予算も違いうる。前の数を引き継がず、チェックポイントごとに見積もるべき理由が、もう1つ増える。
この手法が最も効くのは、資源が厳しい場面だ。ESP32のクラスターでBitNetモデルを動かすような限られたハードウェアでは、評価の1回ごとが高くつき、余裕もない。
ステップ数を適当に決める余裕はない。そんなハードウェアで、フルのFIDスイープを回すのも現実的ではない。少数の軌道だけで足りる、学習不要の見積もりのほうが、こうした制約にずっと合う。
今後の課題は、まだ残っている。
- 条件付き生成への拡張。プロンプトや条件によってフローが変わる。
- ガイダンスを考慮した見積もり。ガイダンスが軌道をどう変えるかを織り込む。
- 量子化との同時最適化。精度と予算を一緒に決める。
- フロンティアを返す出力。数を1つ返すのではなく、品質とコストの関係を示す。
目指すのは、予算選びをソルバー選びと同じくらい当たり前にすることだ。習慣ではなく、測定に基づく判断にしたい。
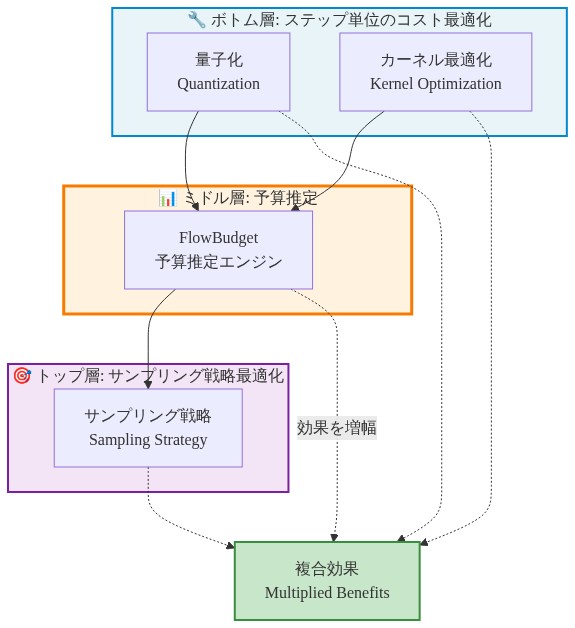
図9:効率化スタックにおける予算推定の位置づけ
運用の流れで何が変わるか
フローマッチングモデルを大規模に運用しているなら、予算選びは本物の工学上の判断として扱う価値がある。見積もりがあれば、そのたびに高いスイープを回さなくても、判断できるようになる。
この節のポイント
- 手持ちのモデルを調べ、いまのステップ数と見積もりの違いを確かめる
- 頼る前に、すでに測定した設定と照らして見積もりを検証する
- 新しいチェックポイントでは、前の数をコピーせず、見積もりを出発点にする
すでに動かしているものから始める
いま運用しているチェックポイントで、学習不要の見積もりを出してみる。
推奨される数が、いま使っているステップ数とどこで違うかを控えておく。この違いから、自分の環境で見積もりが働くか、いまどこで予算が多すぎたり少なすぎたりするかが分かる。
スイープを省く前に、信頼を築く
新しいモデルで見積もりに頼る前に、すでに測定した設定と照らして確かめる。そこで結果が合えば、あとでスイープを省ける。
合わなければ、見積もりの調整が必要なのか、いまの選び方が慎重すぎただけなのかが分かる。
基準はチームごとではなく、チェックポイントごとに置く
新しいモデルやファインチューニングごとに、見積もりを最初の予算にする。前の数を持ち越さない。
チェックポイントごとに、幾何的な性質は違う。以前のモデルのステップ数を引き継ぐと、違う問題を解いていることが多い。
用途が本当に必要とするもので検証する
FIDのスコアだけでなく、用途が頼る出力を確かめる。
強いガイダンス、蒸留モデル、確率的なサンプラーには、特に気をつけたい。こうした設定は、見積もりを作るときに想定した標準的な設定とは、違う振る舞いをするかもしれない。
予算の見直しを、ほかの効率化の層と組み合わせる
サンプリングの最適化は、量子化やインフラの選択と並べて計画する。限られたハードウェアでは、あとから足すのではなく、導入の中心に据える。
1回のスイープのほうが、見積もりを整えるより高くつくこともある。その差は、モデル、ファインチューニング、設定の数が増えるほど開く。
ちょっと立ち止まって
あなたのチームは、いまのステップ数をどうやって決めただろうか。「論文に書いてあった」という答えなら、その数は、サンプルを作るたびに、知らないうちにコストを積み上げているのかもしれない。
効率化というと、1回ごとの操作を安くする話になりやすい。ただ、操作の回数も同じくらい効いてくる。
原理に基づく見積もりが役に立つのは、予算の確認が当たり前の作業になってからだ。そのためには、ステップ数を引き継ぐものではなく、測るものとして扱う必要がある。