味見をするたびに丸1日待たされる料理を思い浮かべてみよう。塩をひとつまみ足すかどうかも、慎重に決めるしかない。
工学シミュレーターの「較正」も、これと似たところがある。よく分からないパラメーターをいくつか調整し、出力を参照データに合わせる作業だ。聞くだけなら簡単そうに思える。
難しいのはコストのほうだ。ラージエディシミュレーション(LES、乱流の大きな渦を直接計算する手法)は、1回で何時間、ときには何日もかかる。だから1回1回の実行が貴重になる。
arXivに出た新しい研究は、大規模言語モデル(LLM)ならこの限られた実行をもっと賢く使えるのでは、と問いかけている1。
モデルは各ステップの前に、直前のシミュレーションで何がまずかったかを物理の言葉で説明してもらう。そのうえで、次のパラメーターの更新案を出す。
著者らはこのやり方を、微分を使わない従来の最適化手法と比べた。題材は2つある。円柱後流のLESと、減衰振動子の逆問題だ。
LLMにシミュレーターの較正が「できる」かどうかは、実はやさしい問いである。難しいのは、どんなときにそれを任せてよいのか、のほうだろう。
この記事のポイント
- 高価なシミュレーターでは、較正は予算のやりくりになる。何回の実行で近づけるかが最も大事だ。
- 「渦の放出周波数が低すぎる」のような物理ラベルは、進む方向を示す。役立つのは本物の物理を含むときだけだ。
- 超えるべき基準はベイズ最適化だ。LLMは序盤の提案役を務め、体系的な手法に引き継ぐ形が最も筋が通る。
この研究は何を確かめたのか
実行のどこがまずかったかを物理の言葉で伝えれば、言語モデルはよいパラメーター更新を選べるのか。この研究はそれを確かめている1。比べる相手は、微分を使わない標準的な最適化手法だ。
較正は単純そうに聞こえる。よく分からない設定をいくつか調整し、シミュレーターの出力を参照データに合わせるだけだ。
落とし穴はコストにある。LESは1回の実行に何時間、何日もかかることがある。
著者らは、次の2つの問題でこの考えを試した1。
- 円柱後流のLES:円柱の後ろにできる乱れた流れを計算する、高価なシミュレーション。
- 減衰振動子の逆問題:教科書に出てくる、計算の安いモデル。
LLMに較正が「できる」かどうかは、答えやすい問いだ。もっと難しいのは、いつその仕事を任せてよいのかという問いである。
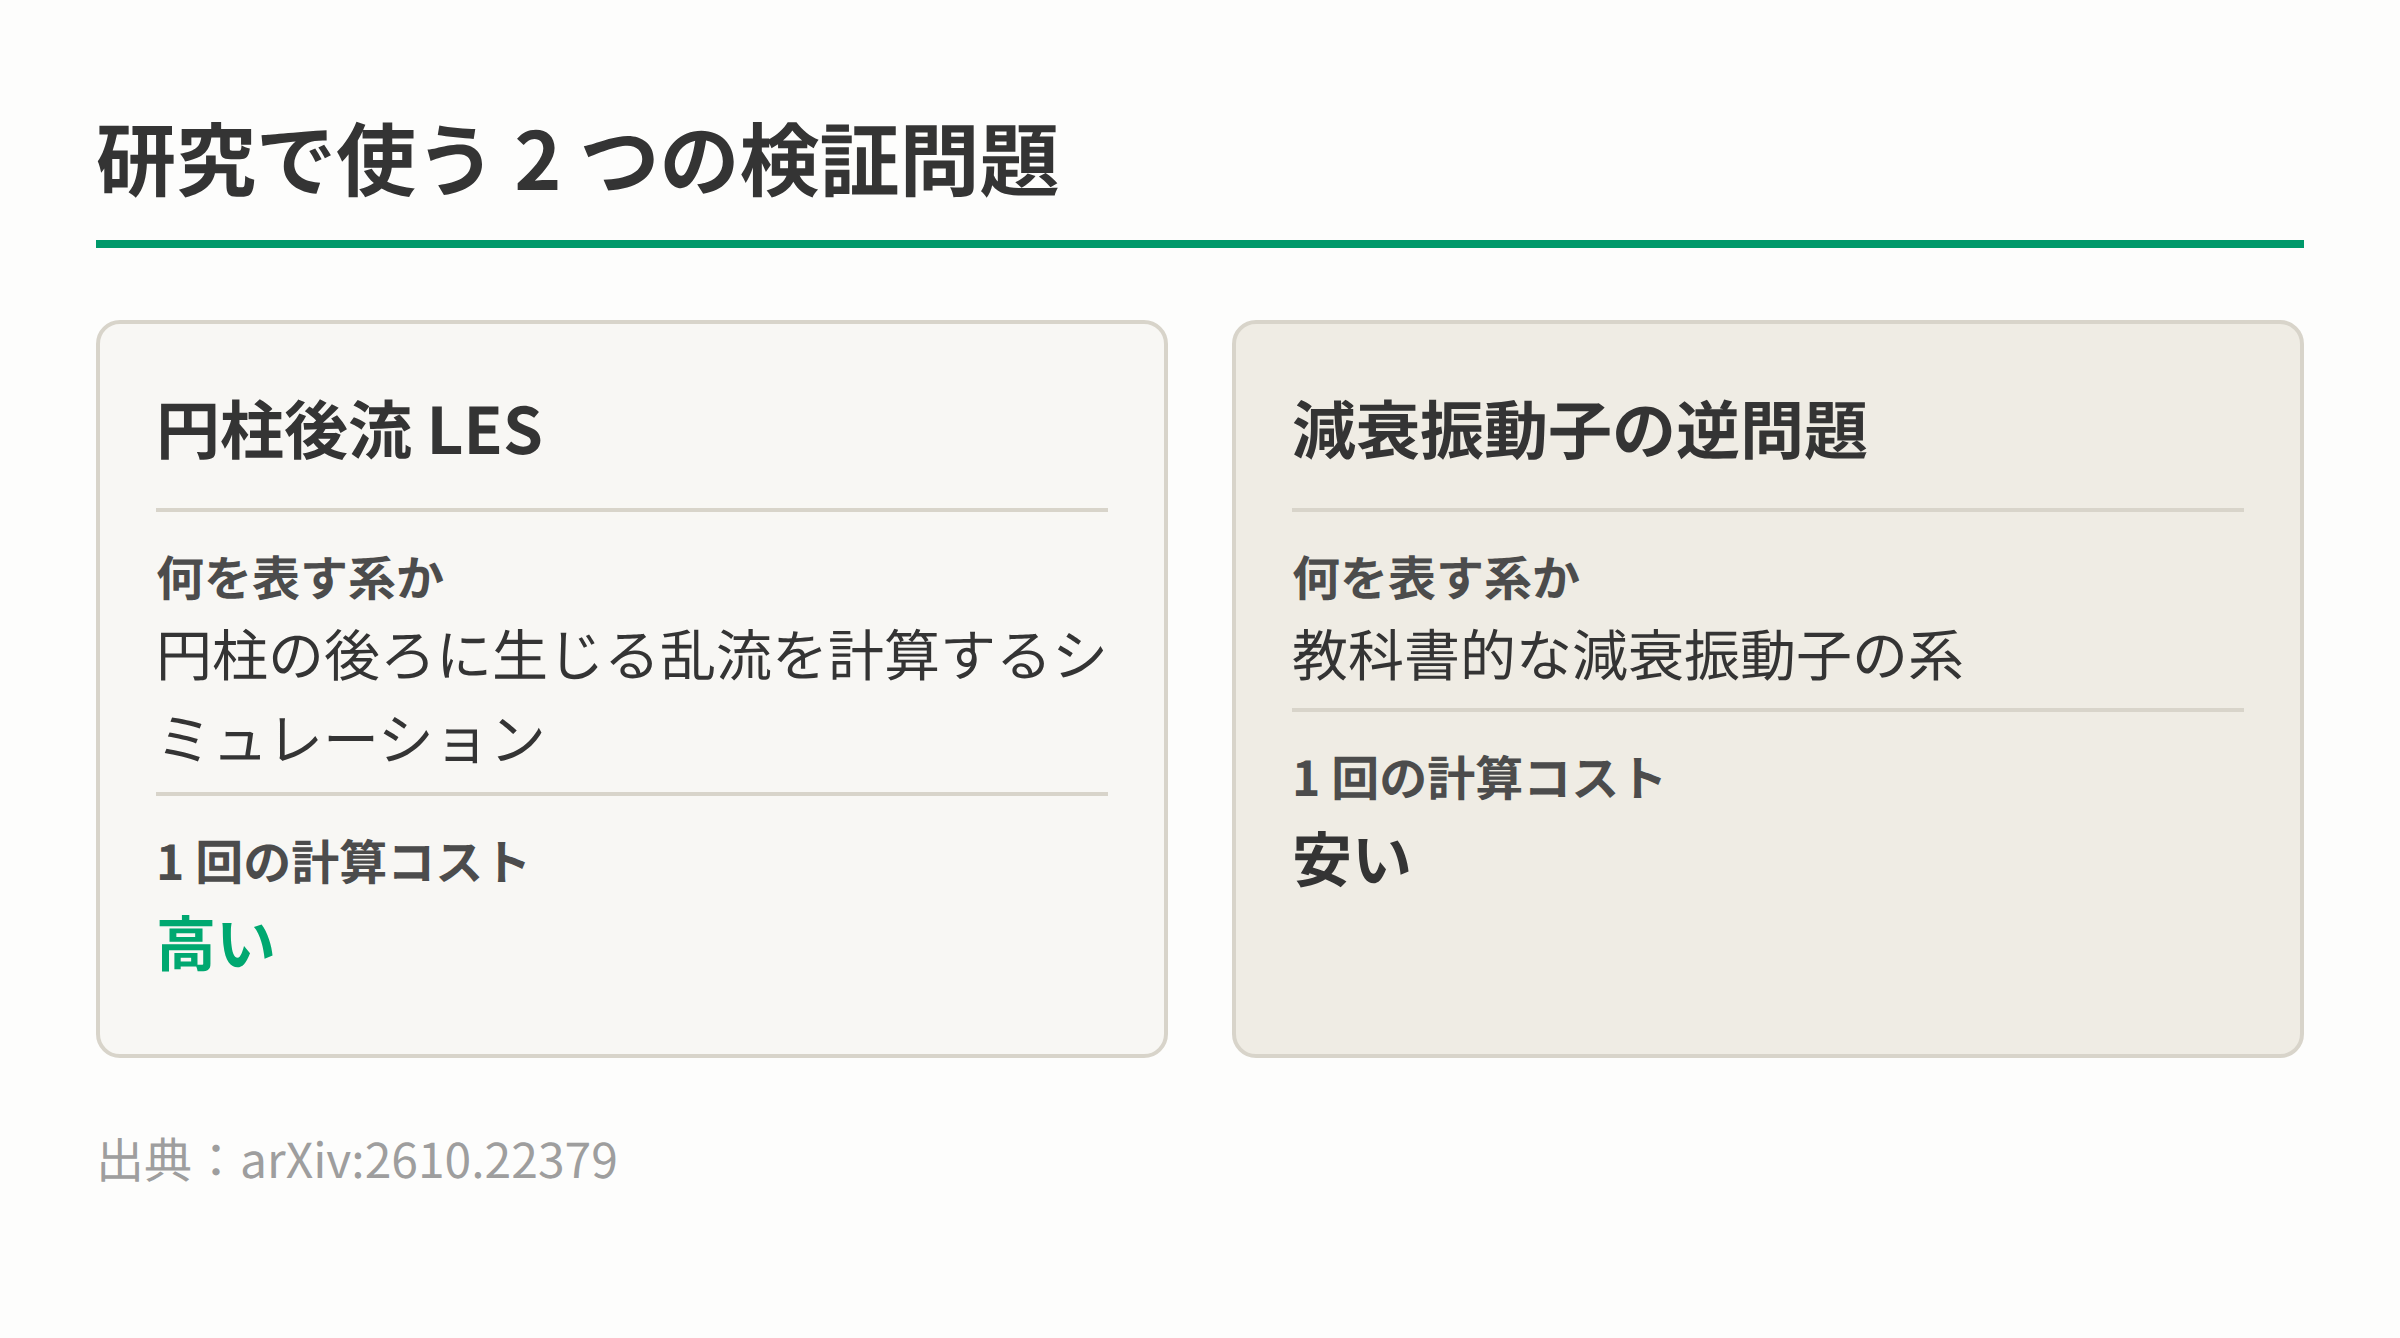
図1:研究で使う 2 つの検証問題の違い(出典:arXiv:2610.22379)
なぜ1回の実行が重いのか
1回の実行に計算クラスターを丸1日使うなら、最終的な精度はもう主な物差しにならない。
使える実行回数は決まっている。大事なのは、回数を使い切る前にどこまで近づけるかだ。
似た問題は、ほかの分野にも出てくる。フローマッチングモデル向けの、学習なしでサンプリング予算を見積もる手法の研究がその1つだ。
この研究が問うのは、高くつく処理を何度も繰り返すときに、どれだけ費やすかである。しかも、無駄な試行錯誤をせずに決めたい。
2つの予算問題の違いを、表にまとめた。
| フローマッチングのサンプリング | シミュレーターの較正 | |
|---|---|---|
| 予算が縛るもの | 1回の評価の深さ | 評価の回数 |
| 選択を誤ったときの損 | 遅い・粗いサンプル | 改善の機会が1つ減る |
| よくある規模 | 安いステップを多数 | 高い実行を数十回 |
較正では、外れた推測1つで、ごく少ないチャンスの1つを使ってしまう。
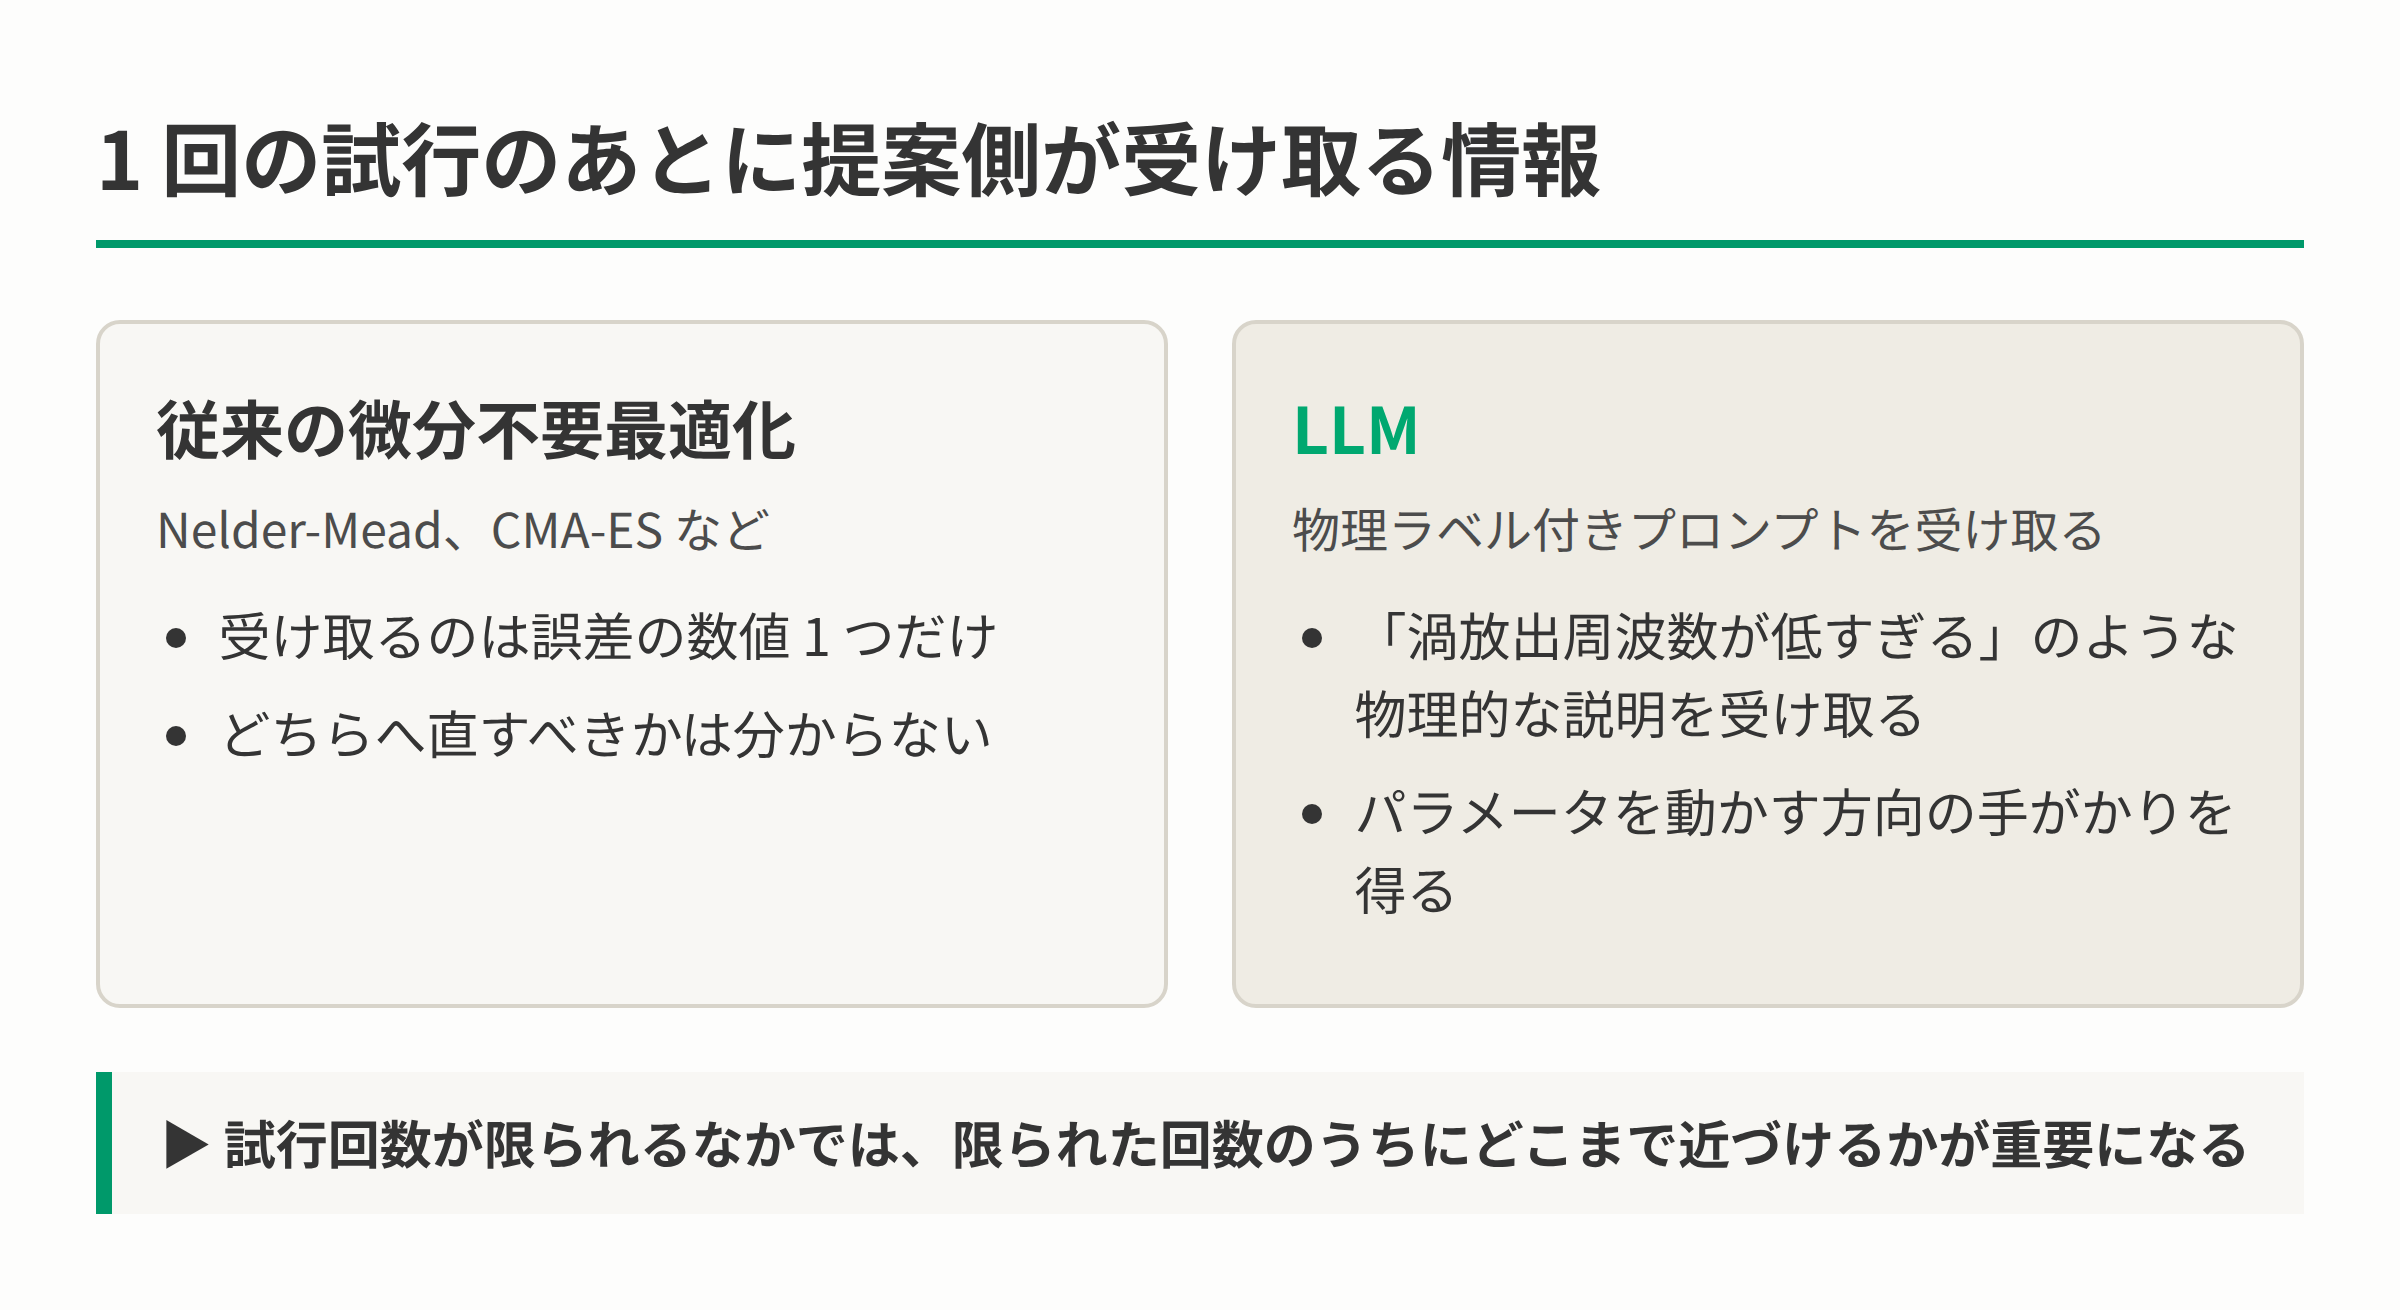
図2:従来の最適化と LLM が受け取る情報の違い
標準的な最適化手法に見えないもの
Nelder-Mead法やCMA-ESのような古典的な手法が見るのは、誤差を表す数字1つだけだ。渦の放出周波数が低いときと、後流が長すぎるときとで、直し方が違うことを知らない。
エンジニアなら、それを知っている。誤差をうまく言葉にして渡せば、言語モデルも知っているかもしれない。この研究は、そこに賭けている。
こうして問いは具体的になる。実行の誤差を物理の言葉で読めるモデルなら、より少ない回数でよく合う状態にたどり着けるのだろうか。
物理ラベル付きプロンプトの中身
この手法は、生のシミュレーション誤差を、モデルが筋道立てて考えられる言葉に変える。
ラベルの1つ1つが、パラメーターをどちらに動かすべきかのヒントになる。数字1つしか見ない最適化手法には、このヒントが届かない。
典型的なプロンプトは、4つの部分でできている。
- 現在のパラメーター値:減衰係数や、サブグリッドモデルの定数など。
- 合っていない量:参照データからずれている出力。
- ずれごとの定性的なラベル:「周波数が低すぎる」「後流が長すぎる」「振動の減衰が遅すぎる」など。
- 履歴:これまでの提案と、その結果。
プロンプトを回す手順は短い。
- 現在のパラメーターでシミュレーターを動かす。
- 出力を参照データと比べ、ずれごとにラベルを付ける。
- ラベル付きの診断と履歴を、モデルに渡す。
- 提案されたパラメーターを確かめ、もう一度動かす。
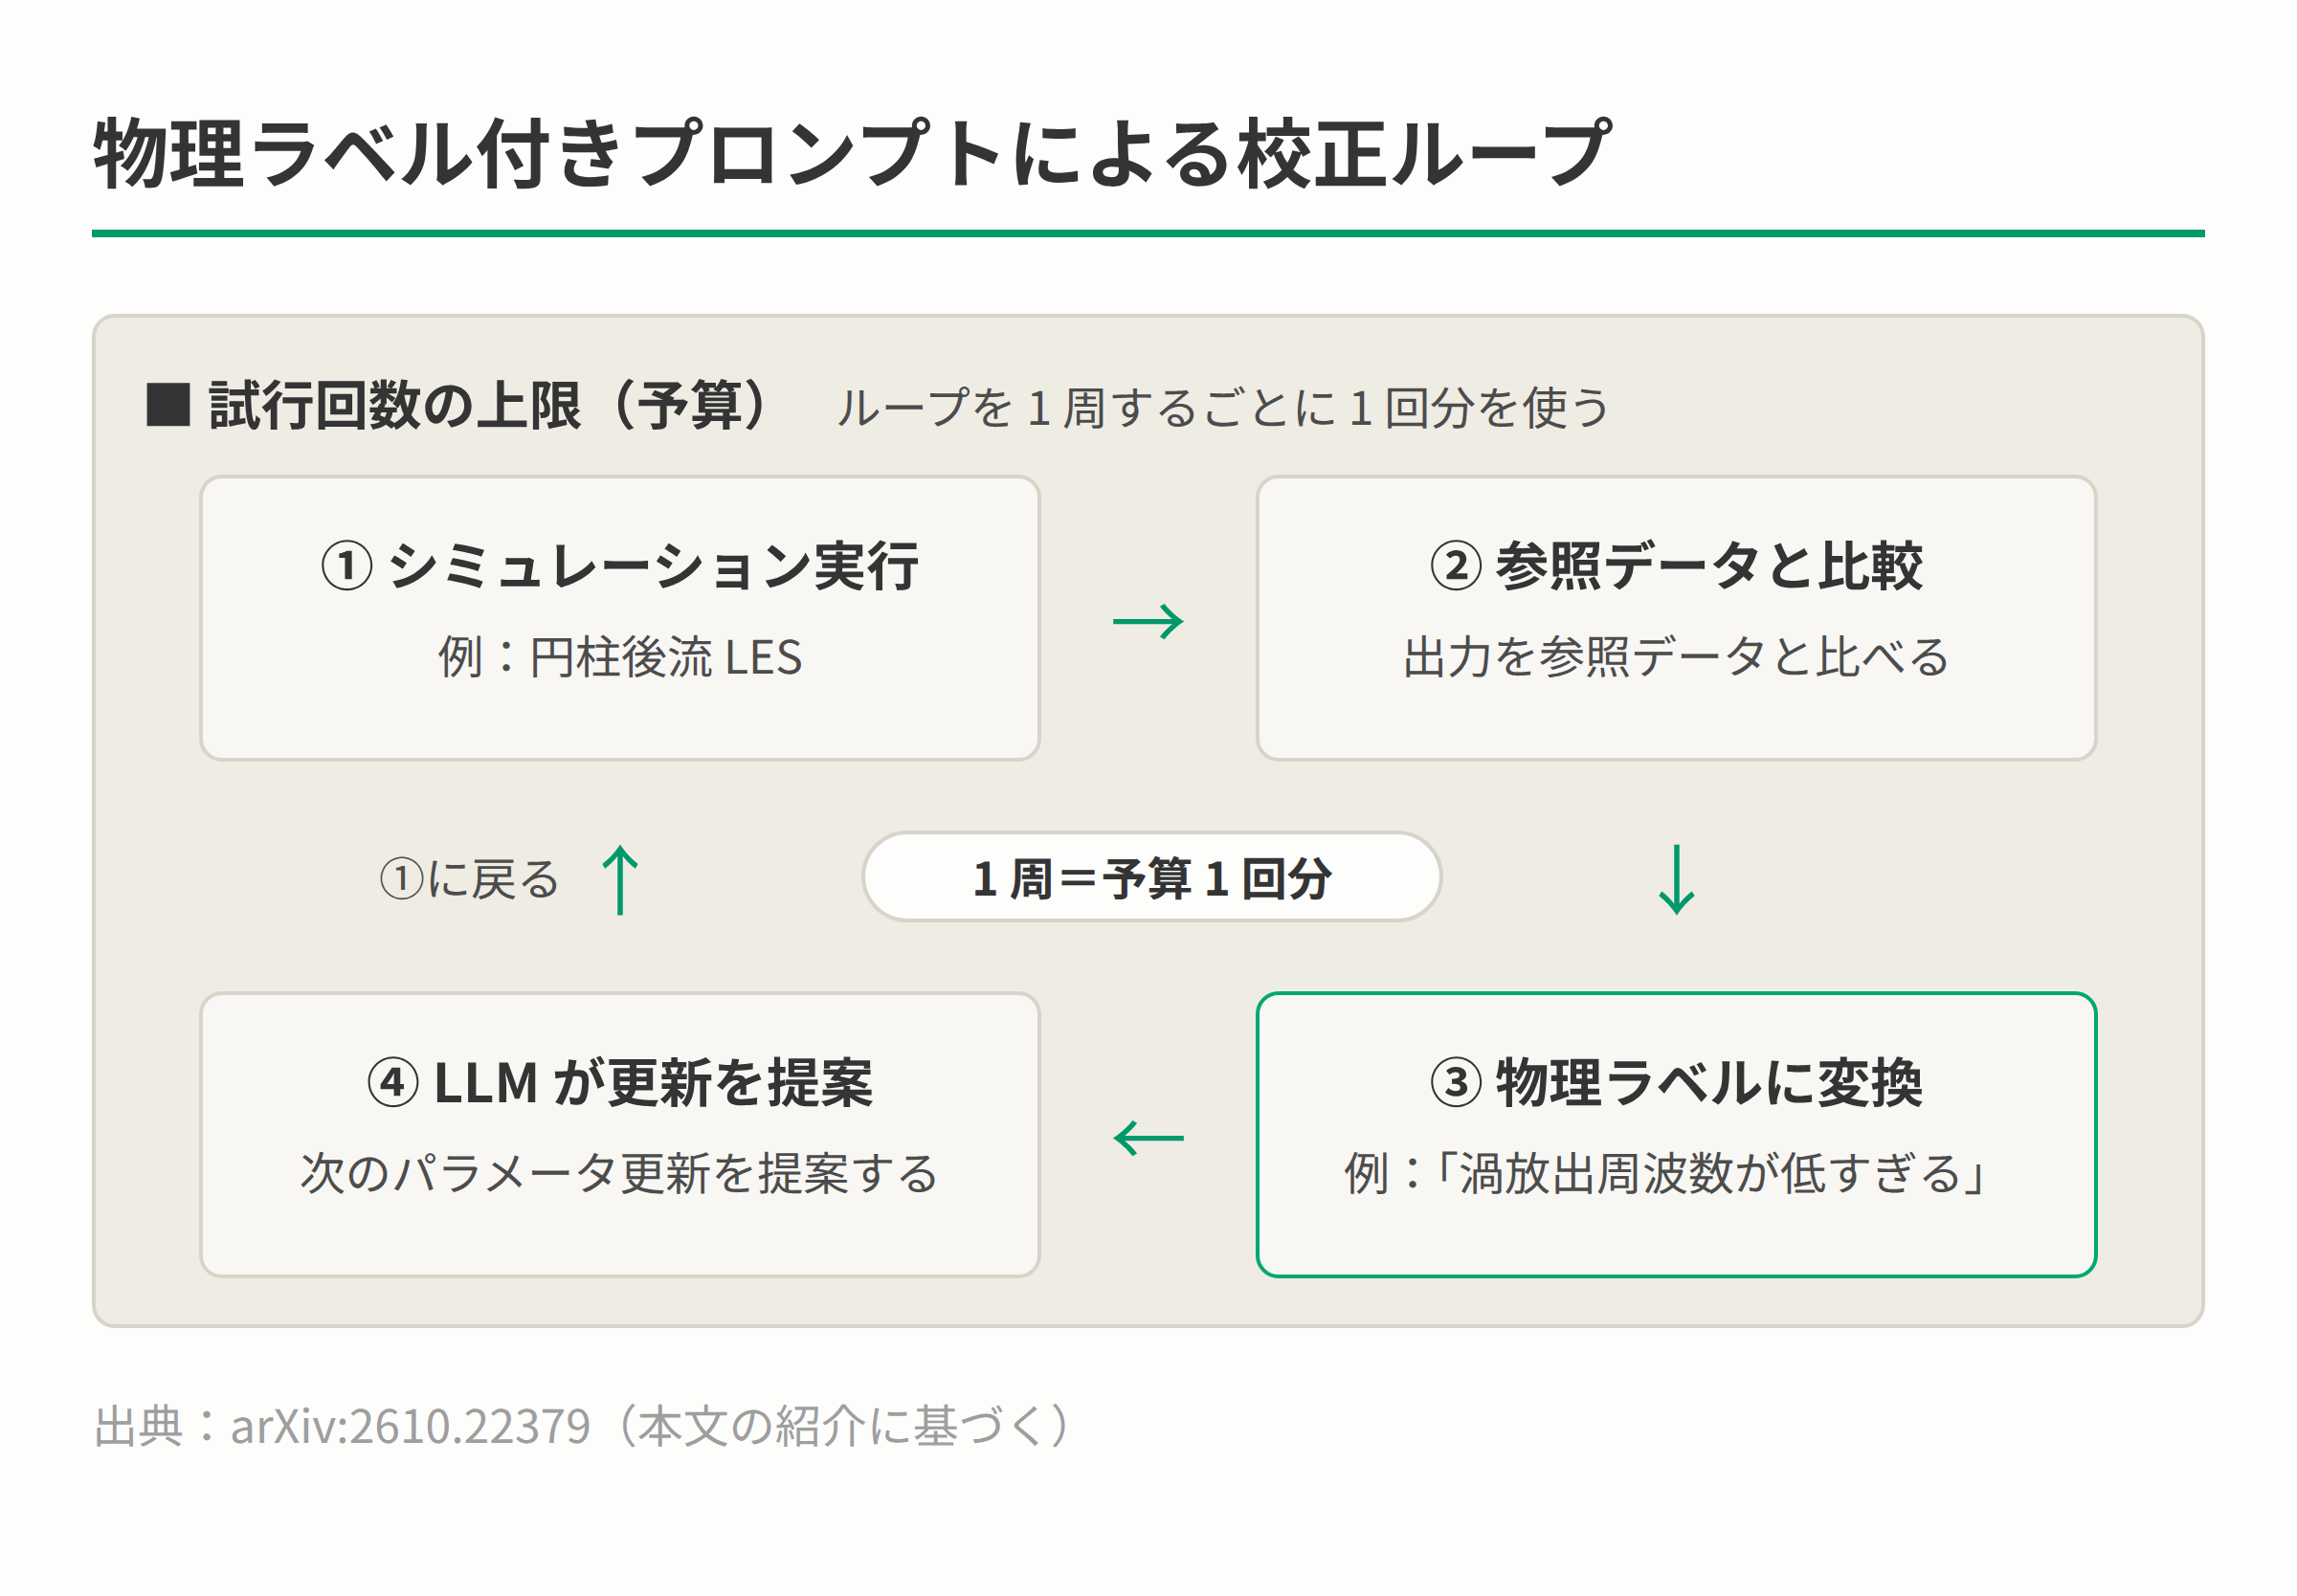
図3:物理ラベル付きプロンプトによる校正ループ(出典:arXiv:2610.22379)
プロンプトの組み立て方が大事な理由
文脈をどう組み立てるかは、それ自体が設計上の選択だ。
エージェントの実行環境(ハーネス)がエネルギーとトークン消費に与える影響を調べた分析がある。そこでは、文脈の組み立て方次第で、資源の使い方がモデル選びと同じくらい変わると分かった。
予算の限られた較正では、組み立ての悪いプロンプトが2通りの形で失敗しうる。
| プロンプトの失敗 | 何を失うか |
|---|---|
| 履歴が膨らむ | トークン代が回ごとに増える |
| 診断が薄い・あいまい | 弱い提案で実行を無駄にする |
痛いのは2つ目のほうだ。LESの1回は、プロンプトのトークンよりはるかに多くの計算資源を使う。
ラベルが示さなければならないこと
ラベルには、まったく違う2つの働き方がある。
1つは、本物の物理の知識を運ぶこと。たとえば、減衰と、振動が収まる速さのあいだの確かな関係がそうだ。
もう1つは、損失の値を言葉で言い直しているだけの場合である。役に立つはずなのは、前者だけだ。
ここから、この考えを試すなら欠かせない3つの比較が出てくる。
- 物理ラベルと損失の値だけ:言葉の説明が、何かを足しているか。
- 物理ラベルと入れ替えたラベル:ラベルの中身が意味を持つか。
- 物理ラベルとわざと間違えたラベル:誤った物理が害になるか。
入れ替えたラベルでも性能が落ちないなら、モデルは一般的な探索をしているだけだ。大きく崩れるなら、物理を使っている。
要旨(アブストラクト)は、これらの比較を報告していない。どちらに当たるのかは、論文本文の結果を見て決めるしかない。
ラベルが本物の物理を運んでいるかを見分ける
ラベルの働きは、2つのうちどちらかだ。本物の物理の知識を運ぶか、誤差の数字を言葉で言い直すだけか。
前者の例は、減衰を強めると系が早く落ち着く、という事実である。役に立つはずなのは、この前者だけだ。 どちらが働いているかは、次の3つの比較で分かる。
- 物理ラベルと、ただの誤差の数字。
- 物理ラベルと、入れ替えたラベル。
- 物理ラベルと、わざと間違えたラベル。
入れ替えたラベルでも結果が保たれるなら、モデルはただ一般的に探しているだけだ。崩れるなら、物理を使っている。
要旨は、これらの比較を報告していない1。答えは、論文本文の結果から出してもらうしかないだろう。
図4:物理ラベルが効く条件
安い問題と難しい問題
この研究は、安い問題と高価な問題を組み合わせている。2つを比べると、それぞれの結果を単独で見るのと同じくらい多くのことが分かる。
2つの題材を並べてみた。
| 減衰振動子 | 円柱後流のLES | |
|---|---|---|
| 1回のコスト | ほぼゼロ | 数時間〜数日 |
| パラメーター | 少ない | 複数が影響し合う |
| ノイズ | なし、または制御済み | 実行ごとにばらつく |
| 物理 | 教科書どおり | 流れの状態で変わる |
振動子:モデルは教科書を思い出せるか
振動子では、硬さ(剛性)・減衰・質量が、周波数と減衰の速さにきれいに対応している。力のある言語モデルなら、すでに知っているはずの内容だ。
その知識がよい推測に変わるのかを問うには、ふさわしい場所だろう。ただ、ここでうまくいっても、モデルが教科書を覚えていると示すだけかもしれない。
後流:本番の試験
後流では、周波数・抗力・後流の長さが、いっせいに反応する。乱流モデルの設定や流入条件、数値計算の選び方も、互いに影響し合う。
ある効果の向きが、流れの状態によって逆になることさえある。
ここでLLMが役に立つなら、ラベルは暗記した公式以上のものを運んでいる可能性が高い。
LESの結果が読みにくい理由
後流の結果を判断しにくくする点が、3つある。
- ノイズ:同じ設定で繰り返しても、結果が変わる。小さな改善は、そのばらつきに埋もれてしまうことがある。
- 実行回数の少なさ:LESを何度も回せる研究はない。そのため、どこまで確信を持てるかにも限りがある。
- 事前に読んでいた可能性:円柱後流は、最もよく記録されてきた流れの1つだ。モデルが学習中に、この設定について読んでいたかもしれない。
どれも、この手法を否定するものではない。ただ、LESで優位が報告されたら、誤差範囲(エラーバー)付きで慎重に読む必要がある。
最適化手法との公平な比べ方
「LLMのほうが効率的だ」という主張の強さは、負かした相手の強さで決まる。比べ方も、すべての手法で同じにそろえる必要がある。
Nelder-Mead法やCMA-ES、ベイズ最適化と公平に比べるには、3つの条件がいる。
- 同じ評価回数の予算を、どの手法にも与える。
- 同じ出発点から始める。
- 多くの乱数シードで試す。LLMの提案には偶然の要素があり、1回の幸運な実行ではほとんど何も証明できない。
物差しも、予算という見方に合わせたい。特に大事なのは次の2つだ。
- 決まった回数の実行のあとに届いた、最良の誤差。
- その誤差が、シードによってどれだけばらつくか。
回数無制限での最終的な精度は、別の問いへの答えになってしまう。
本当の基準がベイズ最適化である理由
ベイズ最適化は、最も手ごわい比較相手だ。少ない予算と高価な評価を前提に作られている。
この手法は、代わりの予測モデル(サロゲート、ふつうはガウス過程)を使う。サロゲートは、データから応答の形を学んでいく。ただし、物理の知識はゼロから始まる。
序盤でLLMがこれを上回るなら、いちばんありそうな理由はこうだ。サロゲートなら実行を重ねて学ぶしかない部分を、物理の事前知識が先に補っている。
Nelder-Mead法に勝つだけなら、ずっと弱い結果である。
どの相手に勝てば何が言えそうかを、表にまとめた。
| LLMが上回った相手 | 言えそうなこと |
|---|---|
| ベイズ最適化 | 序盤は物理の知識がデータ頼みの予測に勝る |
| CMA-ESだけ | 方向づけは有用、少予算での強みは未証明 |
| Nelder-Mead法だけ | 単純な局所探索とあまり変わらない |
トークン代と、1回の提案にかかる時間も勘定に入れたい。LESの1回と比べれば、ごくわずかだ。
でも、振動子の計算1回と比べるとそうはいかない。安い問題では、LLMにかかる手間が、節約した分を打ち消すかもしれない。
言語モデルが向かない場面
範囲が狭く、はっきり定義された判断には、LLMより手作りの小さな判断モデルのほうが向くことが多い。シミュレーターの較正は、これに当てはまる。
パラメーターは少なく、目的もやめどきもはっきりしている。この議論が正しいなら、LLMの強みは状況次第ということになる。
ここまでの筋道からすると、強みが出るのは次のようなときだ。
- 予算がとても厳しい。
- 診断が、どちらへ動かすかという物理的な意味を持っている。
- 専門家ならその意味をルールに書けるのに、まだ誰も書いていない。
逆に、次のようなときは強みが薄れるはずである。
- サロゲートが応答の形を学べるだけの実行回数がある。
- エンジニアが、感度をすでにルールとして書き出している。
こうした場合は、従来の最適化手法やルールの集まりが、LLMと同等かそれ以上の結果を出すはずだ。コストも安く、何度動かしても同じ答えを返す。
具体的なつまずき方
起こりそうな失敗は、はっきりしている。
- 物理の当てはめすぎ:教科書の関係がこの流れの状態では成り立たないのに、自信満々でパラメーターを逆向きに動かす。
- 最初の案へのこだわり(アンカリング):序盤の提案に固執し、探索をやめてしまう。
- 制約違反:実行環境が範囲を強制しないと、物理的にありえない値を出す。
- 矛盾の見逃し:2つの診断が正反対の変更を求めていても、気づかない。
現実的な答えは、仕事を分けることだ。LLMは序盤の提案役を務め、物理の勘を使って素早く近づく。そのあとを、体系的な最適化手法が仕上げる。
こう見ると、手作りのモデルとLLMエージェントは競い合う関係にない。
LLMが受け持つのは、まだ誰もルールを書いておらず、サロゲートに必要なデータも足りない区間だ。どちらかの穴が埋まれば、LLMの出番は減っていく。
LLM較正エージェントを実際に使うなら
LLMの較正エージェントを検討しているエンジニアなら、ここまでの筋道から5つの進め方が導ける。どれも、要旨で報告された結果から来たものではない。
- 向きと仕組みを伝える診断:「減衰が遅すぎる」のほうが「誤差0.3」より、モデルが使える材料が多い。役立つラベルは、量の名前とずれた向き、分かれば物理的な理由も示す。
- 高価な実行の前に、安い代わりの問題で試す:速く解ける問題で本物のラベルと入れ替えたラベルを比べれば、ラベルが意味を持つかが分かる。入れ替えても悪くならないなら、ラベルは働いていない。
- 範囲の制限はプロンプトでなくコードで:実行環境の側で、範囲外の提案を切り詰めたり退けたりできる。プロンプトはお願いにすぎず、コードのチェックは保証になる。
- 短い履歴と、計画した引き継ぎ:過去の回を要約すれば、トークン代は増えずにすむ。序盤の改善が頭打ちになったら、ベイズ最適化かCMA-ESに切り替えて仕上げを任せる。
- 複数のシードで試し、ばらつきも報告する:これはエージェントを、探索に物理の知識を安く足す道具として扱うことにあたる。最適化全般の代わりになるものではない。
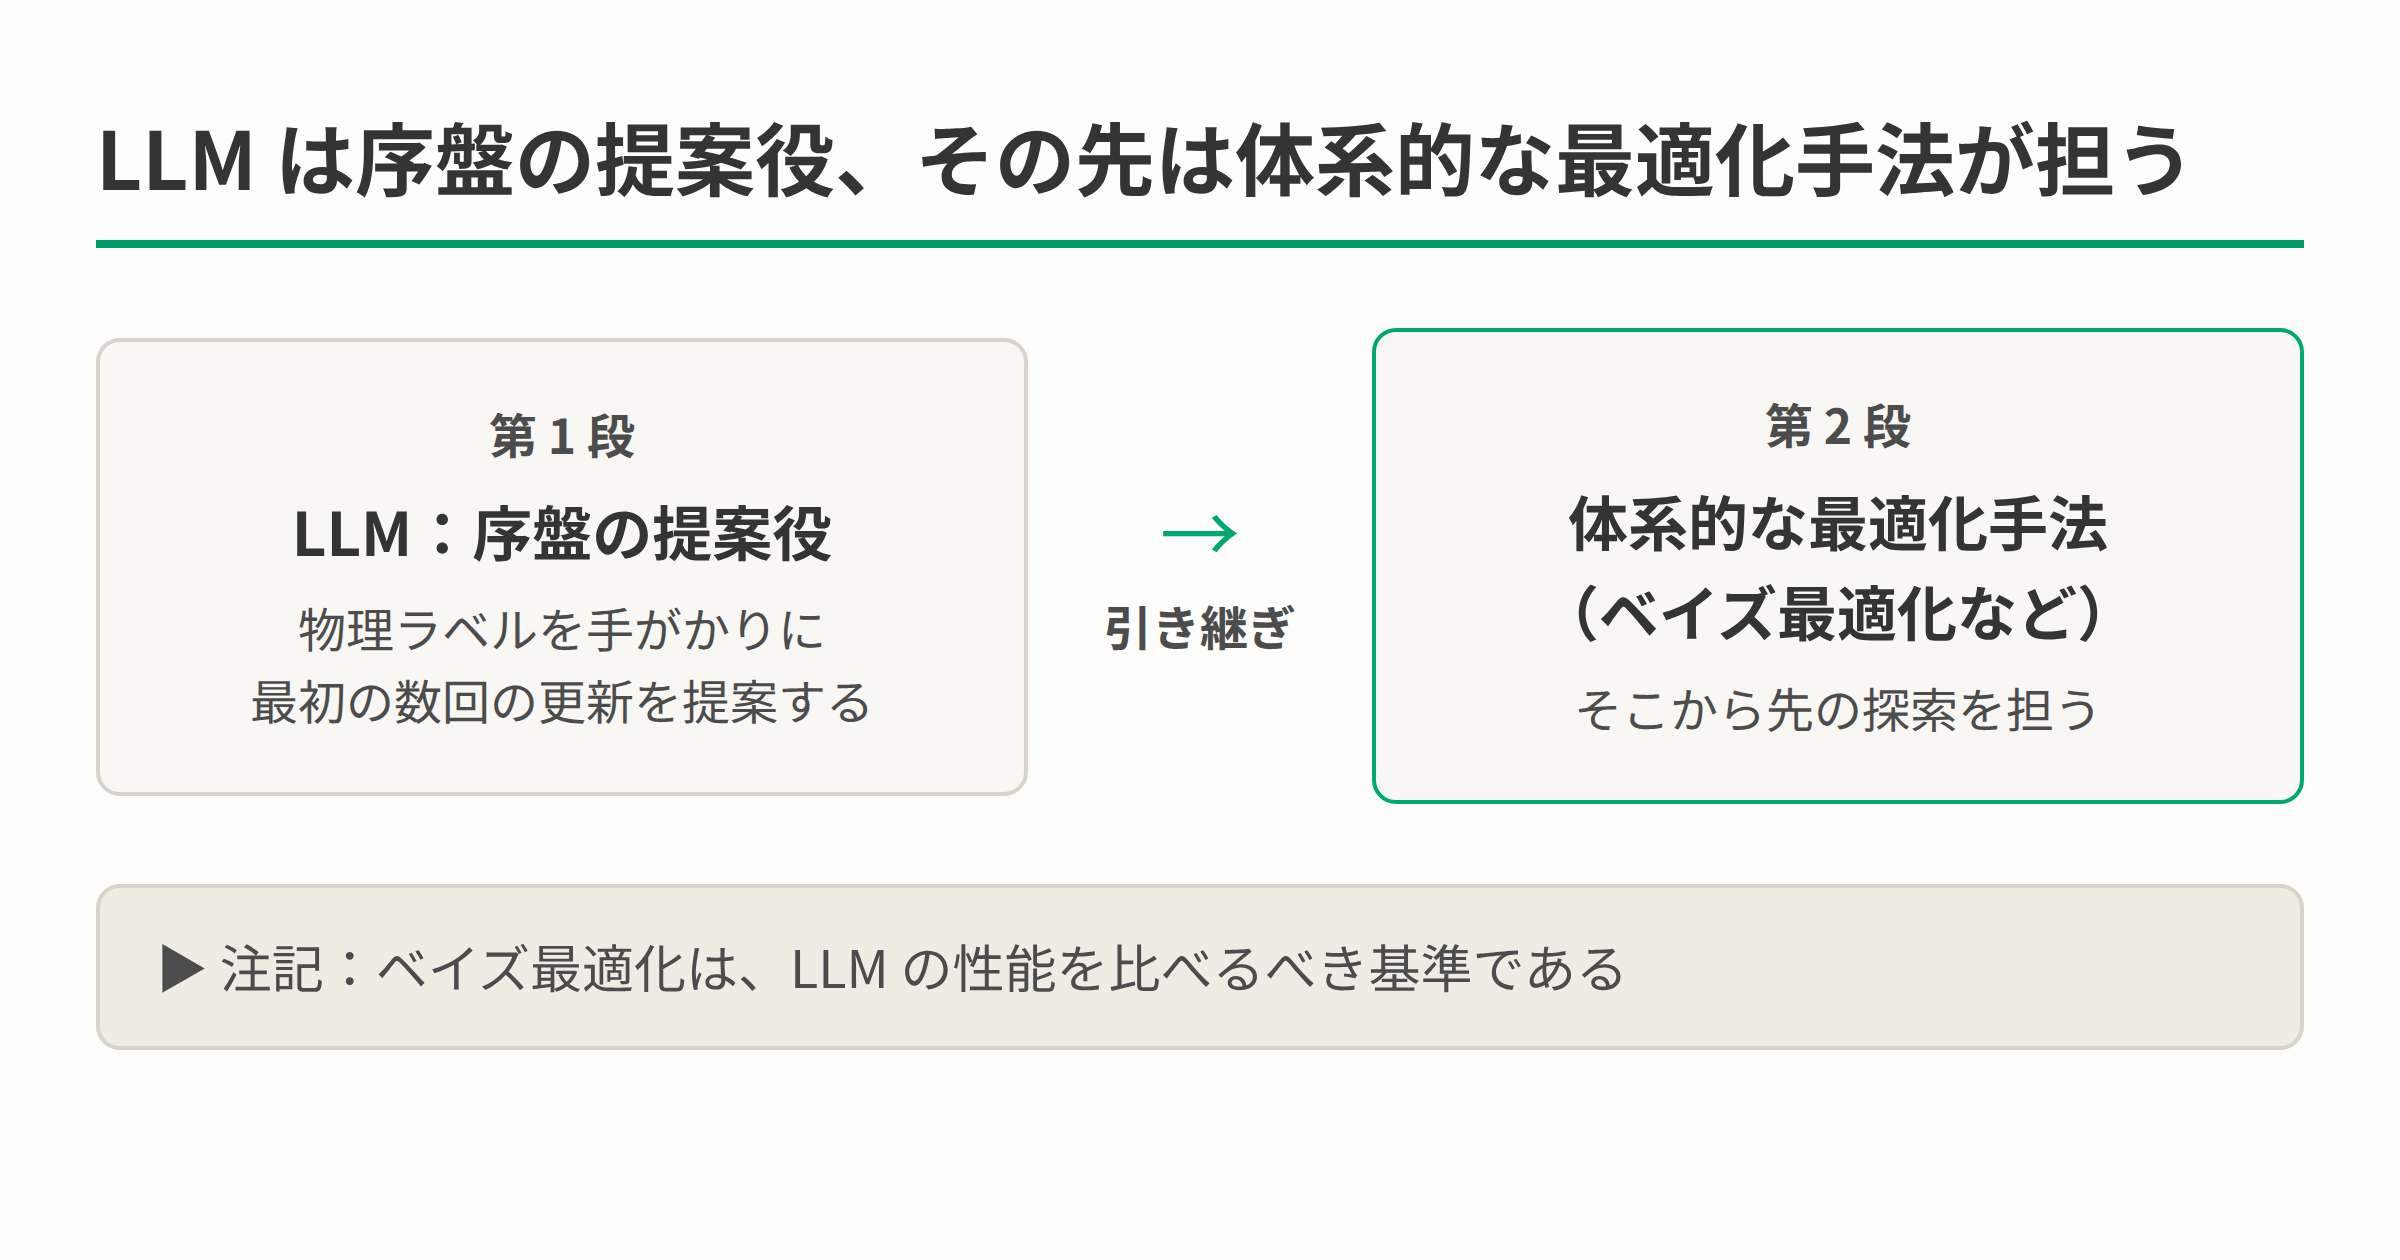
図5:LLM を序盤に使いベイズ最適化へ引き継ぐ構成
ちょっと立ち止まって
この手法の魅力は、エンジニアがふだんやっていることをプロンプトに移した点にある。失敗した実行を見て、どこがおかしいかを言葉にし、どのつまみを回すか見当をつける。
これがうまくいくなら、較正で高くつく部分は「探すこと」から「診断すること」へ移る。
そこで、研究の要旨が答えていない問いが浮かぶ。エージェントを役立たせているのが物理ラベルで、それを書くのが専門家だとしたら、成果のどれだけが言語モデルのものなのだろうか。
そして、あなた自身の仕事ではどうだろう。ある道具が賢く見えるとき、その賢さのどれだけが、誰かが問題をどう説明したかから来ているのだろうか。
脚注
-
“When is a large language model a good calibration agent? Physics-labeled prompting for budgeted engineering simulator calibration,” arXiv, https://arxiv.org/abs/2610.22379 ↩ ↩2 ↩3 ↩4